课程视频
工具怎样扩展语言模型
本文对应官方第 2 讲,由 Graham Neubig 于 2026-08-27 授课。下面按照视频中的“工具能力—代码组合—调用机制—约束解码—REST 与 MCP—并发与评测”顺序整理,图示取自官方课件。
语言模型本身根据上下文预测 token。工具是模型调用外部计算机程序的接口:模型提出调用,外部软件决定是否执行以及怎样执行。搜索、计算器、浏览器、Python 和业务 API 都可以作为工具,但它们作用于环境的方式并不相同。
课程将收益分成两类:Extend 让模型获得参数中没有的最新信息、用户私有数据或改变环境的能力;Facilitate 将模型理论上也能完成的工作交给更合适的程序。例如,多位数乘法可以让模型逐步推理,也可以直接交给计算器,后者通常更快、更可靠。一次调用还会带来延迟、费用和失败可能性,应结合任务选择。
从 ChatGPT 的功能反推接口
Graham 先让学生列举 ChatGPT 能做的事情,再把它们对应到接口:
| 能力 | 课件中的接口 | 执行后得到什么 |
|---|---|---|
| 返回答案 | finish(text) | 结束本次执行循环的文本 |
| 获取新资料 | search_web(query) | 搜索结果 |
| 精确计算 | execute_code(code) | 程序运行输出 |
| 生成图片 | generate_image(query) | 图片资源 |
| 操作业务应用 | create_grocery_cart(items) | 购物车及金额 |
这里的 finish 是 Harness 的控制动作,不调用外部程序。另一种实现是在模型没有请求工具时直接结束循环。课堂还讨论了检索增强生成(RAG):检索再生成已经成为常见交互的一部分,工具循环使检索发生在需要它的步骤。
图片生成也体现了模型的中介作用。用户输入的简短要求,可能先被模型扩展成更详细的图像描述,再发送给生成接口;工具参数并不一定逐字复制用户原文。
代码作为元工具
介绍常见接口之后,课程转向 programmatic tool calling。代码能用变量、循环和函数组合其他工具,因此可看作一种元工具(meta-tool)。
课件先用面包数量的计算说明:一段代码中的赋值和减法,如果全部改成独立工具,每一步都需要单独表达。随后 CodeAct 的例子要求比较美国、日本、德国和印度购买同一手机的价格。逐次调用汇率、价格和税费接口会产生很多轮交互;写成程序后,可以在一个动作里遍历国家、调用接口、转换货币并比较总价。
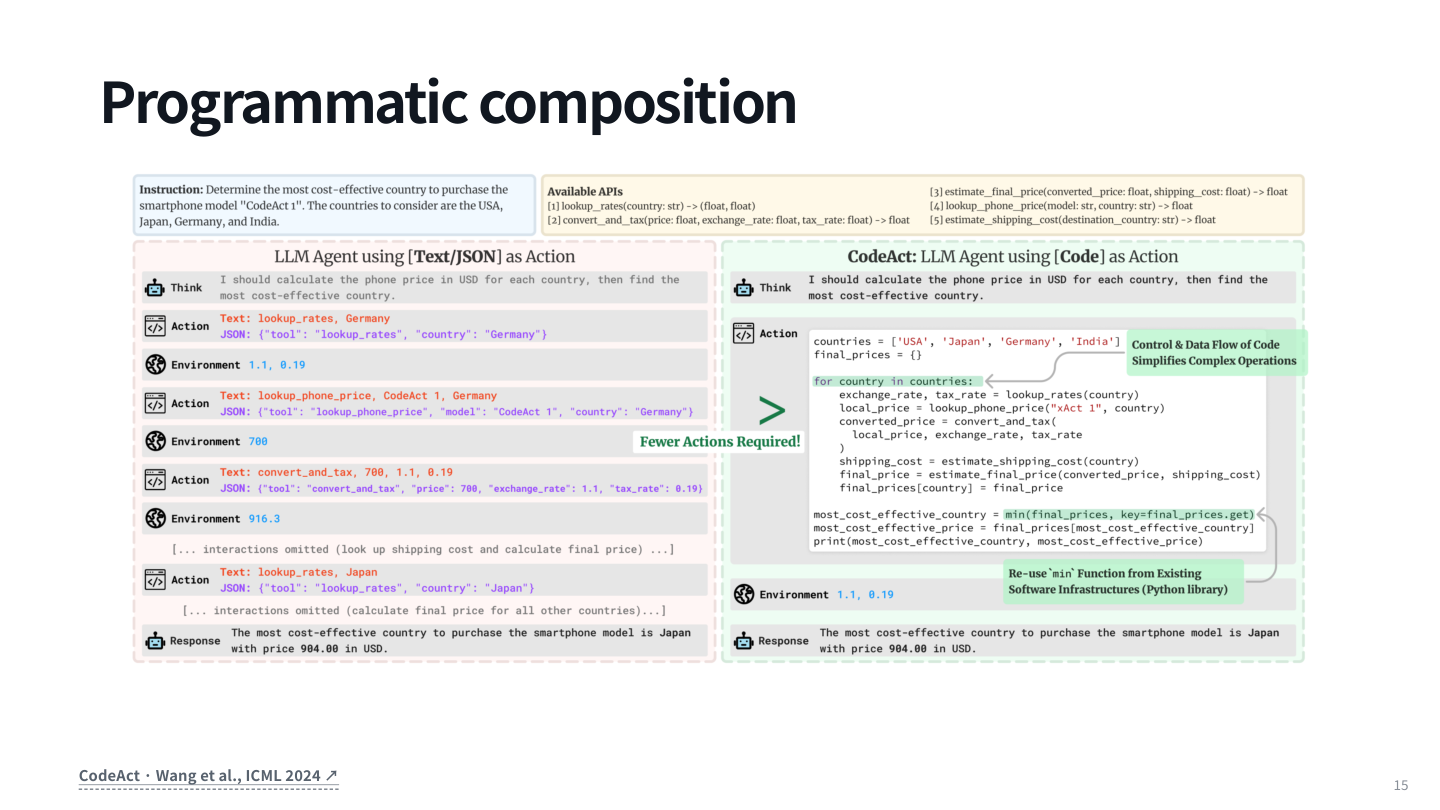
课件展示的子集中,代码动作在 8 个模型上均取得最高成功率,其中 7 个模型使用的轮数最少;完整 17 个模型中,两项统计分别都是 12 个。这里比较的是论文中的特定任务与设置,不能推成任意任务上代码都最好。
表达能力也带来约束难度。课堂讨论了无限循环、依赖版本、被污染的第三方库,以及文件、网络、CPU 和内存访问的影响。窄函数接口便于检查参数;任意代码的行为需要结合沙箱、资源限制、权限和日志来控制。
模型生成调用,Harness 执行调用
消息与工具定义进入同一个输入序列
工具调用仍然由 token 表达。API 中的 system、user、assistant 等消息先通过聊天模板(chat template)序列化,再交给模型。工具名称、说明和参数 Schema 也会进入模型输入。模型可以在一次生成中给出推理、面向用户的文字和工具请求。
课件以 get_weather(city) 为例:输入包含工具定义,输出表达工具名和 city="Pittsburgh"。API 层随后为调用关联 ID。不同模型的底层表达并不一样:课件并列展示 Qwen 的函数与参数标签、Mistral 的控制 token 和调用 ID,以及 DeepSeek 的 DSML 块。接入时需要匹配相应模板和解析器。
课堂问答补充:这些特殊 token 不一定在互联网预训练阶段就已引入,也可能在后续中期训练中加入,再通过后训练学习使用。
注册、分发与结果关联
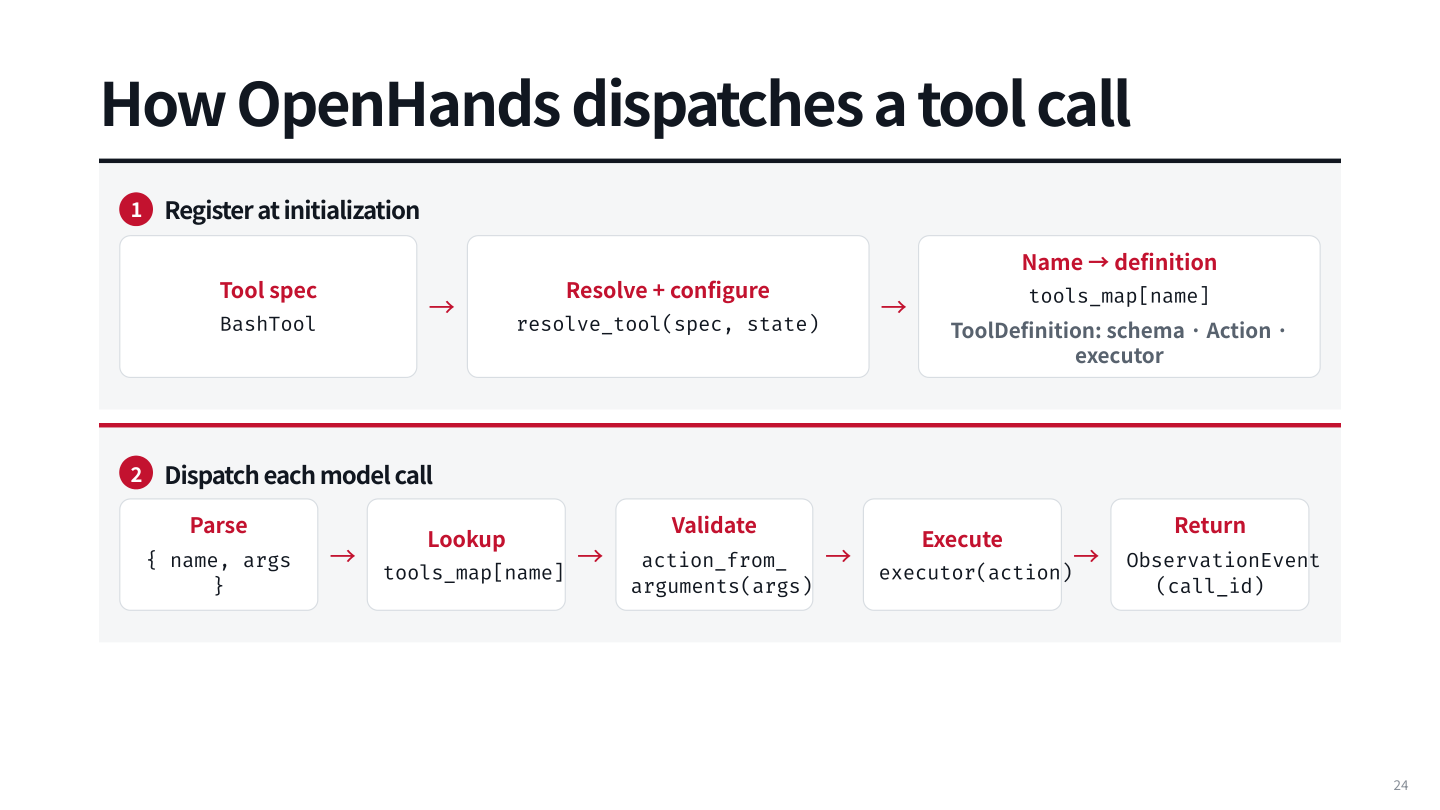
OpenHands 的示意图分成两个阶段。初始化时,resolve_tool(spec, state) 把工具声明连接到当前环境,建立 tools_map[name],保存 Schema、Action 和 executor。运行时先解析名称与参数,查找工具定义,用 action_from_arguments(args) 校验并构造 Action,再执行并返回 Observation。
call_id 把结果与原调用对应起来。例如请求 call_123,工具结果就携带 tool_call_id="call_123"。并发执行时,完成顺序可能不同,仍要保持这种关联。模型获得工具返回的观察后,才能继续判断下一步。
约束解码怎样保证调用格式
普通生成可能少一个右括号,使 Harness 无法解析。JSON Schema 可以规定类型、必需字段、枚举值和是否允许额外属性。例如 units 只接受 C 或 F,那么 K 即使是合法 JSON 字符串,也不满足这份 Schema。
课程接着从语法讲到下推自动机(pushdown automaton,PDA)。有限状态记录当前处于语法规则的什么位置,栈记录嵌套对象或数组应该返回哪里。只有状态而没有栈,难以处理任意深度的嵌套。
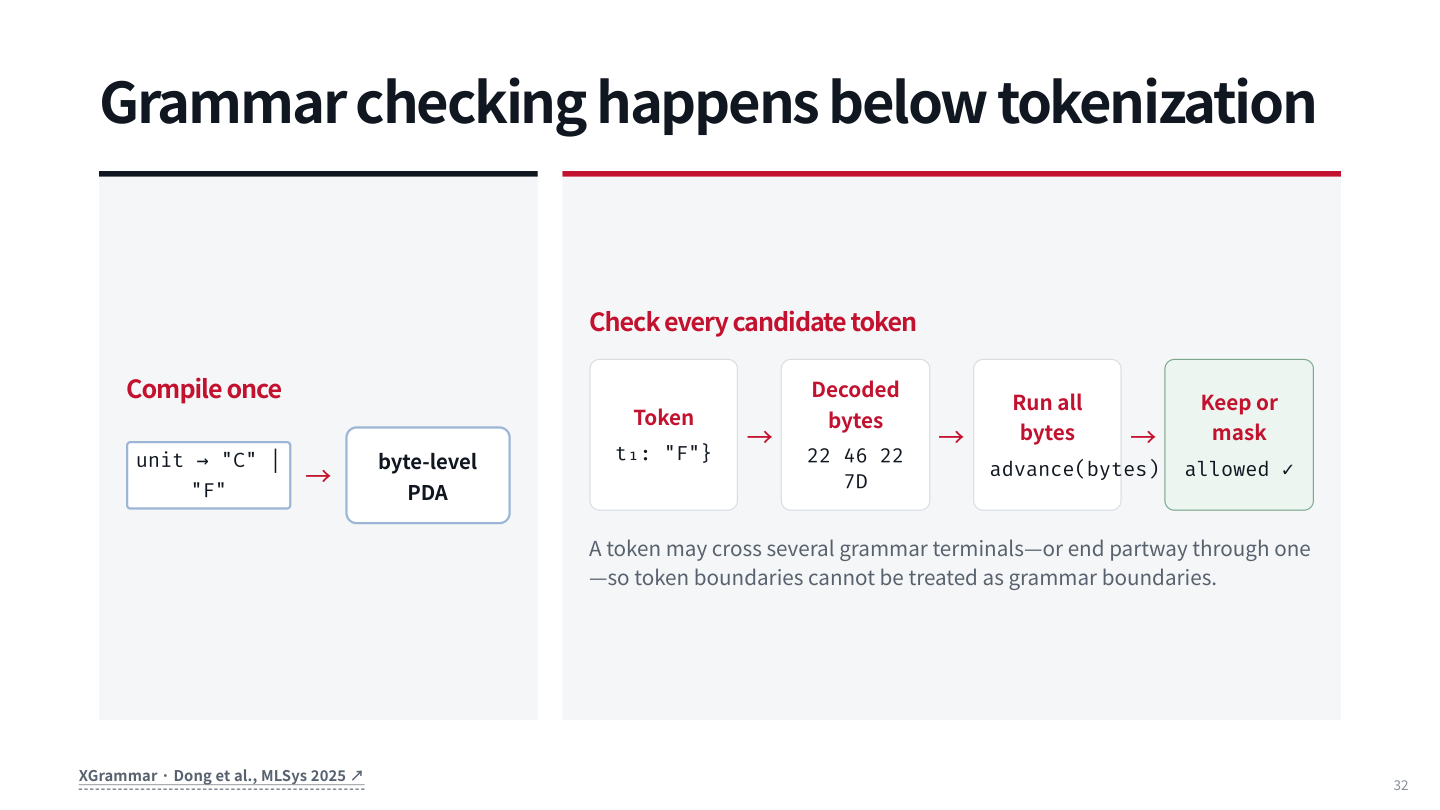
这里有一个容易忽略的细节:token 边界和语法终结符边界不同。一个 token 可能包含字符串末尾和右括号,也可能只覆盖某个字符串的一部分。因此,XGrammar 将候选 token 解码为字节,再判断这些字节能否使当前自动机继续走在合法路径上。
每次模型输出 logits 后,解码器把不合法候选置为负无穷,再在合法集合中采样。XGrammar 会缓存与上下文无关的判断,对少量依赖当前栈的候选现场检查;持久化栈和 CPU/GPU 重叠计算减少了约束带来的开销。
课堂特意问:这样是否一定能得到完整合法的 JSON?如果生成达到最大 token 数时,自动机尚未到达接受状态,输出仍可能被截断。约束解码保证生成路径的形式约束,还需要处理输出上限。即便格式合法,也没有保证城市正确、调用获得授权或者任务已经完成。
从库函数到 REST API,再到 MCP
本地接口与远程接口
Python 库中的 get_weather(city, units) 是进程内调用。要让远端客户端使用,还需要地址、协议、序列化和认证。课件使用 FastAPI 把函数映射到 GET /weather:城市和单位位于查询参数,API Key 位于请求头,返回对象序列化成 JSON。
OpenAPI 描述 HTTP 方法、路径、参数位置和安全方案,其中嵌入的 JSON Schema 描述参数及返回值。两者层次不同。拥有 shell 的编程智能体也可以读取接口文档,然后用 curl 直接请求 REST API。
MCP 的发现机制与凭证代理
MCP(Model Context Protocol)为 AI 应用提供另一种能力接口。Host 管理客户端,客户端连接本地标准输入输出服务器或远程 HTTP 服务器;tools/list 用于发现工具,tools/call 用于调用。它还可以提供 resources、prompts 等能力。
Graham 解释,自己最初也会问:“既然能调用 REST,为什么还需要一层服务器?”课堂重点讨论的收益是凭证隔离。MCP 服务器可以保存上游 GitHub Token,智能体进程只持有访问 MCP 的凭证。模型不必直接获得上游密钥,服务器还能限制可访问的功能。
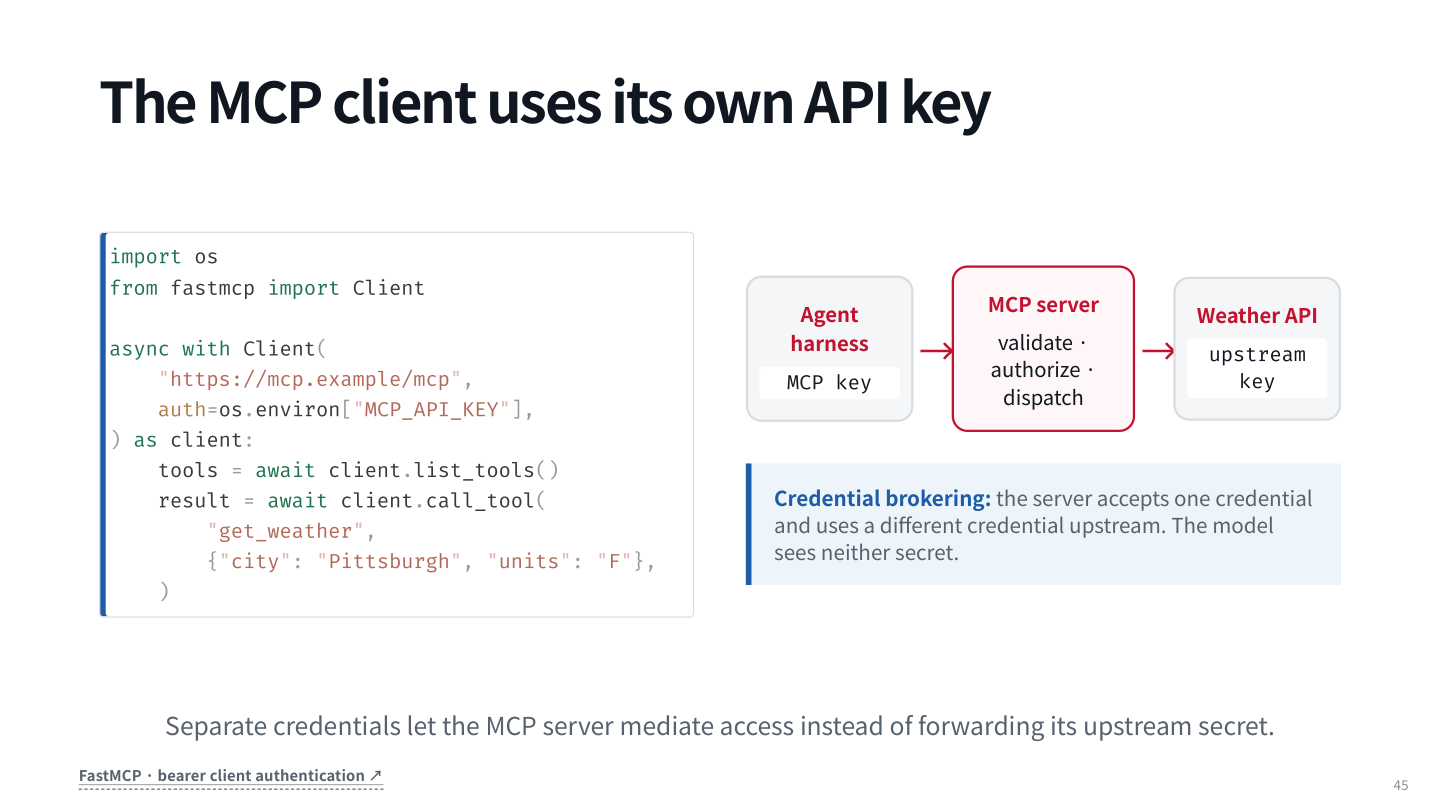
这种隔离取决于具体部署,并非使用 MCP 后自动安全。MCP 凭证泄露也需要撤销和处置;两套凭证及服务器权限应分别管理。课件中的静态 Token 用于教学或开发,生产部署需采用合适的验证和授权方式。
| 项目 | OpenAPI / HTTP API | MCP |
|---|---|---|
| 能力发现 | 获取 OpenAPI 文档 | 运行时 tools/list |
| 调用方式 | HTTP 方法、路径及参数 | MCP transport 上的 tools/call |
| 身份认证 | 客户端向 API 认证 | 客户端向 MCP 认证,上游认证另行处理 |
| 共同点 | 名称、说明、结构化输入 | 名称、说明、结构化输入 |
FastMCP 可以把 OpenAPI 路由投影成可发现的工具。课堂还补充了 MCP Registry,帮助查找现成服务器。选择直接 REST 或 MCP,需要结合宿主能力、发现机制和凭证管理方式。
独立调用怎样并行
顺序执行天气、日历和航班查询,需要反复生成和等待。课件假设每次模型生成耗时 0.8s,三个工具分别为 1.2s、0.9s 和 1.1s,串行总计约 6.4s;一次生成三个请求、并发执行后再生成答案,则约为:
1 | 2 × 0.8 + max(1.2, 0.9, 1.1) = 2.8 秒 |
只有相互独立且可安全并发的操作才能这样处理。“先查客户 ID,再查订单,再退款”存在依赖,必须顺序执行。运行层可用 asyncio.gather 等机制等待多个结果,同时保留调用 ID 和各自的失败信息。
老师还指出,较高单价的模型未必有更高的单任务成本:更好的方案选择和更少的串行轮次可能抵消价格差异。课堂将近来并发调用能力的提升,与训练中对完成速度和执行长度的激励联系起来;判断经济性时仍要实际测量整个任务。
工具使用应该怎样评测
课程最后介绍 Berkeley Function Calling Leaderboard。它从单轮调用扩展到多轮、缺失函数或参数、长上下文、搜索、记忆及格式鲁棒性。需要区分以下层次:
| 层次 | 要检查的问题 | 典型失败 |
|---|---|---|
| 工具选择 | 是否选对、是否多调或漏调 | 使用无法完成任务的接口 |
| 参数 | 字段、类型和值是否正确 | 城市或单位错误 |
| 轨迹 | 次序和依赖是否正确 | 尚未查到 ID 就使用 ID |
| 任务 | 环境中是否真正完成目标 | 调用均合法,最终结果仍错误 |
此外还要测量调用数、token、延迟和费用,以及超时、限流、部分失败和错误恢复。工具选择准确率不能覆盖这些运行问题。
课末的 OpenRouter 图表展示同一个模型在不同提供商上的工具调用错误率差异。课堂讨论了量化精度、约束解码实现、服务稳定性等可能原因;这些是对差异的解释方向,图中的某个错误率不能单独证明是哪一个因素造成。选择模型服务时,应把模型、推理实现和 Harness 一起评估。