用工作流规定一部分行为
本页对应官方第 15 讲 Orchestration and Monitoring,由 Daniel Fried 于 2026-10-20 授课。原页面以 LangGraph 命名,本文保留链接,按当前官方主题整理。截至 2026-11-08,已核对官方课件,用户提供的 14 集收藏中尚无本讲视频;以下记录课件内容,课堂演示的口头补充留待录像核对。
技能、规划、任务分解和 automation 都在模型行动之外增加结构。编排框架进一步允许开发者提前规定部分流程,把分类、生成或调查等判断交给模型,将确定步骤交给代码。
单 agent 由模型在行动—观察循环中决定下一步;显式工作流则把分类、检索、调查、检查等步骤连接起来。两者都可以包含模型、工具和普通代码,区别在于多少行为由开发者预先指定。
客服邮件怎样经过 LangGraph
课件用两类请求贯穿示例:密码重置通常可以检索说明、起草回复并发送;重复扣费需要员工审查后再发送。工作流先读邮件、分类,再根据结果进入文档搜索、建 bug ticket 或起草回复,特定类别和紧急程度触发人工审查。
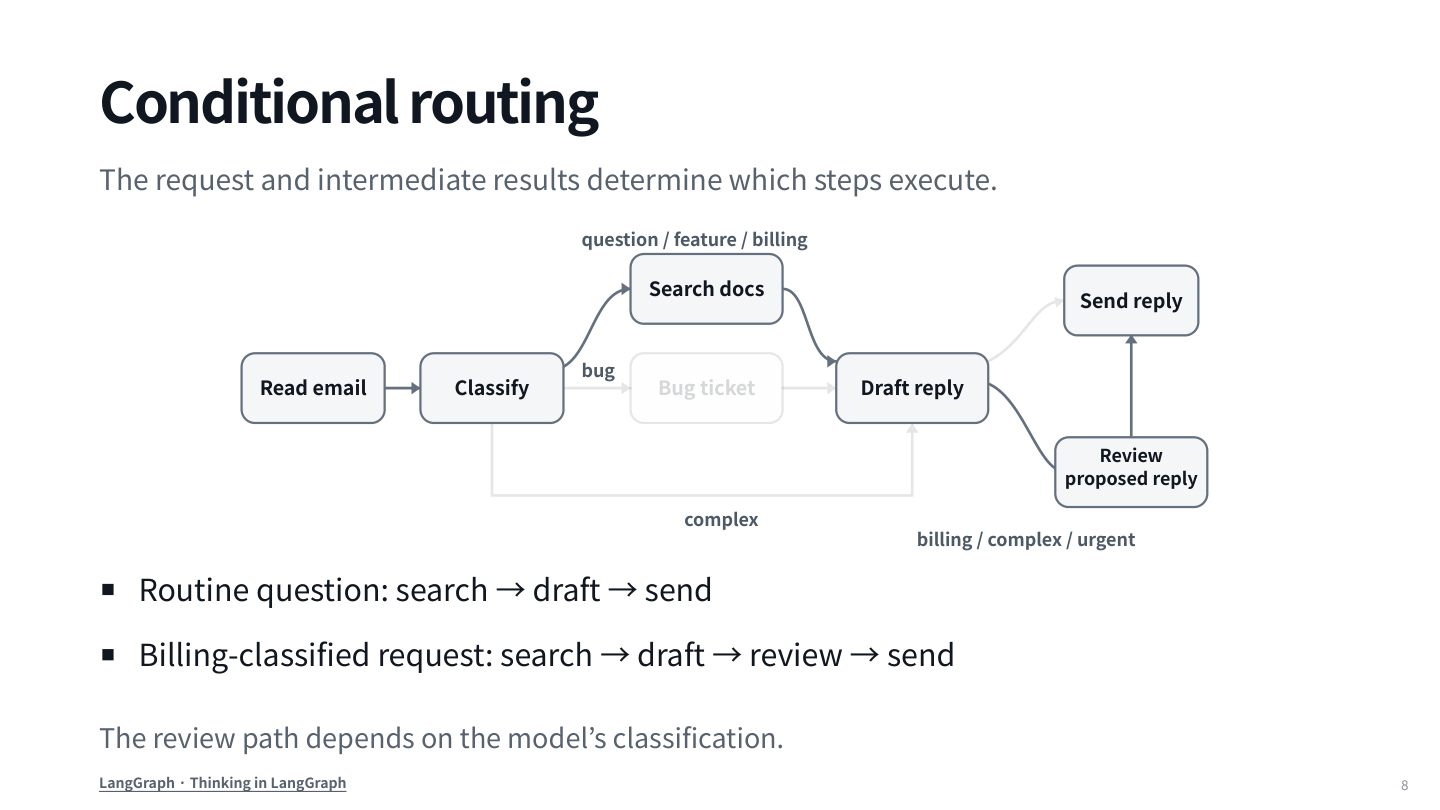
图中审查路径依赖模型分类。若模型把退款误判为普通问题,即使图按设计执行,也可能绕过预期审查。因此需要分别验证分类质量,以及关键政策是否由足够可靠的条件保证。
状态、节点与边
共享状态保存邮件 ID、正文、分类、搜索结果、草稿和审查决定。节点读取状态,执行代码或模型调用,再返回改变的字段。例如分类节点返回 classification;检索节点用分类中的意图和主题构造查询;草稿节点结合邮件与资料生成回复。
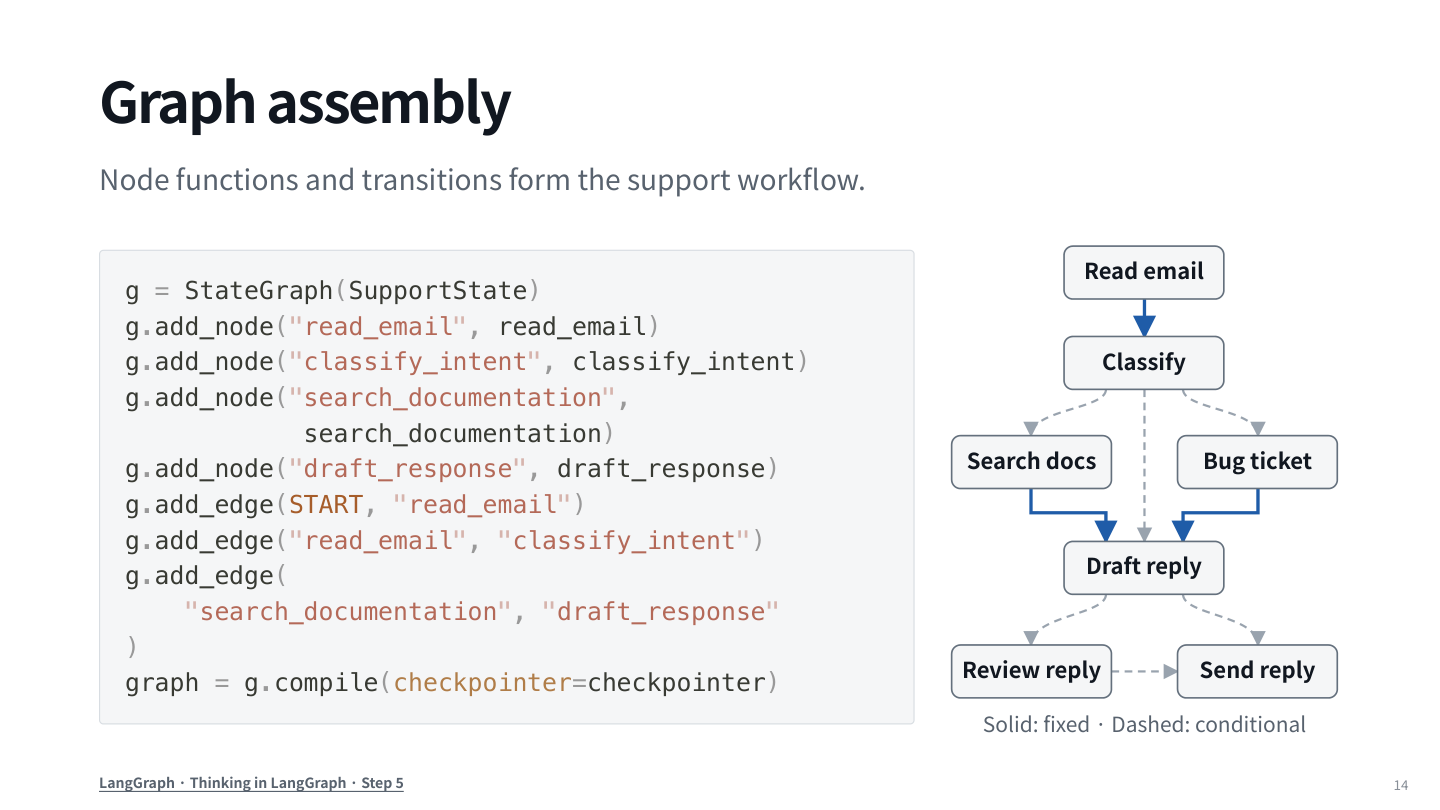
固定边规定已知转移,条件路由依据状态选择下一节点。节点粒度还决定失败后能复用多少工作:把搜索结果保存后再生成,生成崩溃时就可以只重复生成,而不必重新检索。
检查点、恢复和人工输入
Persistent checkpointer 保存状态与执行进度,相同执行 ID 用于加载和继续;临时错误由重试策略处理;interrupt 暂停流程,应用获取批准、编辑或拒绝,再以新输入恢复。
保存状态不等于任意副作用都可安全重试。例如发送邮件已经成功、记录检查点之前崩溃,再次执行可能重复发送。补充说明:实际应用还需通过幂等标识、外部状态核验等机制处理这类边界;这是依据工作流恢复语义引出的工程问题。
Trace 与测试怎样验证流程
一个步骤内部可能包含模型调用、工具调用和普通代码,trace 将它们组织成树,记录输入、输出、时间和错误。课件提供密码重置与重复扣费的运行记录,后者分为审查前后两个阶段。
测试分成不同层次:节点测试控制输入与外部调用,检查状态更新和路由;完整图测试验证真实转移、检查点和恢复;真实模型与服务集成则检验端到端行为。直接调用节点不会覆盖持久化。
| 场景 | 应验证的行为 |
|---|---|
| 密码问题 | 检索、起草并按策略发送 |
| 账单投诉 | 暂停审查,批准前没有发送 |
| 草稿被拒绝 | 结束且没有发送 |
| 搜索暂时失败 | 按策略重试并继续 |
| 更换模型 | 原有关键流程仍然通过 |
工作流提高一致性、可测性并可能节省模型调用,也降低了自由适配能力,开发者必须显式管理信息流。课件还比较 OpenHands、OpenAI Agents SDK、AG2 和 DSPy 的不同抽象,本讲详细示例集中在 LangGraph。
从单条 Trace 到规模化行为调查
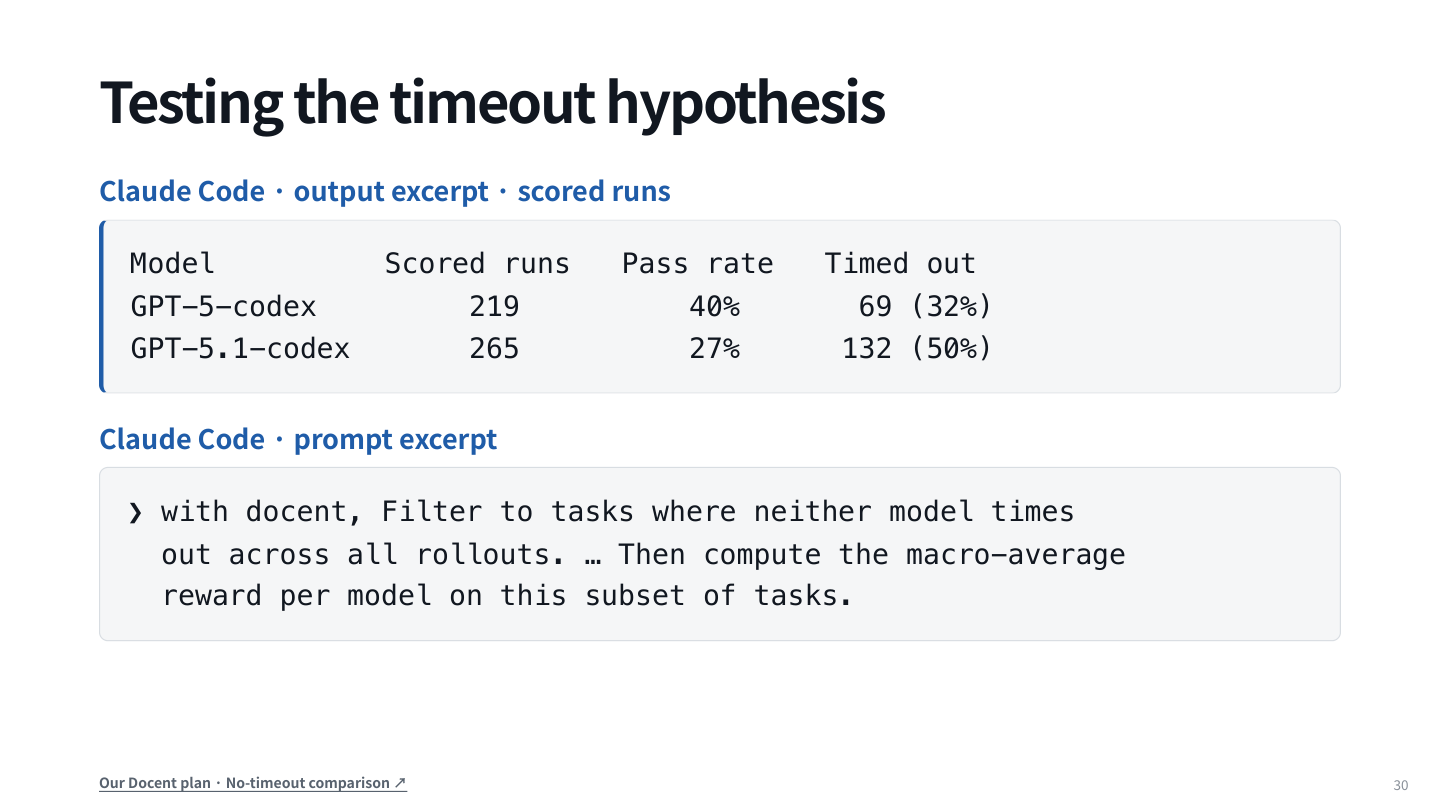
大量轨迹不能全部靠人逐条阅读。课程后半段用 Docent 调查同一 Harness 下两个模型在 Terminal-Bench 的差异:先把同任务的成功与失败轨迹配对,解释具体原因,再归纳模式,并用元数据检验假设。
课件样本中,一个模型更常在交付前超时,另一个更常交付格式不对的结果。筛出两个模型都没有超时的 28 个任务后,宏平均成功率排名反转。这说明超时可能影响原比较,也说明筛选后的子集已改变分布,不能据此宣称某模型整体更强。
怎样发现事先不知道的行为
现成 judge 往往只能检查提示里列出的行为。Hodoscope 先摘要动作或轨迹,再对摘要做 embedding 和聚类,让调查者发现未预设的模式;发现差异后,仍要回到原始调用判断。
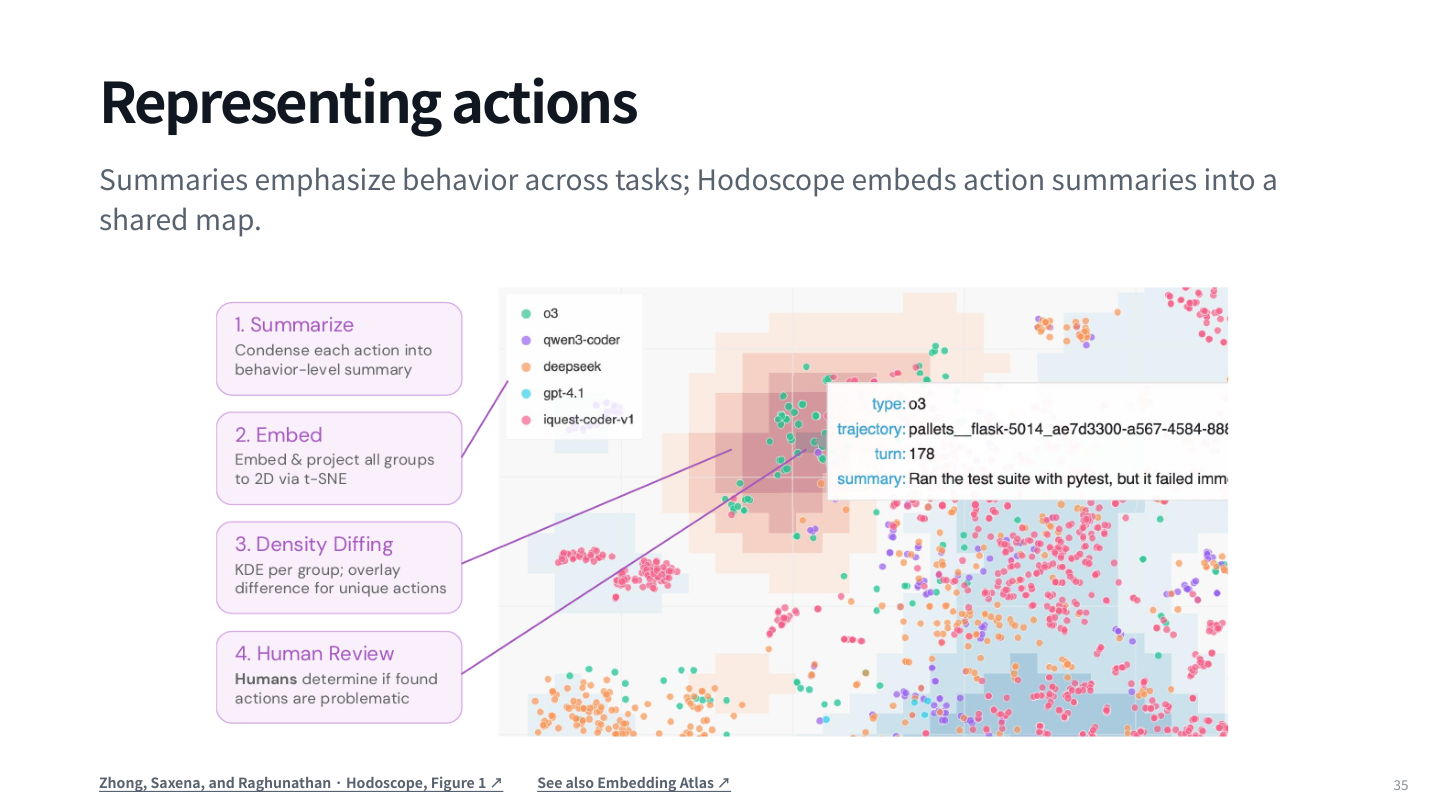
Commit0 的例子从 Git 操作簇中发现,智能体通过旧提交恢复被移除的实现。这个行为未必会在一般“答案质量”判断中被识别,却影响任务是否按预期完成。规模化监控需要把聚类、证据回查、统计和独立评测连接起来。