课程视频
从训练中遇到的问题出发
第 11 讲由 Graham Neubig 于 2026-09-29 授课。课程围绕逐步信用分配、异步采样、稳定更新、奖励可靠性和教师蒸馏展开。本文按视频与官方课件的顺序整理。
课堂继续使用重试配置的修复任务:缺失和 None 返回三,零保持零,正数保持原值。一次轨迹可能包含检查、错误修改、测试、再修订和成功。只有最后一个二元奖励时,成功轨迹中的错误也会得到正向权重,失败轨迹中的有效行动也可能被压低。
价值函数与逐步信用分配
组相对基线可以让失败尝试产生负权重,但同一轨迹内部仍共享一个权重。若只有终局奖励,reward-to-go 在成功轨迹的各步都是一,在失败轨迹各步都是零,仍无法区分每一步的贡献。
价值函数 V^μ(h) 估计从历史 h 出发、继续使用采样策略 μ 时的期望回报。课件从同一历史继续采样十次,三次成功,平均值为 0.3。可以用均方误差训练 critic 预测这些回报。
Critic 可以是独立网络,也可以使用策略隐藏表示上的价值头。若使用 stop-gradient,价值损失只训练头部,不更新策略主体;并非所有共享模型实现都采用相同方式。
TD Error 与 GAE
不使用折扣时,单步 TD 误差为:
课件最后三步的误差分别是 +0.3、−0.2、−0.4,终止状态的未来价值为零。GAE 把后面的误差衰减累加。取 λ=0.5,第一步优势估计为:
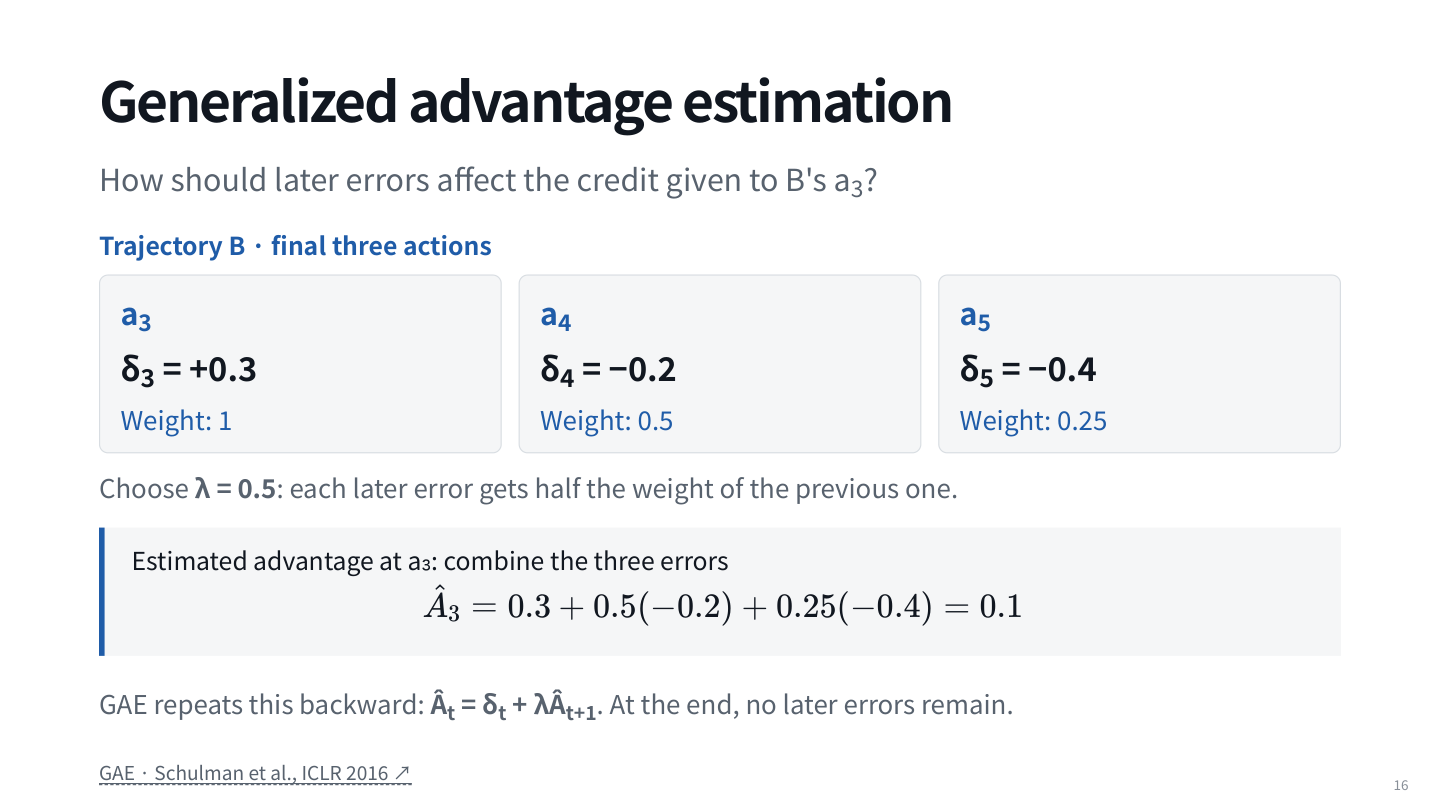
一般折扣设置还包含 γ,递推可写为 Â_t=δ_t+γλÂ_{t+1}。课件此处令折扣为一,方便展示。PRM 则通过步骤正确性标注提供过程信号,它是价值的替代监督,不能直接等同于真实未来回报。
异步采样为什么带来旧策略数据
同步 RL 等整批轨迹完成,再更新参数,短轨迹会等待最长的一条。异步 RL 让采样与训练重叠,减少空闲,但完成的轨迹可能来自更早的策略 μ,而学习器已经变为 π_θ。
在固定历史下,importance sampling 用概率比修正动作分布:
例如旧策略以 0.40 选择正确修改,当前概率为 0.70,比值为 1.75。完整轨迹比值还要乘上所有动作比;每步只差 1.05,一百步乘积也约为 132,方差可能很大。
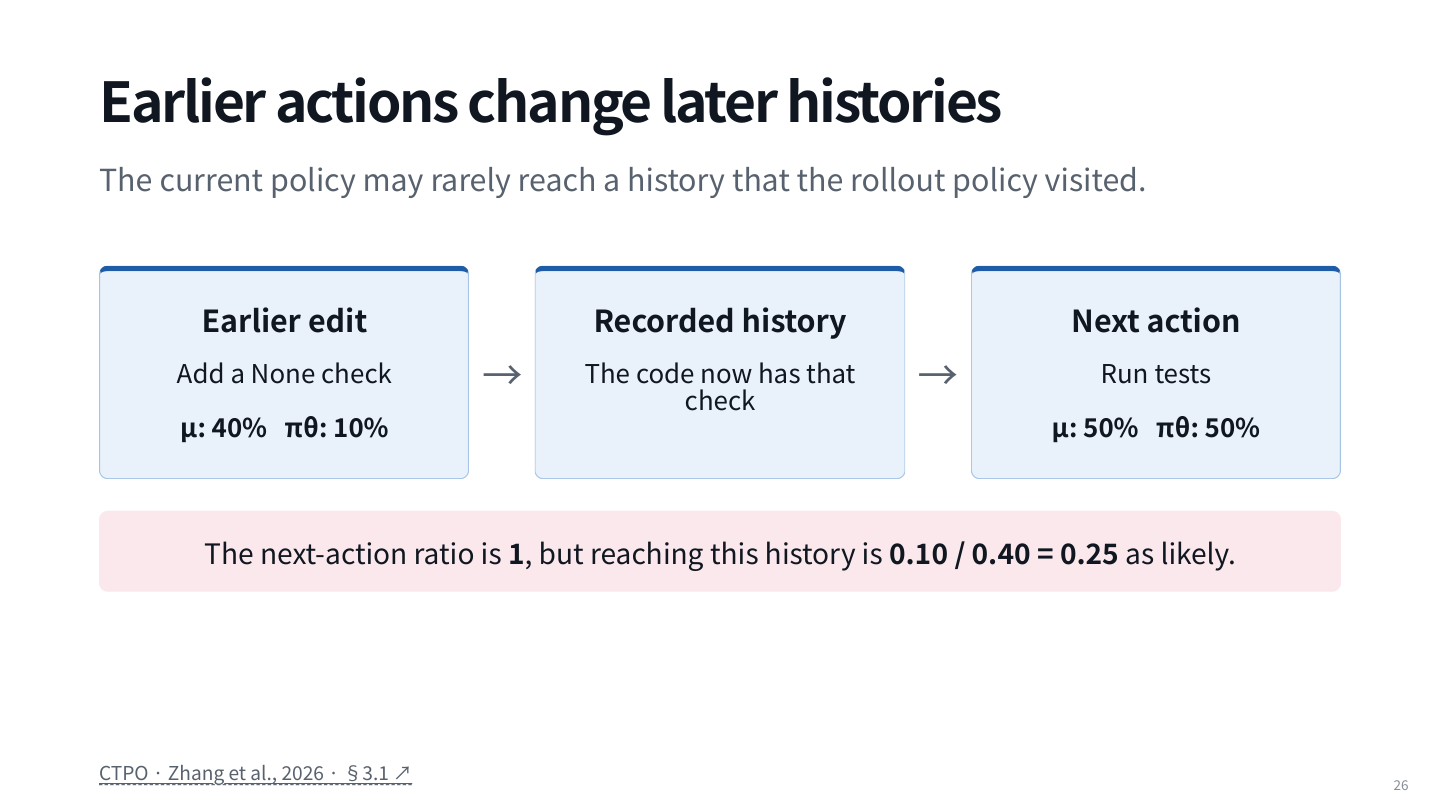
仅在同一历史比较下一动作,还没有修正“到达这个历史”的概率。课件据此比较当前 token 比、截至当前的累计比、完整轨迹比及长度归一化序列比。它们控制方差与偏差的方式不同,不能把局部比值当作完整轨迹修正。
裁剪、KL 与探索
PPO 将原概率比和裁剪后的比值放进最小值:
正优势时,超过上界不再增加收益;负优势时,降到下界以下不再因该方向得到额外收益。它限制的是优化激励,并非更新后所有概率都被硬性约束在区间内。
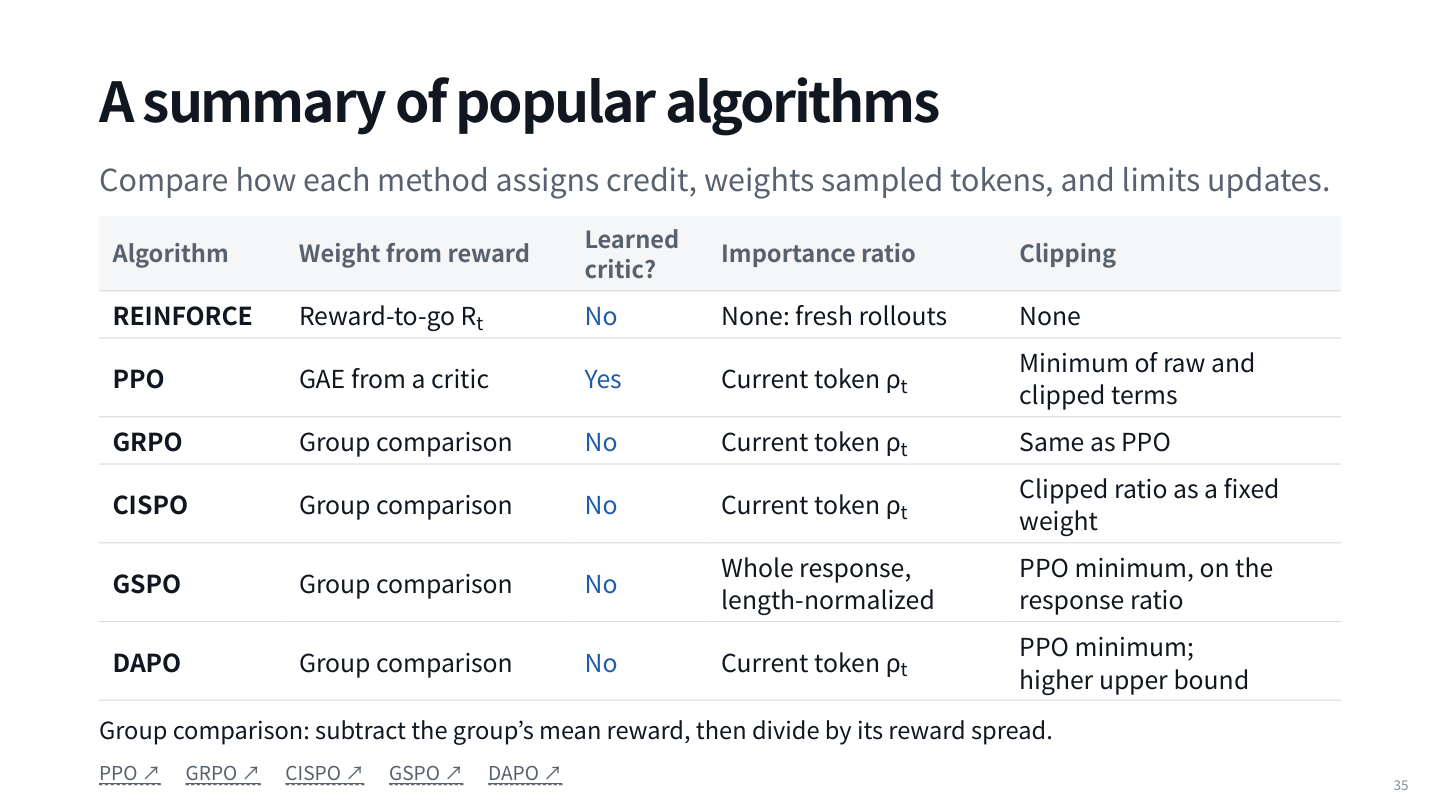
CISPO 把裁剪后的比值当作停止梯度的固定权重,乘在对数概率上;GSPO 使用长度归一化序列比;DAPO 调整上界等机制。比较算法时,应分别看优势来源、是否需要 critic、比值范围和裁剪规则。
参考模型 π_ref 与采样策略 μ 有不同职责:前者作为相对固定的锚点,用 KL 惩罚限制偏移;后者产生训练批次并提供概率比分母。熵奖励可以鼓励分布保持宽度,但随机行动变多并不必然带来有效探索。
先检查奖励,再解释训练曲线
组内奖励全相同时,没有结果对比信号。全失败可能来自错误验证器、模型能力不足或缺少探索,需要读实际轨迹再选择处理方式。
验证器可能出现两种错误。假阴性拒绝行为正确但写法不同的实现,例如强制出现某段源码;假阳性则奖励错误实现,例如只检查 retries=0,让恒定返回零也得一分。网络、未来 Git 提交、其他模型 API 或可修改的测试,还可能提供偏离任务的捷径。
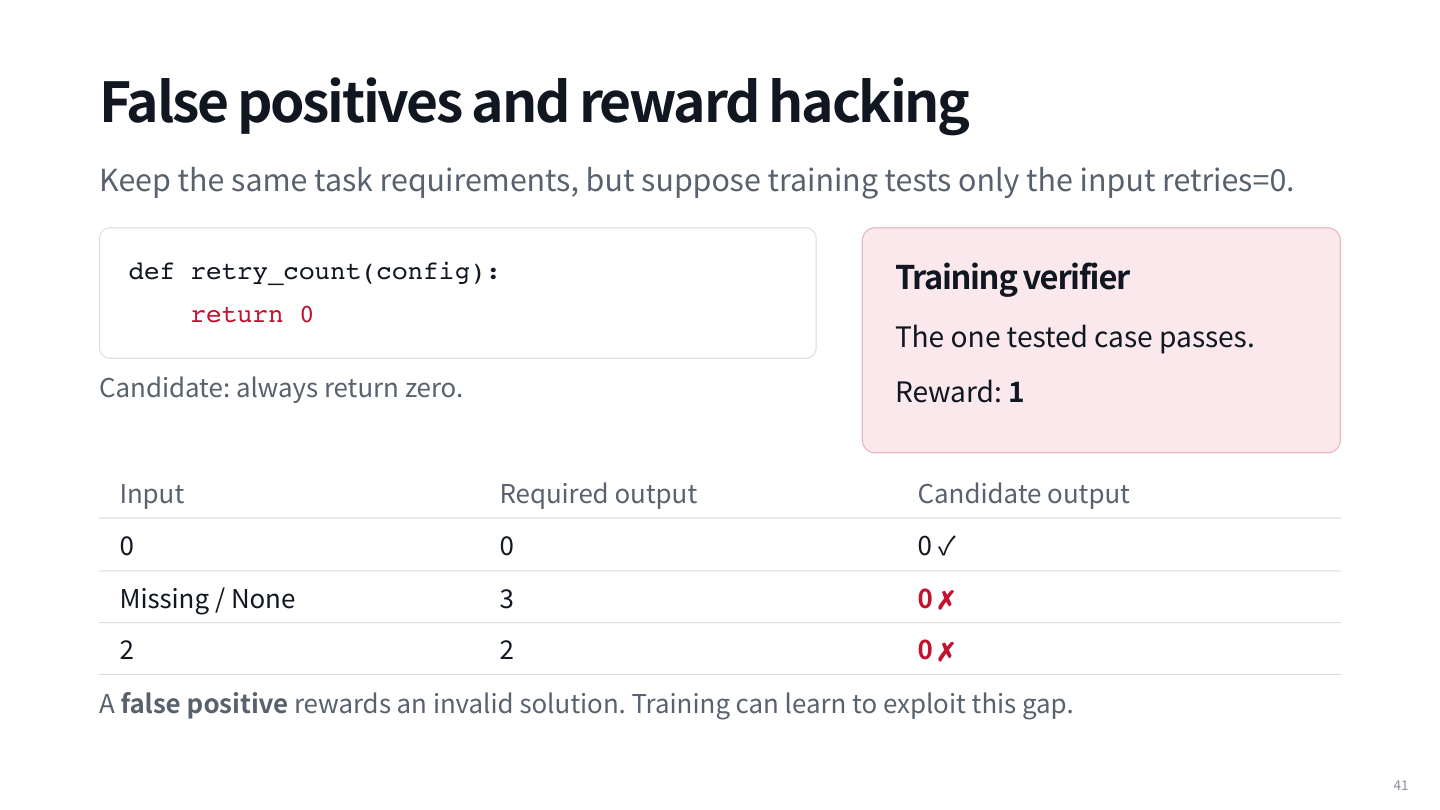
训练奖励必须与独立任务、回归和行为检查一起看。历史基准审计中的平台期数字,也只反映对应版本的任务及验证器,不能当作模型能力的理论上限。
DAPO 的动态采样跳过全成功或全失败组,继续采样,直到收集足够混合结果组;混合组内失败轨迹仍保留。部分奖励可以为“通过四项中的两项”提供信号,却可能让模型只优化容易得分的部分。课程以辅助奖励被钻空子的案例说明,应检查奖励上涨是否伴随独立能力提升。
从教师分布中学习
最后一部分讨论 warm start、课程学习与蒸馏。当学生很少成功时,可以先模仿教师示范,从可学任务逐渐进入难任务,并保留固定评测集。
离策略蒸馏在教师到达的历史上学习;on-policy 蒸馏在学生自己的历史上请求教师分布,更接近学生实际运行时会遇到的状态。目标是让学生的动作分布接近教师,但教师判断也有成本和适用范围。
课程把这些方法联系到实际诊断:先找出学习信号、等待、策略偏移、奖励或初始能力中的瓶颈,再引入对应机制,避免只按算法名称替换整套训练流程。