为什么需要多个智能体
本页对应官方第 18 讲 Multi-agent Systems,由 Saujas Vaduguru 于 2026-10-29 授课。以下按官方课件顺序整理。截至 2026-11-08,提供的收藏中尚无本讲视频,图示与实验均以课件为依据。
多智能体系统中,多个执行体的联合行动改变环境,各自获得观察和奖励。课件从三个目的展开:更有效地使用推理时计算,与本来就存在的其他实体交互,以及为训练和评测构造交互环境。
单一执行流可能遇到上下文不断增长、独立任务串行、所有子任务依赖同一模型,以及缺乏多方案探索的问题。增加 agent 是处理这些问题的一种结构选择,收益仍要与同预算的独立采样或更强单 agent 比较。
用多智能体组织推理时计算
固定角色与按需委派
ChatDev 等系统把人类组织中的角色映射成不同提示与工具,按固定工作流协作。课件还展示个人助理:日历 agent 和邮件 agent 分别封装成工具,由 supervisor 调用。角色可以隔离工具与上下文,也会引入交接与预设分类的限制。
开放委派使用通用 agent,根据任务临时创建实例。Multi-agent debate 先独立作答,再把其他答案加入上下文,反复修订;课件用宝石数量题展示这一过程。趋于一致不能单独证明结论正确,需要外部结果评价。
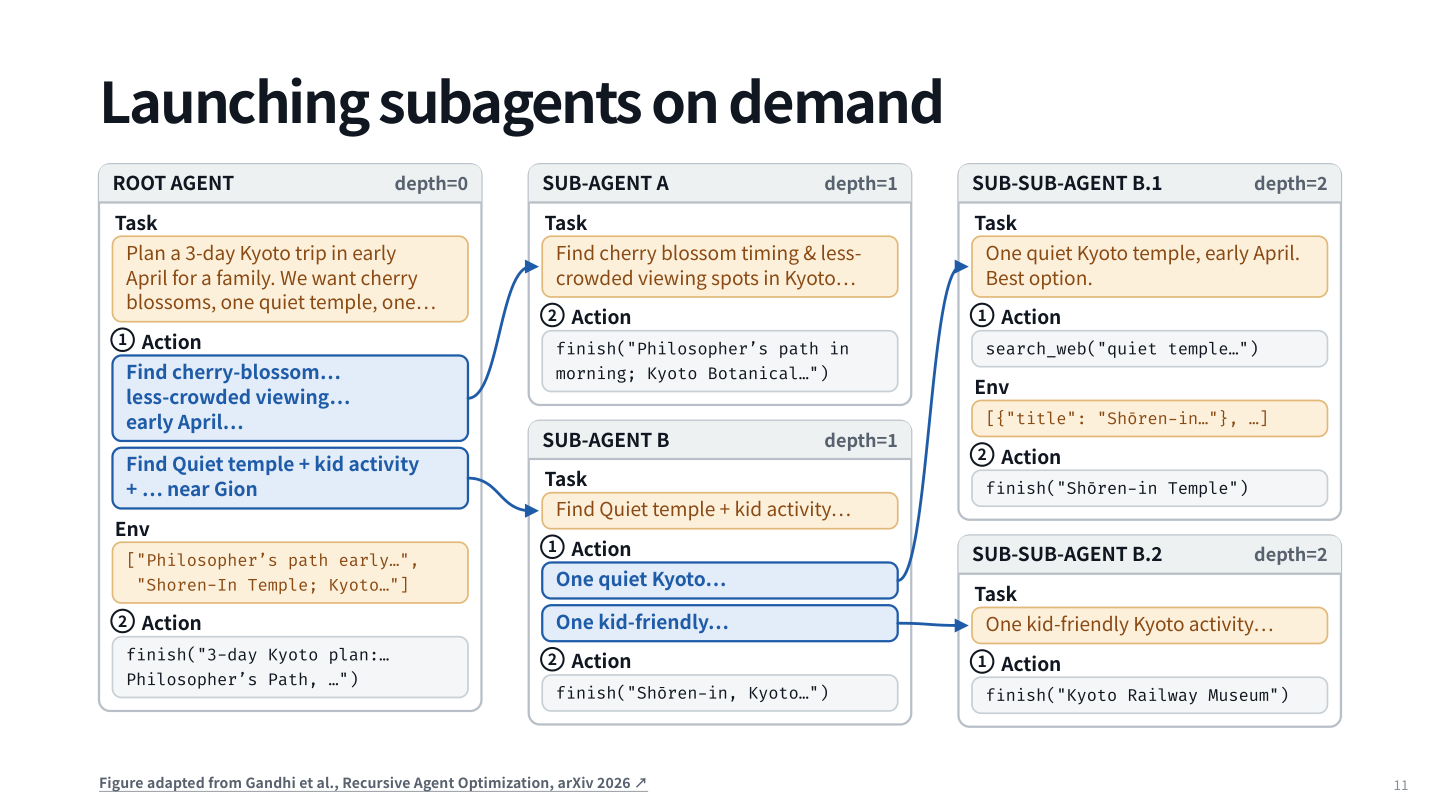
RAO 把启动子 agent 作为动作,允许递归分解。实现可以用异步启动、并行 gather 与 await 表达依赖。MACU 则由管理器维护任务图,派发就绪工作,检查结果并重规划;这些设计都需要规定结果与证据如何回到上层。
异步协调与共享状态
CAID 用 DAG、结构化 JSON 消息和 Git 协调并行代码工作。Blackboard 将信息写入共享板;DeLM 公开任务队列,标记任务认领者,用带类型、可附附件的追加消息作为共享上下文;GitSwarm 则借助 Git 组织分散工作。
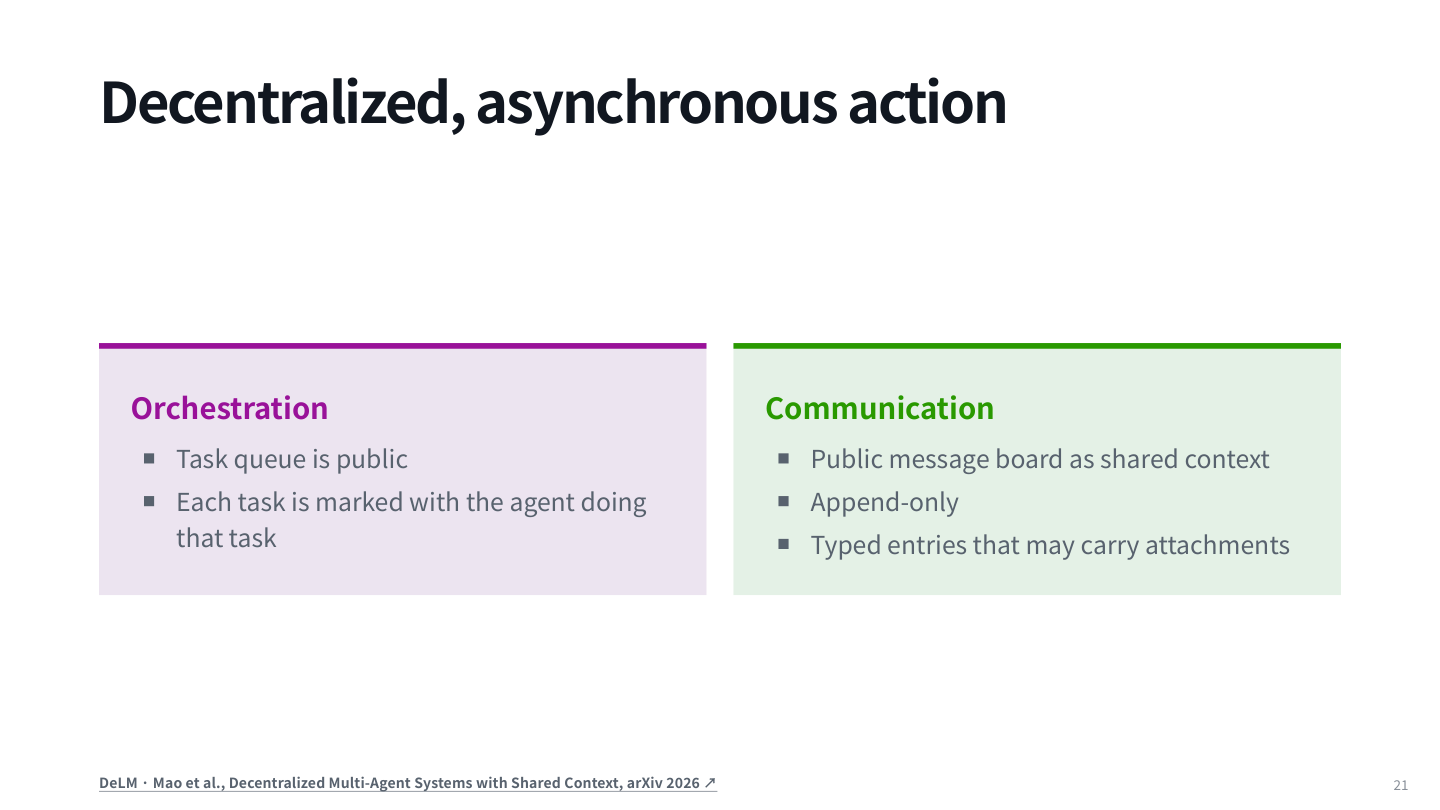
去中心化减少了对单一管理器的依赖,但认领、冲突、消息有效性和结果核验仍需要机制。工具类似人类协作工具,并不意味着所有人类组织方式都适合直接照搬。
通信是否优于独立尝试
课件在 Terminal-Bench 2.0 的一组结果中比较:单 agent pass@1 平均为 52.53%,独立 pass@2 为 62.36%,通信 team@2 为 60.67%。在这组设置下,通信没有超过独立尝试。
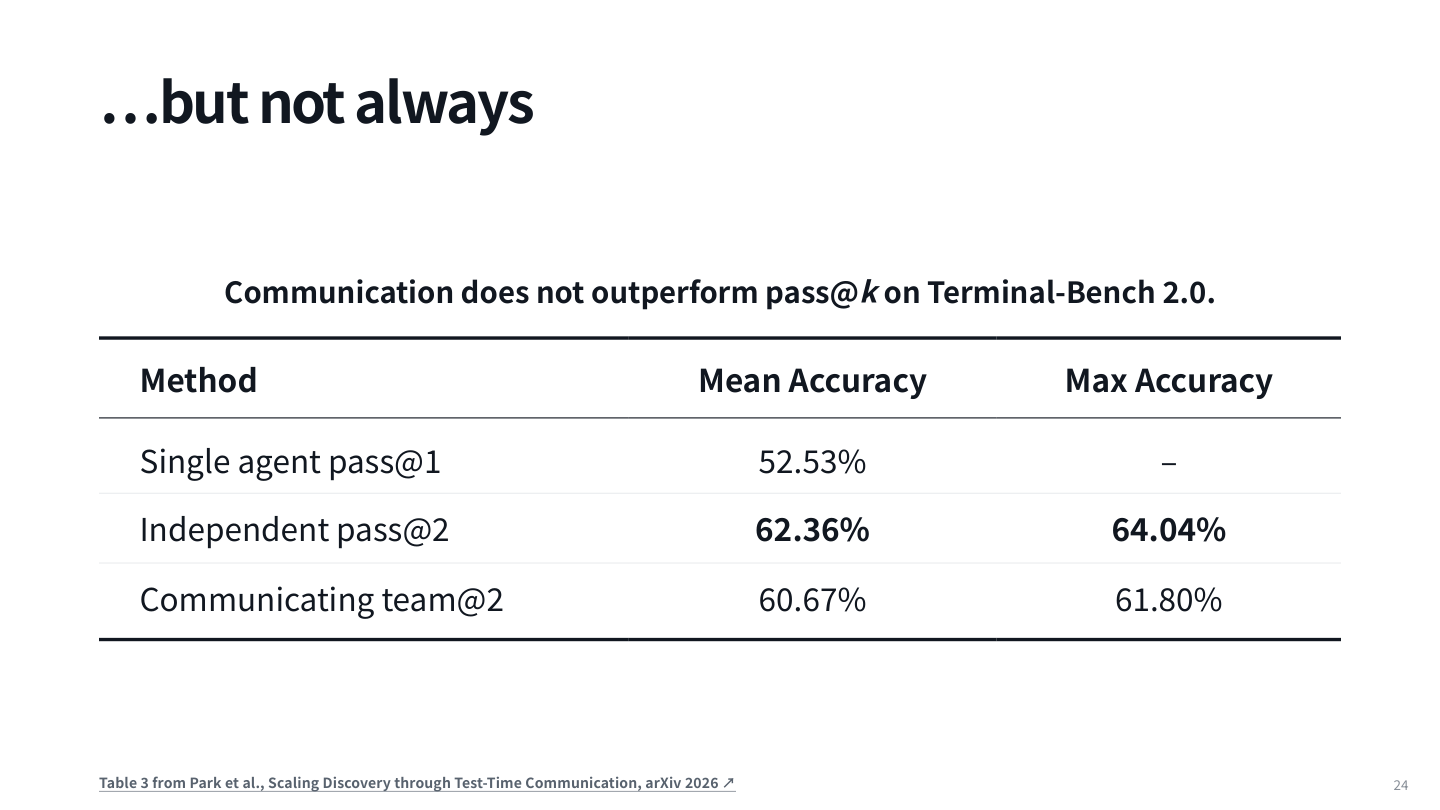
其他任务中通信可以有益,尤其是共享经过验证的进展。需要区分通信本身、更多采样预算、模型能力和任务并行度的影响;把一组结果推广成“多 agent 总是更好”或“通信没用”都超出证据。
与其他实体交互
第二部分把人机协作看成多智能体问题。SWEET-RL 等工作研究多轮协作;用户模拟器提供偏好、反馈和信息,帮助训练提问、主动性及个性化。PPP 的示例将生产力、主动性与个性化奖励相加,具体权重和验证仍由任务决定。
固定模拟器也会被过拟合。模型可能学会利用单个对手或用户的模式,换到真实人或其他模拟器就失效。多样化交互者与留出评估可以帮助识别这种 simulator collapse。
课件继续讨论通信约定、涌现语言与隐式渠道:信息不一定只通过聊天消息传递,目录名称和共享文件也可能成为通信载体。Marketplace 和 Generative Agents 等环境,则研究市场交换与长期社会互动。这些模拟的结论需要连同代理目标、观察和规则解释。
用交互构造训练和监督
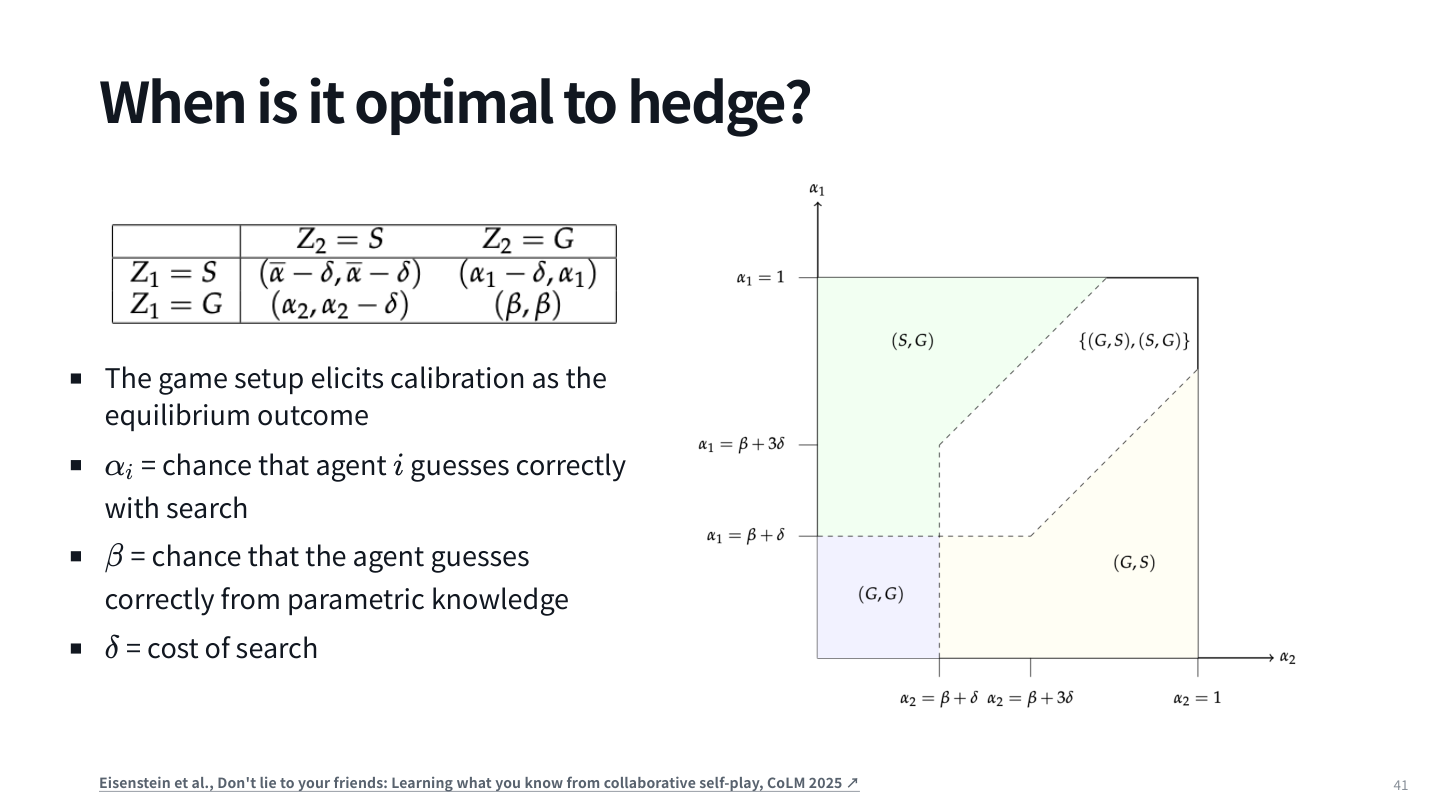
最后一部分讨论不确定性与监督。协作信息搜索游戏让 agent 比较参数记忆答对概率、搜索后答对概率与搜索成本,从奖励结构中学习何时求助、何时保留判断。表达自信的文字和真实校准,需要通过结果分开验证。
Debate 让不同执行体提出论据,帮助较弱 judge 判断。课件展示更有说服力模型与判断正确性的实验,但是否可靠仍取决于任务、证据可核验程度及裁判能力。多智能体既能增加计算,也能作为训练和监督环境;三个用途需要各自设计合适的比较与验收。