课程视频
智能体的历史为什么越积越长
第 3 讲由 Graham Neubig 于 2026-09-01 授课。课程先分析智能体输入的增长,再依次讨论推理、长上下文架构与训练、缓存,以及上下文压缩。下面结合视频和官方课件整理。
假设固定提示为 1K token,每轮新增 5K,连续五次调用的输入分别是 6K、11K、16K、21K 和 26K,累计 80K。历史长度线性增长,反复提交完整历史的累计输入量呈二次增长。 这是 token 访问量的统计,还不能直接等同于模型的全部计算量。
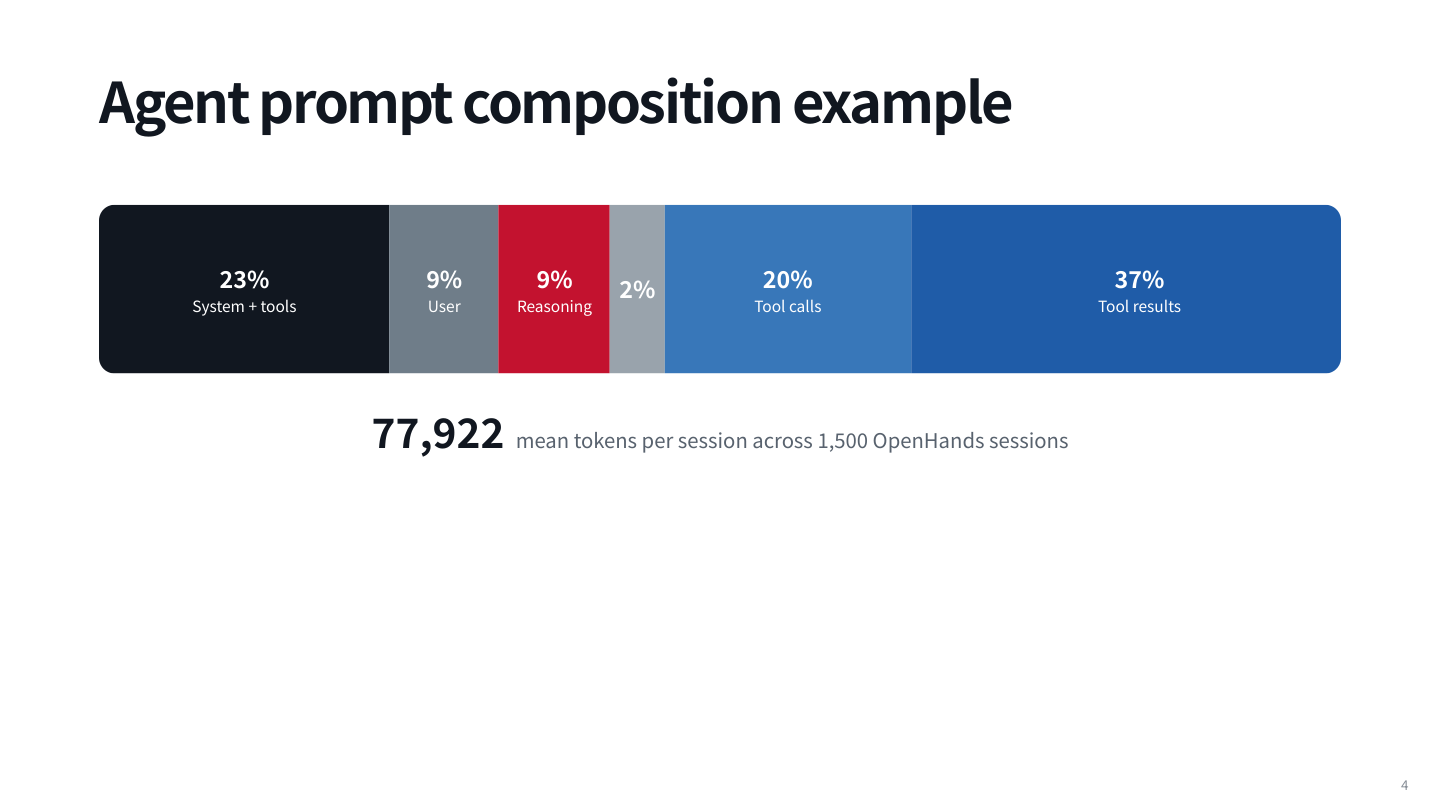
Graham 分析了 1,500 次 OpenHands 会话:每个会话平均使用 77,922 token。其中系统提示与工具说明占 23%,用户消息占 9%,推理占 9%,模型文字回复约占 2%,工具调用占 20%,工具结果占 37%。这些是该样本的统计;它说明读取文件、日志等观察,往往比最终给用户的文字更占上下文。
长上下文有两个问题:容量(capacity)关心模型能否利用远处的证据,效率(efficiency)关心系统能否承担计算、显存和等待时间。标称支持 1M token,不代表所有位置的信息都能被稳定使用。
Prefill、Decode 与注意力
服务端先调度请求,再执行 prefill:一次处理已有提示,为各位置计算 Key 和 Value。随后 decode 每次生成一个新 token,并把相应 KV 追加到缓存。Prefill 通常偏计算密集,decode 则具有顺序依赖,也容易受内存带宽限制。
| 指标 | 含义 | 使用时需要留意 |
|---|---|---|
| TTFT | 请求到达至第一个输出 token 的时间 | 包括排队等因素,并非纯 prefill 时间 |
| TPOT | 相邻输出 token 的时间间隔 | 影响阅读和交互速度 |
| Throughput | 单位墙钟时间内完成的 token 或请求 | 衡量整体服务能力 |
| Cost | 输入、缓存输入和输出的费用 | 需要按完整任务统计 |
课堂对比交互式编程和夜间后台任务:前者更关心及时响应,后者可以容忍等待以换取吞吐或费用优势。
标准因果自注意力可写为:
其中未来位置被掩码屏蔽。稠密注意力比较序列中的位置对,计算随序列长度近似二次增长。Needle-in-a-Haystack 则从有效性角度测试:把一条证据放入长文本,在不同长度、不同位置提问,看模型能否找回。它不能覆盖所有长程推理,但能揭示“容纳输入”和“用对信息”的差别。
长上下文架构怎样减少工作量
课程先介绍局部与全局计算。局部层降低每层代价,全局层让远处信息仍有机会进入当前决策;混合模型周期性组合两者。课件中的模型配置是授课时的快照,不作为当前选型清单。
滑动窗口与递归状态
滑动窗口只关注附近 w 个位置,把注意力工作量从 O(n²) 降到 O(nw)。单层不能直接访问窗口之外的 token,但多层可以逐步传递信息。
线性注意力换用可重排的双线性计算,把历史压缩为固定大小的状态矩阵。沿用课件记号:
这个简化形式展示了如何递归更新历史;它改变了 softmax 注意力的表达方式,并不是对原计算的无损加速。DeltaNet 进一步先从旧状态预测当前 value,再写入预测误差:
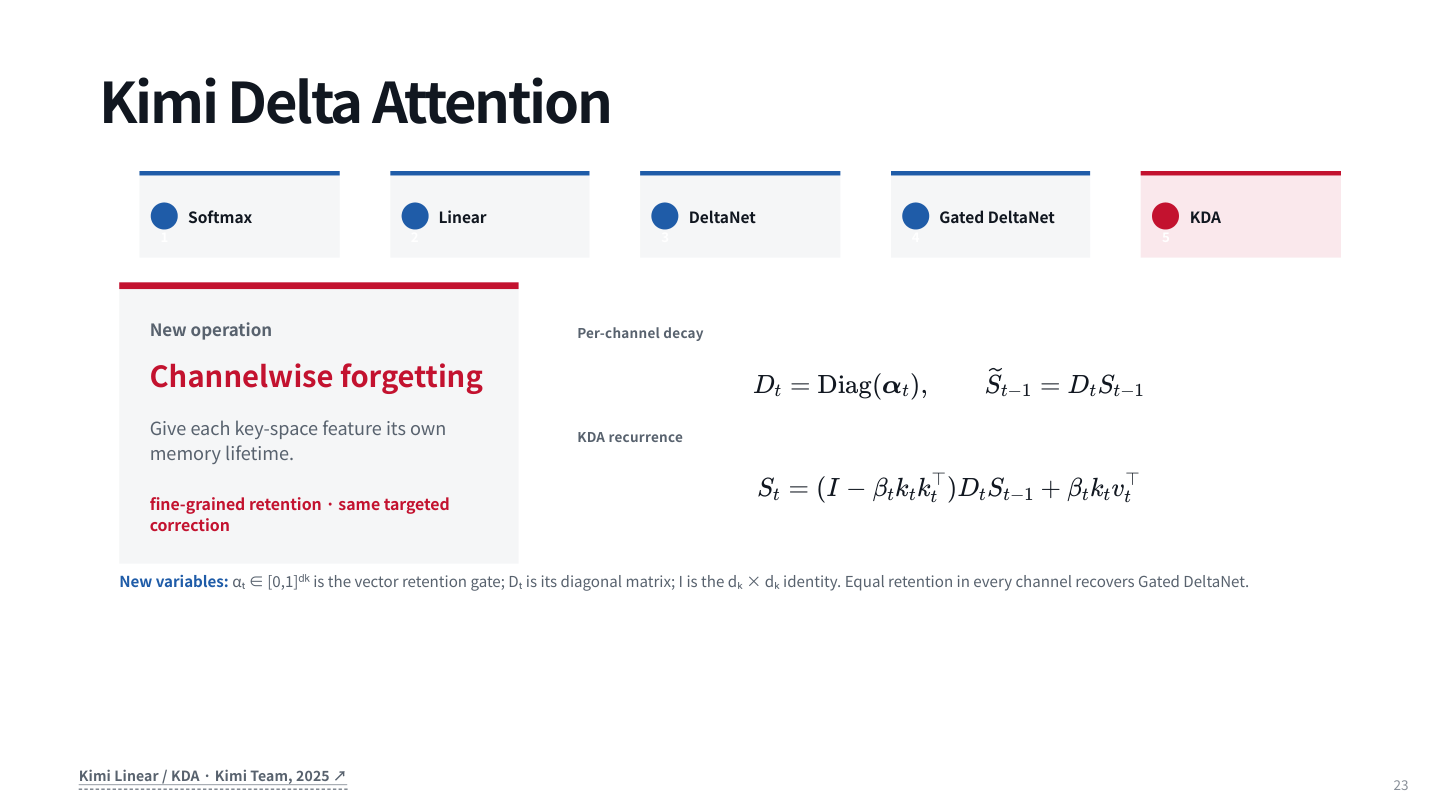
Gated DeltaNet 在写入前对旧状态施加标量衰减,使远处信息逐渐遗忘;Kimi Delta Attention 使用按通道的保留门,让不同特征具有不同记忆寿命。
稀疏访问与 KV 压缩
稀疏注意力保留部分历史位置。固定模式容易预测计算量,内容相关的选择器则可先用便宜的评分选出 Top-K,再对这些位置计算注意力。后者能适应当前查询,但选漏了证据,后续注意力就无法使用它。
KV 压缩关注缓存体积。GQA 让多组 Query 共享较少的 Key/Value 头;MQA 是只保留一组 KV 的特殊情况。MLA 保存低维潜变量,并据此恢复对应的 Key/Value 表示。它们减少缓存的方式不同,也需要对应的模型训练和实现支持。
长上下文还需要怎样训练
常见路径是短序列预训练,再用更长的连贯数据继续训练,最后适配长任务。把十份无关文档拼成一个长序列能提高利用率,却未必教会模型跨文档寻找依赖;代码仓库、长文档、多文档问答、智能体轨迹和可控合成任务提供了不同类型的长程关系。
课程依次回顾位置表示:绝对位置编码把位置向量加到输入;RoPE 旋转 Query 和 Key,使内积与相对距离关联;NoPE 不显式加入位置编码,但因果掩码和递归更新仍能携带顺序信息。NoPE 不代表无需训练长程行为。
RoPE 模型从长度 L 扩到 L′=sL 时,可用位置插值把 R(t) 换为 R(t/s)。YaRN 对不同频率采用不同的插值程度,并调整注意力温度,兼顾远距离扩展和局部区分。具体参数需要结合模型验证。
上下文并行(context parallelism)则把序列分到多张设备,交换 KV 块以完成注意力。Ring Attention 保留精确稠密注意力的总计算量,通过分摊存储与重叠通信提高可运行长度;它没有把总工作量改成线性。课堂还提醒,新的递归架构未必已经具备成熟的上下文并行内核。
缓存怎样避免重复 Prefill
一次调用结束后,提示和模型输出对应的 KV 已经计算过。工具结果返回时,只需为新增输入计算状态,旧前缀可以复用。随着轮数增长,可复用部分会越来越大。
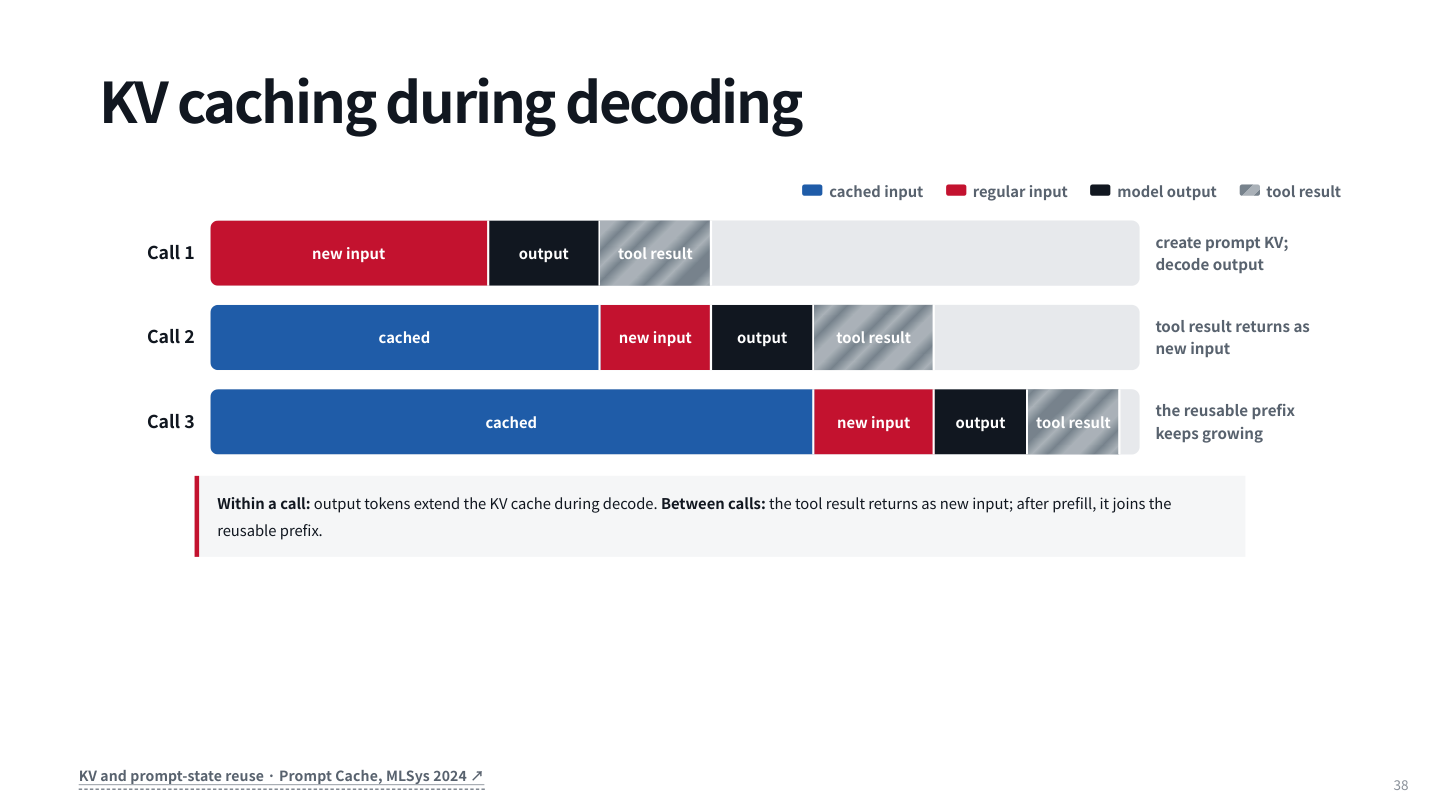
缓存没有删除模型可见的历史,也没有解决“模型忽略旧约束”的问题。它主要减少重复计算。物理计算成本与 API 报价也不同,课件第 40 页价格表只是 2026-08-30 的记录,不宜当成实时价格。
接下来介绍三个服务端机制:PagedAttention 用块表管理非连续 KV 内存;RadixAttention 用前缀树共享相同提示;缓存感知路由在前缀命中与队列负载之间取舍。应用侧可以稳定系统指令、工具顺序和示例,把变化内容追加在后面,避免不断修改前缀造成失效,同时观察缓存 token、TTFT 和淘汰情况。
压缩应留下可继续执行的状态
课程最后讨论 compaction。课件例子中,CI 超时的原始历史包含 24K 行日志、多次操作和一次成功运行。压缩后的工作状态保留:目标是修复超时;原因是端口冲突;--workers=1 已通过验证;证据位于 /tmp/ci.log;下一步是提交相应修改。
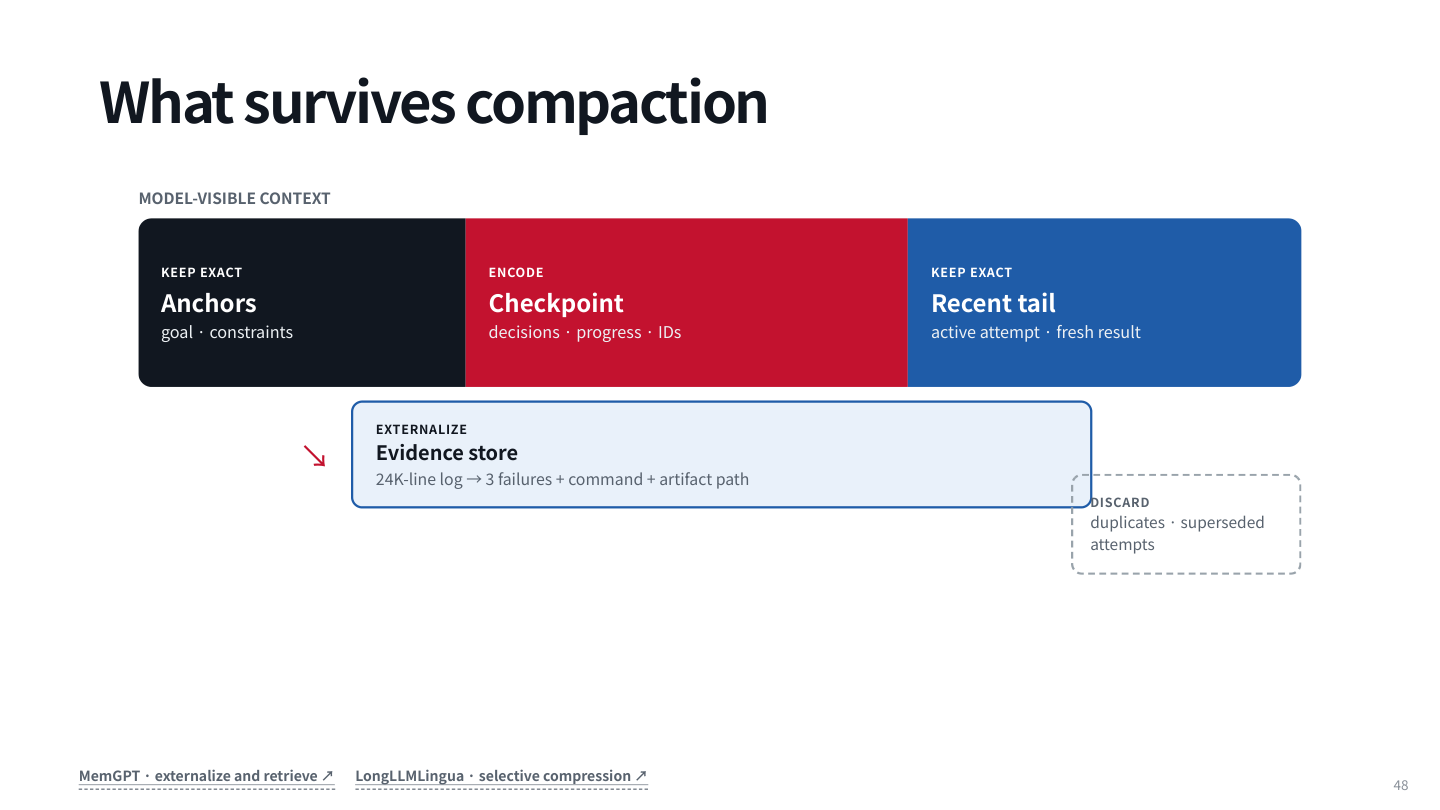
可以把压缩理解为状态估计:用预算有限的表示保留未来行动所需的信息。目标、约束和精确标识需要原样保存;进度、已作决策和验证结果整理成检查点;近期操作保留上下文;长日志外置并保留可检索路径;重复和已被取代的尝试才适合丢弃。
触发时机要预留下一次输出空间,压缩边界要保持消息与工具交互合法,失败时要明确继续、重试或重置的策略。可读摘要、结构化检查点和提供商返回的压缩对象,也有不同的可检查性。
反复压缩还可能让 CUDA 12.4 变成 CUDA 12.x,继而变成“较新的 CUDA”,最终丢失约束。课件用这个例子说明摘要会继承上一版的损失,因此需要精确锚点、近期尾部和回查原始证据。
评估不能停在“摘要是否通顺”。应在历史中放入约束、决策和产物,执行实际压缩策略,再让智能体继续工作,测量状态召回、任务成功、成本及多次压缩后的稳定性。