课程视频
通过界面观察和行动
第 7 讲由 Jing Yu Koh 于 2026-09-15 授课,官方名称为 Computer Use Agents。本文按视频中的“交互循环—评测—建模—训练—开放问题”顺序整理。图片标注 PDF 页码;该版课件部分页内编号与 PDF 页序不同,引用以 PDF 页序为准。
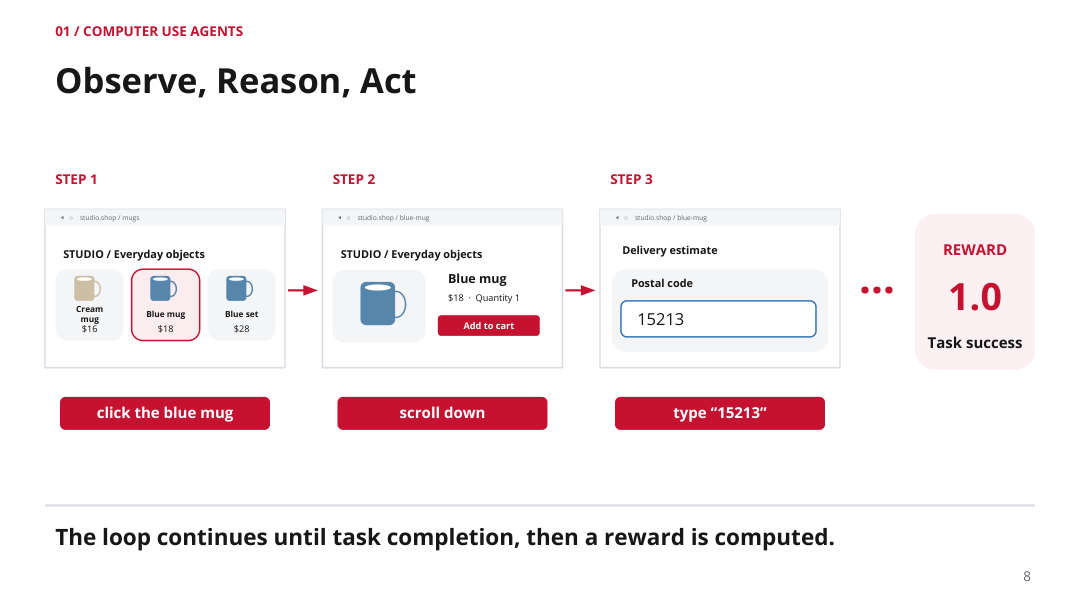
Computer Use Agent(CUA)直接观察渲染后的图形界面,并通过点击、输入、滚动等动作操作浏览器、桌面或移动应用。基础设施负责校验动作、执行操作、读取变化后的状态并提供新截图,模型再选择下一步。
课堂用购买蓝色杯子的连续画面展开:点击商品、滚动查找配送信息、定位邮编输入框,再输入 15213。动作会改变画面,当前坐标的含义也会随之改变,因此下一步需要依据新的观察。
课程随后回顾从 MiniWoB 的简化网页,到 WebShop、WebArena、VisualWebArena、OSWorld,再到带个人历史的 MyPCBench 和专业软件任务的发展。环境越真实,隐藏状态、跨应用依赖和结果验证就越重要。
先决定评测什么能力
点对一个按钮、完成一个任务,以及全程遵守约束,是不同的评测对象。 同样要求“将低于 20 美元的蓝色杯子加入购物车,不要购买”,可以从动作、最终状态和执行过程三个层次检查。
静态动作评测
ScreenSpot-Pro 给定截图和目标,检查预测点是否落在目标区域。课件展示高分辨率 Blender 界面中创建 UV sphere 的位置。Mind2Web 给定离线观察和历史,比较目标元素、操作和输入值。这些评测便宜、可重复,却没有在真实环境中展开后续任务。
端到端环境评测
WebArena 通过自托管网站和程序化检查验证环境状态。VisualWebArena 加入视觉信息,例如商品图片成为筛选依据。OSWorld 则为桌面任务提供初始化和应用特定检查,例如比较保存后的工作簿、金额和需要保持不变的单元格。
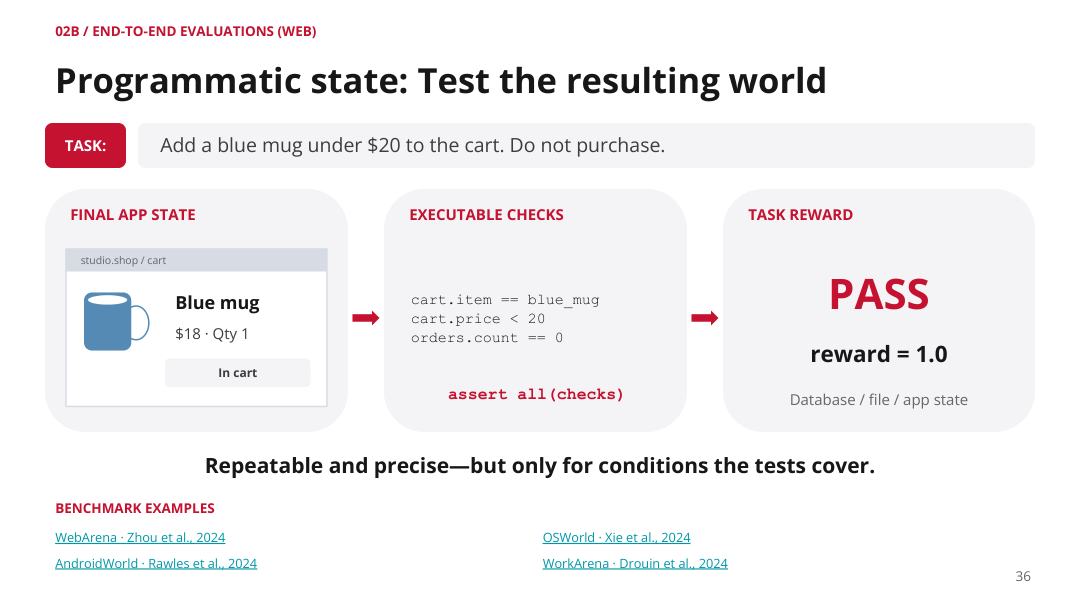
检查程序也有覆盖边界。课件展示 WebArena 创建空仓库的例子:简化验证器确认目标 URL 中出现仓库名,却没有检查“空”这个条件。得到奖励不能反过来证明所有自然语言要求都被覆盖。
WebVoyager 和 Online-Mind2Web 使用真实网站及模型评判,灵活性更高,但页面变化降低可复现性,评判器与人类的一致性也成为成绩的一部分。截图中看不见购买行为,并不等于购买从未发生;证据不足或存在分歧时,需要结合轨迹和人工复核。
长任务与过程约束
WindowsAgentArena 用并行虚拟机缩短评测时间。Odysseys、OSWorld 2.0 和 CUA-World-Long 则让任务延伸到更长工作流:多网站比较、行程规划、CAD 建模和文件导出等。
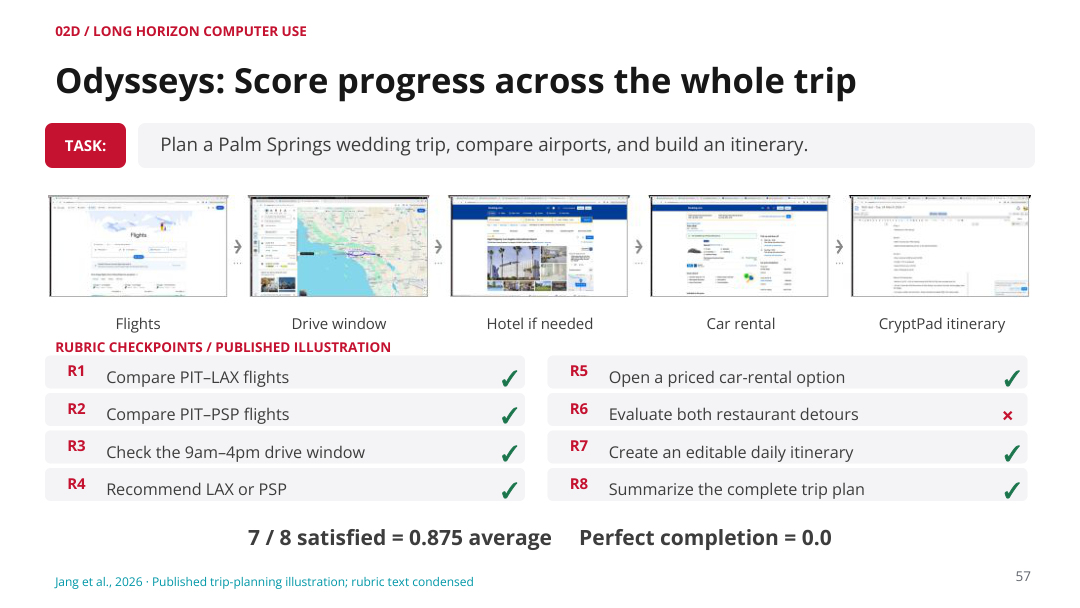
行程例子满足 8 项要求中的 7 项,平均检查点分数是 0.875,但完整完成指标仍为 0。另一个 CAD 例子说明,文件已经导出,也可能不满足参考图的尺寸和结构。长任务应检查交付物内容和必要过程,避免只以“存在一个文件”或“最后一屏看起来合理”判定成功。
视觉历史怎样进入模型
课程接着逐页展开模型输入:任务目标与截图 0 产生动作 0;动作加入历史,执行后获得截图 1;之后继续追加截图与动作。VLM 在当前历史条件下输出点击、输入、工具调用或停止。
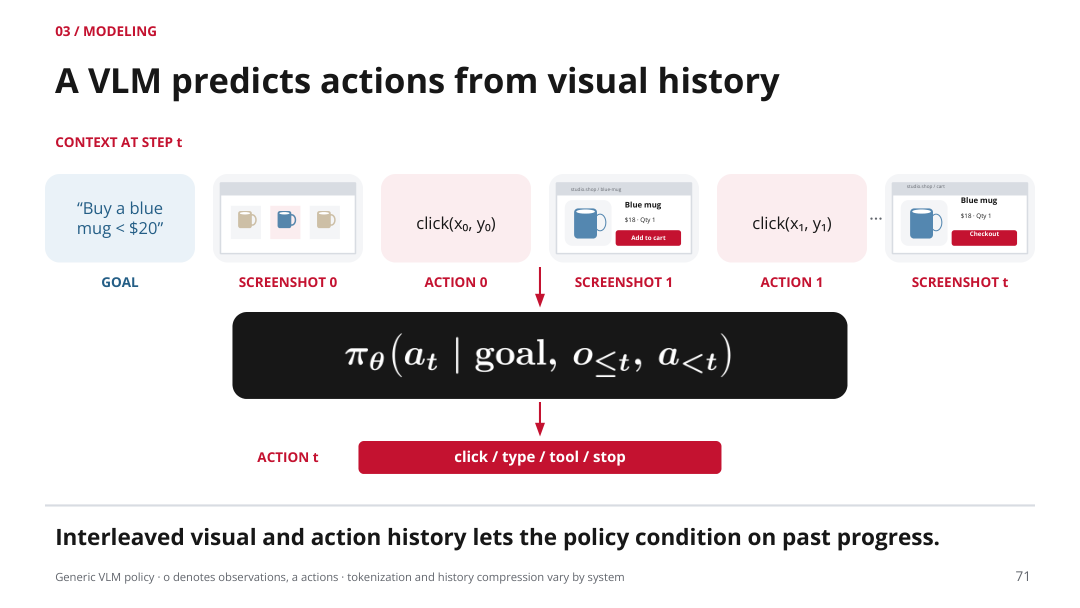
Grounding 将“点击蓝色杯子”这样的意图落到具体位置或元素。截图缩放、屏幕分辨率、滚动和界面更新都会影响坐标。某些系统还使用 HTML 或可访问性树辅助表示页面,但不同观察形式与动作空间不能混为同一项能力。
从数据到交互训练
建模之后,课程讨论预训练、SFT 和 RL。界面元素、OCR、框与标签提供定位信号;人类示范把任务与操作序列连接起来;强模型生成的轨迹可以扩大数据;RL 则在可验证环境中根据任务结果更新策略。
OpenCUA、AgentNet、MolmoWeb 等数据和系统覆盖不同软件及观察形式。记录时需要把截图、动作及可选推理对齐;SFT 学习下一动作,RL 则通过执行轨迹和奖励学习结果。
为什么需要可重置环境
课堂以叫车任务说明真实世界探索的代价:重复尝试可能产生多笔付费订单,影响司机和其他人,取消也不能恢复已经花费的时间。训练环境因此需要可注入初始状态、检查终态并隔离重置。
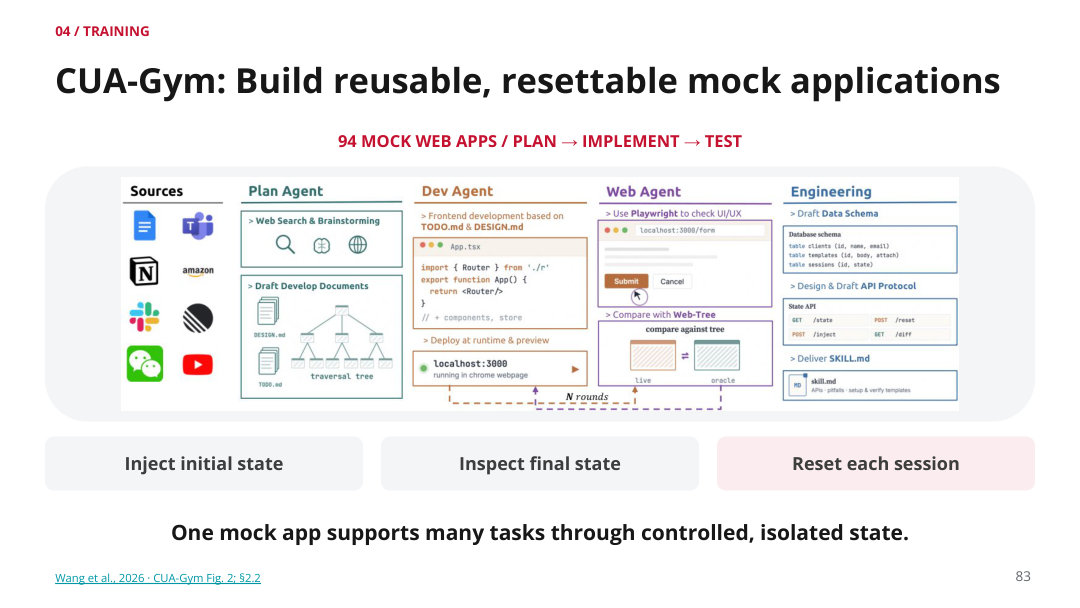
CUA-Gym 共同构造任务、初始状态和奖励,再验证它们是否一致。Gym-Anything 在真实安装的软件中创建任务环境,由独立审计检查证据,并扩大任务、筛选轨迹。训练规模必须连同验证质量一起看:软件数量或生成任务数不能直接等同于有效训练数据量。
课件分别报告这些系统在指定模型、步数上限与评判方式下的提升。程序检查、VLM 清单分数和完整通过率口径不同,不能把各论文的单个数字直接排成统一榜单。
速度、个性化和协作仍有哪些问题
课末回到使用体验。截图和长推理都会增加输入与生成成本,任务耗时可以粗略拆成“轮数 × 每轮时间”。Game-TARS 的稀疏思考把较多推理留给关键决策,其他系统探索直接预测动作;减少轮数也必须保持结果正确。
个性化需要利用用户文件、历史和偏好,并允许修正及遗忘。后台计算机操作还要与用户实时工作协调,提供状态、纠正和中断入口。多智能体可以在隔离环境中执行独立节点,但文件交接、状态冲突和重规划仍有成本。是否更快、更可靠,需要在同一任务与预算下比较。