课程视频
从猜数字理解强化学习
第 9 讲由 Daniel Fried 于 2026-09-22 授课。课程沿着猜数字任务,建立轨迹、期望奖励与策略梯度,再介绍基线、优势和组相对估计。本文按视频与官方课件整理。
SFT 模仿固定轨迹,可能遇到三个问题:示范并非唯一成功路径,数据含次优行为,模型自主运行后又会到达示范之外的状态。强化学习(RL)通过模型自己的尝试和环境奖励调整行为,优化完整任务的结果。
课堂设定隐藏数字位于 1–16,智能体猜测后收到 higher、lower 或 correct,并受猜测次数限制。课件中的成功轨迹为 8 → 12 → 10 → 11。相比随意猜测或线性递增,利用反馈缩小候选区间更有机会在预算内找到答案。
观察、策略与轨迹
模型不知道隐藏数字,只能根据历史选择下一动作:
轨迹包含观察、行动和奖励。环境负责返回反馈,策略只控制自己的动作。课件用终局二元奖励:成功为 1,否则为 0。
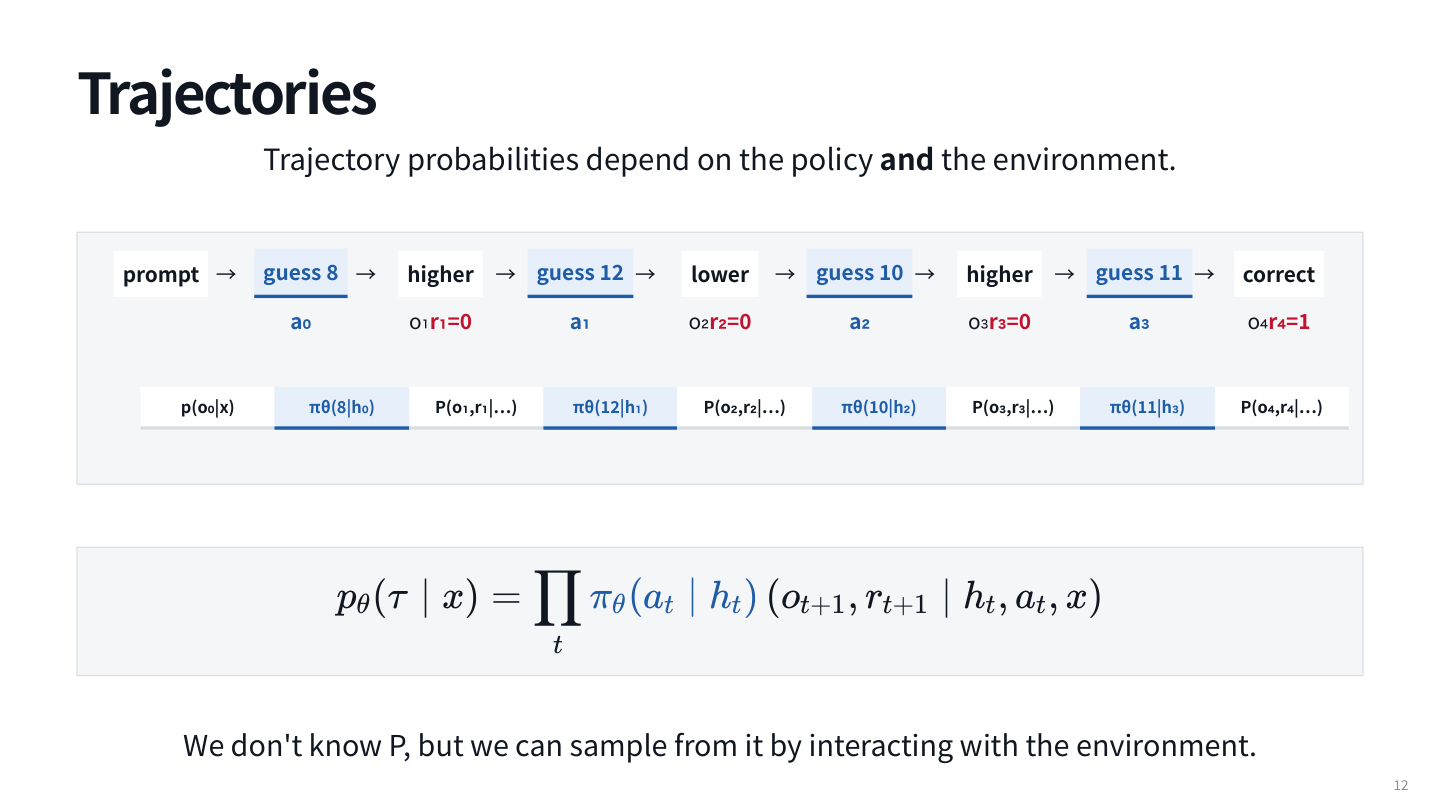
轨迹概率可分解为策略概率与环境转移概率的乘积。即使不知道环境转移公式,也可以通过交互采样。训练目标是提高期望奖励:
它关注整个分布。例如四条轨迹的概率分别是 0.30、0.20、0.25、0.25,前两条奖励为一,其余为零,那么期望奖励为 0.50。
Expert Iteration:采样、筛选、再训练
Reinforced Self-Training(ReST)先用当前策略生成轨迹,计算奖励,筛选高奖励数据并做 SFT,再用更新后的策略重复采样。课件保留两个找到隐藏数字的轨迹,丢弃预算内未成功的轨迹。
这样可以不断从模型自身尝试中获得数据,但失败轨迹直接被丢弃;若模型一次都不能成功,筛选就无法产生正例。引入较容易的任务、更多探索或示范,是后面需要讨论的问题。
奖励怎样形成梯度
动作是离散采样,环境和测试也通常不可微,无法直接对执行过程反向传播。REINFORCE 使用对数导数技巧:
当环境转移不依赖模型参数时:
动作由多个 token 组成,动作对数概率又可按生成 token 求和。实现上仍使用类似 SFT 的 token 对数概率和掩码,只是用采样得到的奖励加权。
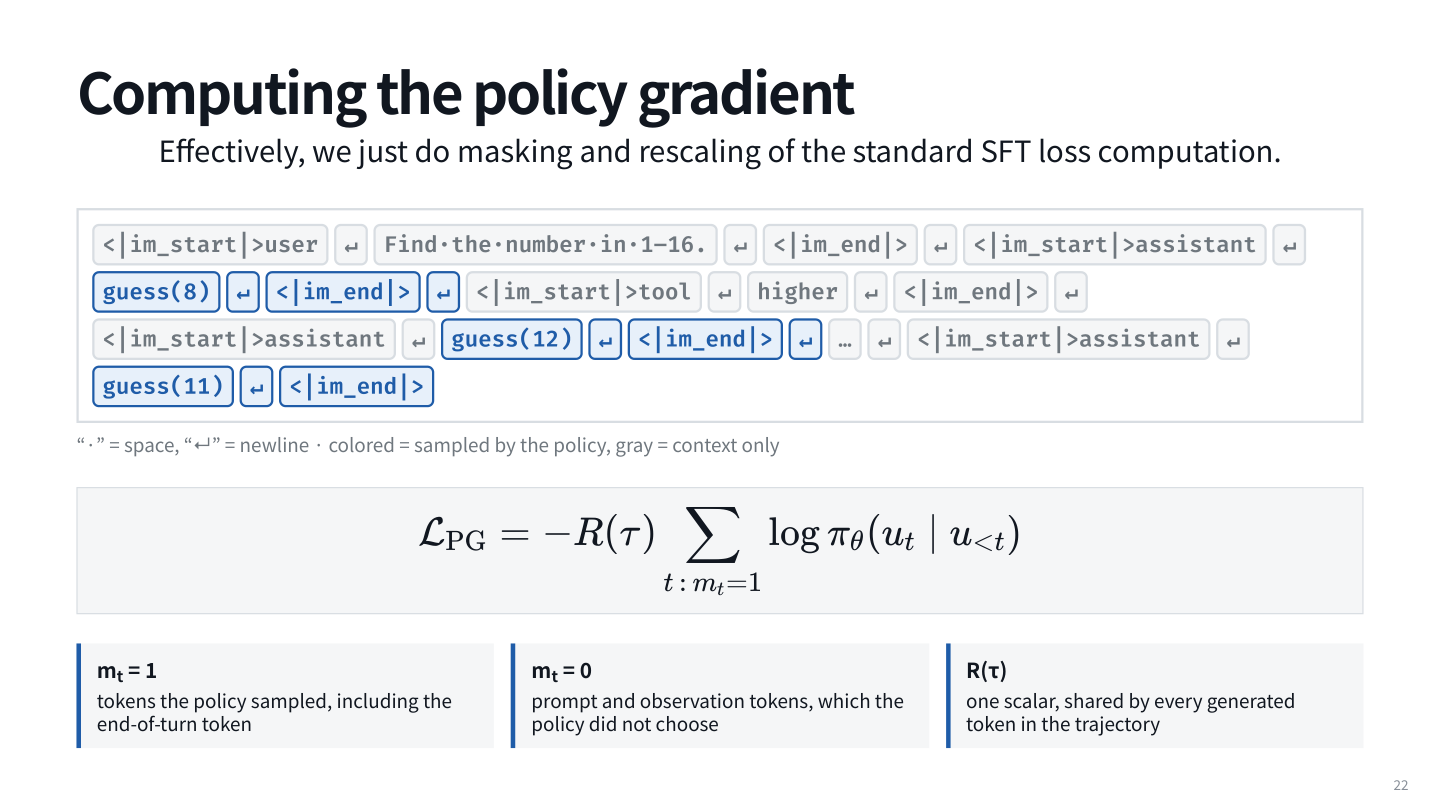
提示和工具观察不是策略选出的动作,不直接计入策略损失;模型生成的结束标记也属于动作。一个轨迹的所有生成 token 可以共享终局奖励。二元奖励下,朴素 REINFORCE 的失败样本权重为零,形式上接近对成功轨迹做 SFT,但数据积累、批次和更新方式仍可能不同。
为什么要减去一个基线
同样成功一次,对于本来很容易和本来很难的状态,其信息价值不同。优势(advantage)表达某动作相对当前策略通常表现的改善:
其中 Q 是采取该动作后继续执行的期望回报,V 是从当前历史按策略执行的期望回报。实际可以用 R(τ)-b(h_t) 估计优势。基线可以是常数、运行奖励均值、学习出的价值函数,或者同任务采样组的均值。
基线只依赖历史、不依赖当前动作时,其引入项的期望为零:
因此可以保持原梯度的期望;选择合适的基线还可以降低估计方差。基线的训练和使用需要与这一条件区分,不能随意令它依赖被采样动作。
两臂 Bandit 的数值例子
课件令 π(A)=σ(θ)=0.25,选择 A 奖励为一,选择 B 奖励为零。没有基线时,采到 A 的梯度为 1×(1−0.25)=0.75;采到 B 为零。令基线为 0.5:
| 动作 | 优势 | 对数概率导数 | 梯度估计 |
|---|---|---|---|
| A | +0.5 | +0.75 | +0.375 |
| B | −0.5 | −0.25 | +0.125 |
两种采样都推动 A 的概率增加,按动作概率加权后的期望梯度仍为 0.1875。课件进一步用抽样演示,两种估计都趋向相同均值,而该基线下波动更小。
终局奖励与信用分配
常数基线能让失败样本有负权重,却没有区分同一轨迹中哪一步更有帮助。若环境提供中间奖励,可以使用 reward-to-go,只将动作之后的奖励用于该动作,减少与它无关的噪声。
猜数字只有最后一次奖励,因此每个动作的 reward-to-go 仍相同。更细的价值估计和逐步信用分配将在高级 RL 课程继续讨论。
GRPO 的组相对优势
对同一任务实例采样多个轨迹,可以用组内表现构造基线。奖励为 [1,1,0,0] 时,均值和标准差都是 0.5,标准化优势为 [1,1,−1,−1]:
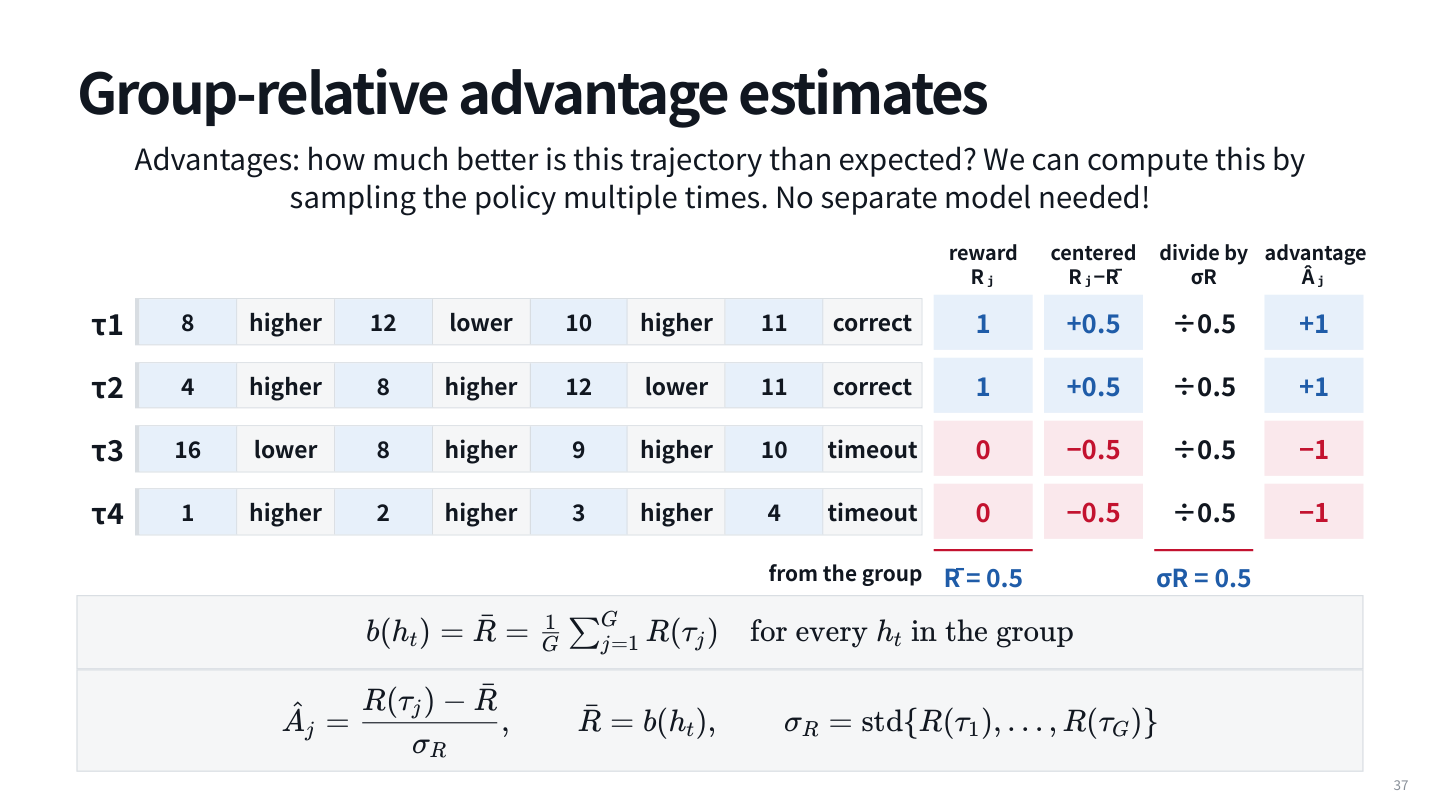
每个任务实例分别归一化,不能把不同隐藏数字的轨迹随意混为一组。课上先用这些权重说明策略梯度;完整 GRPO 的概率比、裁剪和参考模型项留到第 11 讲,本节简式并非完整算法。
DrGRPO 移除组内标准差归一化,并用全局常数替代每条回答的长度除数,以调整任务和 token 的相对权重。长度归一化可能使长错误回答的单 token 惩罚变小;这些变化影响优化目标,不能仅看成代码上的简化。
如果组内全成功或全失败,中心化优势都为零。全失败可能因为太难、缺少探索或奖励不可靠;需要检查原因,再选择任务、示范、探索或更丰富的反馈。GRPO 避免训练独立价值网络,但要付出多轨迹采样成本。
课末将方法放回同一视角:ReST 对成功轨迹赋一、失败赋零;REINFORCE 使用轨迹奖励;GRPO/DrGRPO 使用组相对权重。它们都调整已采样动作的概率,区别在于数据来自哪里,以及怎样给这些动作分配权重。