课程视频
从补全代码到软件开发
第 6 讲由 Graham Neubig 于 2026-09-10 授课。课程先介绍代码模型与功能评测,再转向仓库级定位、编辑和验证,随后讨论训练环境、前端开发、更广的软件任务以及代码世界模型。本文结合视频与官方课件整理。
编程能力可以分为单次写代码、修改多个仓库文件,以及参与完整软件生命周期。智能体由提示、工具和模型共同构成;同一模型接入不同编辑与执行接口,实际效果也可能不同。
代码模型学到了什么
预训练与中期训练
预训练把网页、技术文档、数学、源码、issue 和提交等数据混合,学习代码语法、接口和文字与代码的关系。数据清理需保留缩进、文件边界等结构,同时过滤损坏编码、重复文件、fork 与第三方依赖,并检查来源与评测泄漏。
Tokenization 也影响效率。标识符可能拆成多个 token,空格、换行和缩进需要保留;将常见空白串合并,能减少代码所需 token。课件以 StarCoder 系列说明增加代码训练量的收益,再以 Code Llama 和 Qwen2.5-Coder 讨论代码、文字与数学的配比及长上下文适配。
代码比例并非越高越好。课件中 Qwen2.5-Coder 的对照实验显示,混合文本和数学可能保留更多通用能力,具体取舍由任务与实验决定。仓库级输入还需要把相关文件、路径和跨文件依赖放入连贯序列。
Infilling:利用缺口右侧的代码
InCoder 不只根据左侧续写,还把缺口后面的代码作为条件。例如:
1 | def is_positive(x: int) -> ____: |
右侧函数体为 bool 类型提供证据。训练时用不同 sentinel 标出缺口,把待预测片段移到后面生成;推理时沿相同格式填充。课件对比仅左到右生成、生成后用后缀重排,以及生成时直接使用后缀,说明条件信息如何改变补全结果。
更多训练信号还包括 commit diff、诊断错误、测试结果和执行轨迹。它们分别教会模型根据修改意图编辑、根据报错修复,或者预测程序状态。
怎样评测生成的代码
文本相似不等于行为相同。对于整数 x,x > 0 与 not (x <= 0) 写法不同却等价;x >= 0 只差一个字符,在零处却错误。Exact Match、BLEU、CodeBLEU 和 CodeBERTScore 从文字、结构或表示相似度提供信号,功能正确性仍需要执行检查。
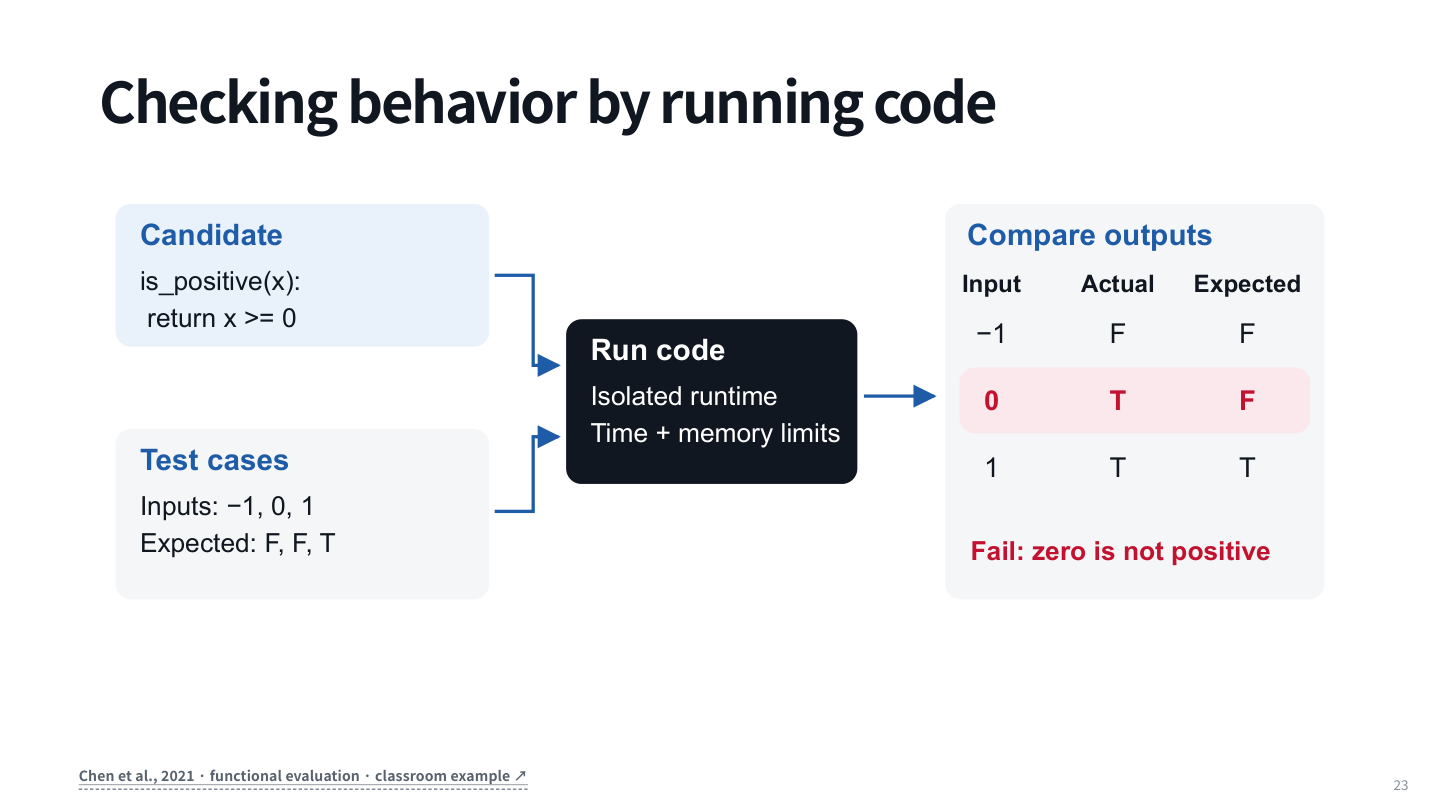
执行检查能接受不同的正确实现,但有限测试可能漏掉错误,需要可信测试、依赖、隔离环境和资源限制。HumanEval 评测函数补全,CodeContests 评测完整程序,pass@k 表达抽样 k 个候选中至少一个通过测试的概率。
当从 n 个样本中观察到 c 个通过时,常用估计为:
它依赖抽样设置,不能把多次尝试的成绩当成单次成功率。非功能要求还包括速度、资源、安全和可维护性,需要对应的运行计时、静态检查或专门评估。
课程随后用 DeepCoder 说明执行奖励:模型生成推理和代码,运行测试产生奖励,再更新策略。1+…+n 的例子展示了算法复杂度和边界条件:循环可能过慢,n*(n+1)//2 有效,而误记为 n*(n-1)//2 在 n=1 就会出错。
仓库级的定位、编辑与验证
从独立题目转向现有仓库后,模型需要搜索实现、修改文件、运行检查,再依据失败修正假设。课堂贯穿使用“重试次数设为零,却变成默认值三”的例子。
1 | # 原实现:零也是 falsy,因此会被默认值覆盖。 |
定位时搜索 retries 并沿调用链追踪值;验证时检查缺失、None、零和正数,而非只重跑最初失败的一例。Agentless 提供另一种固定流程,将定位、修复和筛选阶段预先组织好,说明自适应循环与开发者编排可以服务于同一目标。
工具设计会改变模型的工作方式
Shell-only 工具集可以通过 rg、文件读取、脚本和测试完成任务。专门编辑工具则可写整个文件、做唯一文本替换,或应用 diff。整文件简单但重复;搜索替换较短,却要求匹配无歧义;补丁格式还需要与解析器一致。
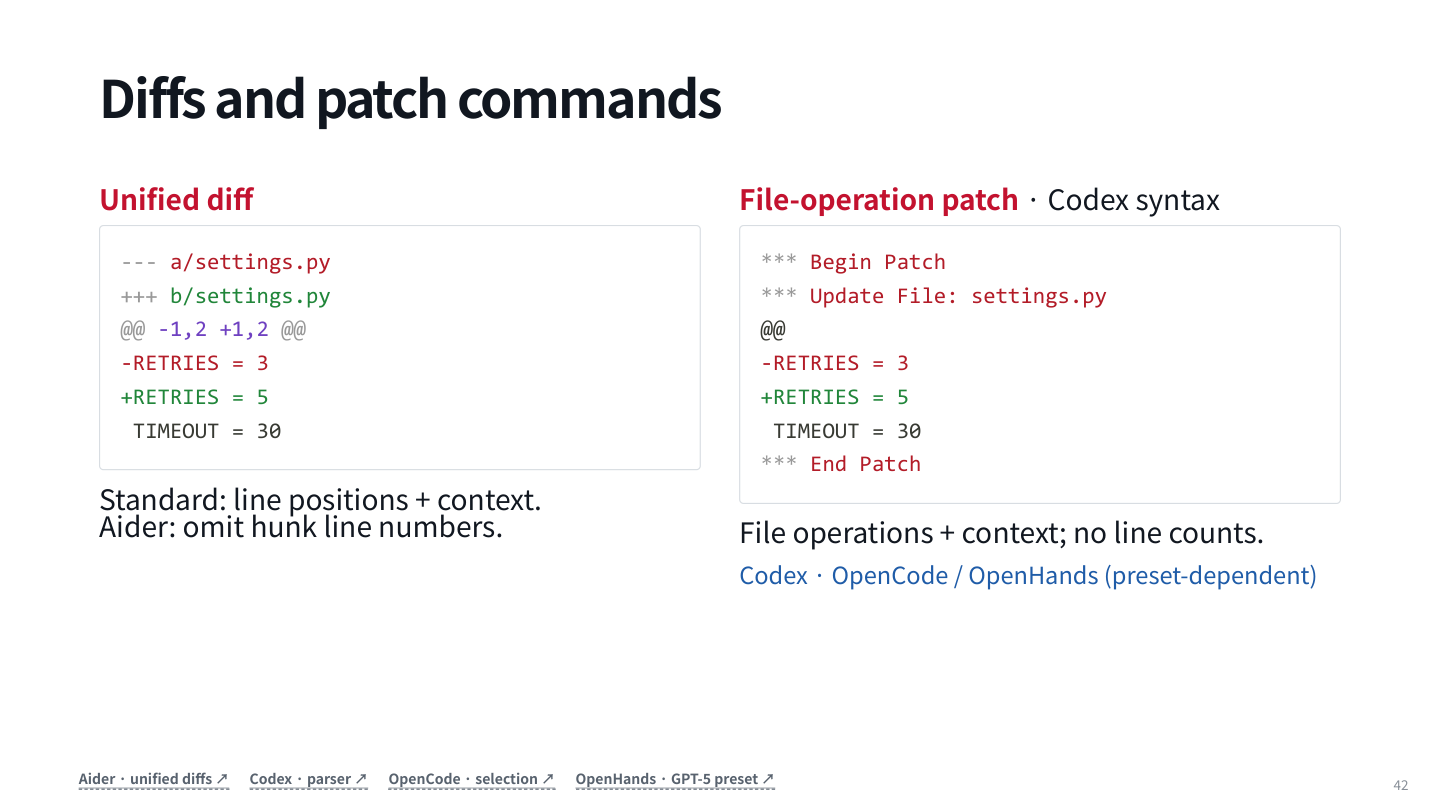
课件引用 Aider 的历史重构实验,同一模型在不同编辑格式下成绩相差明显。这反映接口的重要性,数字只适用于对应的 89 项 Python 重构任务。LocAgent 等方法还利用依赖图检索关联文件,但相关代码最终仍需要执行验证。
编程智能体的评测与训练任务
SWE-bench 把 issue、起始仓库、候选补丁和测试结合起来:fail-to-pass 检查所需修复,pass-to-pass 检查原行为保持。环境能否安装、基线能否运行,必须在收集训练轨迹前确认。
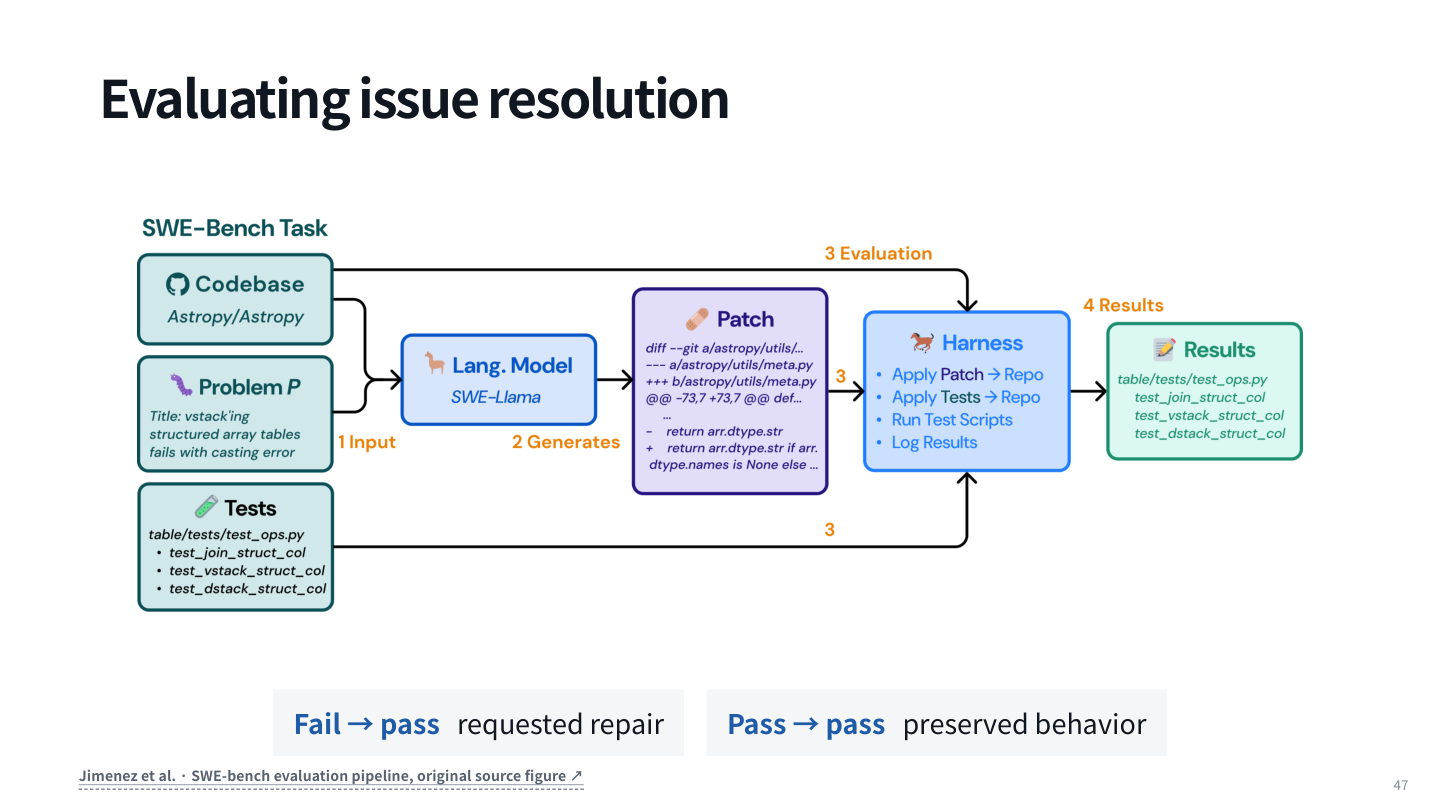
SWE-Gym 和 R2E-Gym 提供可运行环境,终局测试奖励可用于 SFT 或 RL;失败奖励却未必能指出最早错在哪一步。SWE-smith 从正常代码注入缺陷,保留引起新测试失败的变异,再确认恢复原实现后测试通过,从而构造可验证任务。
训练还可覆盖多语言和多 Harness。Python、TypeScript 和 Rust 需要不同构建工具,应先读项目配置。相同模型在多个 Harness 中训练时,动作、提示和上下文策略会变化,不能只转换最终补丁。
前端开发要同时检查行为和画面
前端工作把代码循环连接到浏览器:找到组件和事件处理器,修改逻辑或样式,再输入、点击并检查页面状态。浏览器智能体逐步选择动作;自动化脚本则把确定的操作和断言固定下来,两者用途不同。
课件的空白姓名例子把 value.length 改成 value.trim().length。行为检查确认全空格输入被拒绝、没有新建记录、有效名字仍能保存;视觉检查确认错误文字出现在输入框旁且可读。截图有助于定位界面问题,但图像相似度未必就是任务评分规则。
更广的软件工程任务
编写代码只是工作的一部分。需求、评审、发布、监控和后续维护,都有自己的产物与验收方式。课程依次介绍:
| 任务 | 评测关注点 |
|---|---|
| 故障定位 | 文件、模块和函数的位置是否正确 |
| 应用创建与扩展 | 人工编写的浏览器测试计划 |
| 库实现 | 包级测试,或与参考可执行程序比较 |
| 连续维护 | 多个相关里程碑及回归 |
| 测试生成 | 测试能否区分缺陷版与修复版 |
| CI 修复 | 安装、构建及要求的检查能否通过 |
课件以 Node 版本不满足依赖要求说明 CI 修复需要有因果关系的修改。SWE-Playground 和 Hybrid-Gym 则扩展练习任务,研究跨开发任务的迁移。评估迁移时应保留新仓库、新任务及一致的推理预算。
模型能否预测代码执行结果
课程最后区分策略与世界模型:策略决定下一步做什么;世界模型预测执行某动作后会看见什么。两者都利用历史,但输出对象不同。
1 | items = [1] |
如果模型把别名误判为拷贝,预测就会出错。用这样的预测筛选修复,可能把正确候选排除、错误候选保留。因此,代码世界模型是否有用,要同时测量预测误差、最终任务成功率,以及节省的真实执行、token 和时间;不确定时回退到实际运行,也需要明确阈值。