基准进步怎样对应真实工作
本页对应 2026-10-27 的 Agents and the Future of Work,讲者为 Zora Wang。以下按官方课件《AI Agents for Human Work》顺序整理。截至 2026-11-08,提供的收藏中尚无本讲录像,本文不记录未经核对的课堂问答。
课件先展示智能体在软件任务和计算机操作上的进步,再用真实工作评测提出反问:高榜单成绩是否意味着能完成职业中的完整任务?当前研究较集中于计算机和数学活动,人类工作却还包括协作、规范、组织流程和个人偏好。
课件中的任务时长趋势来自 METR 特定研究,不等同于所有职业自动化能力按固定周期增长。自主完成的模型排名,也未必等同于与人协作时的排名。理解工作变化,需要同时看任务范围、成功标准和使用方式。
环境、任务与评测三个组成部分
从哪里收集职业任务
O*NET 将职业描述为任务集合。GDPval 请有行业经验的专业人员构造任务;Remote Labor Index 从自由职业项目补充远程市场与长尾工作;JobBench 则把“人希望自动化什么”纳入选择。
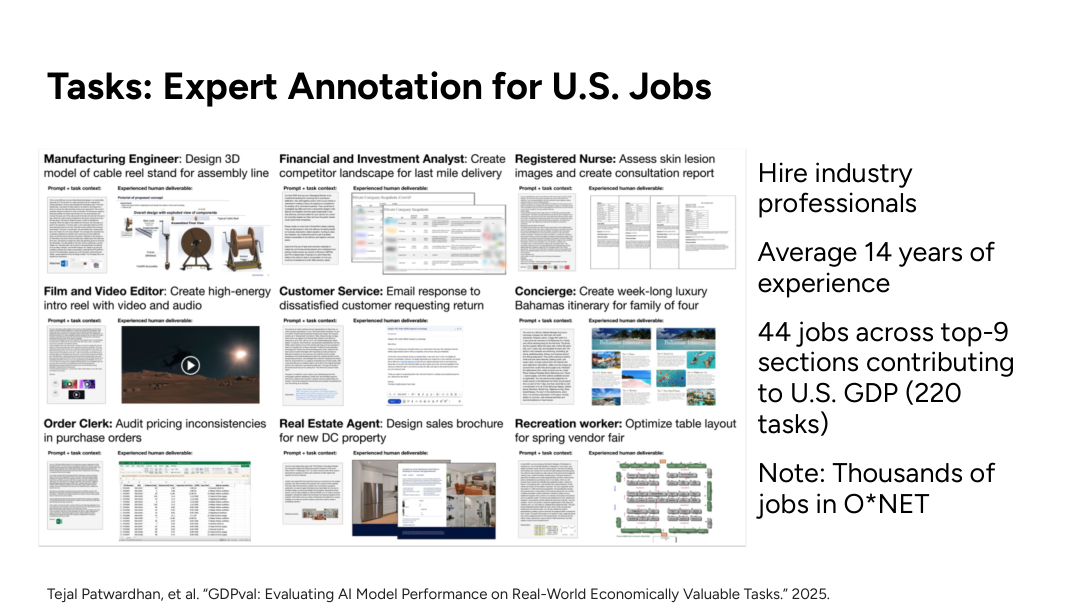
收集人的操作轨迹可以还原真实活动,但不一定直接揭示意图,还涉及隐私。通过 agent 探索环境自动合成任务能扩大训练数据,却需要检查生成任务是否仍与真实工作相关。课件也提醒,一些基准没有包含现实中的限制,容易高估可部署能力。
环境需要软件,也需要数据
TheAgentCompany 用可复现的开源软件模拟企业工作;Gym-Anything 自动部署不同软件;Terminal-Bench 则把任务组织为文件和命令行环境。光能启动应用还不够,邮件、项目、文档和干扰数据共同决定任务的真实性与难度。
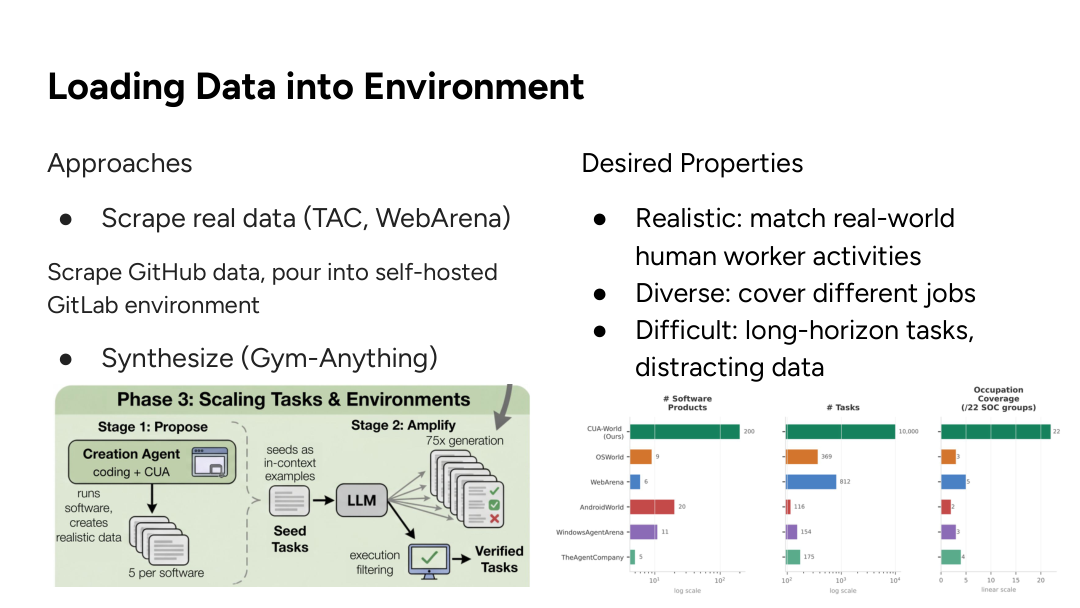
真实软件访问、授权和真实数据往往受限,开源替代与合成数据各有分布差异。构造环境时应明确保留了哪些职业特征、简化了哪些流程,不能只按应用数量判断覆盖面。
开放工作怎样评价
从修复 GitHub issue、数据清理,到室内设计,工作位于“可执行验证—开放判断”的连续谱上。规则检查适合确定输出,却难以完整评价语义、审美和领域要求。
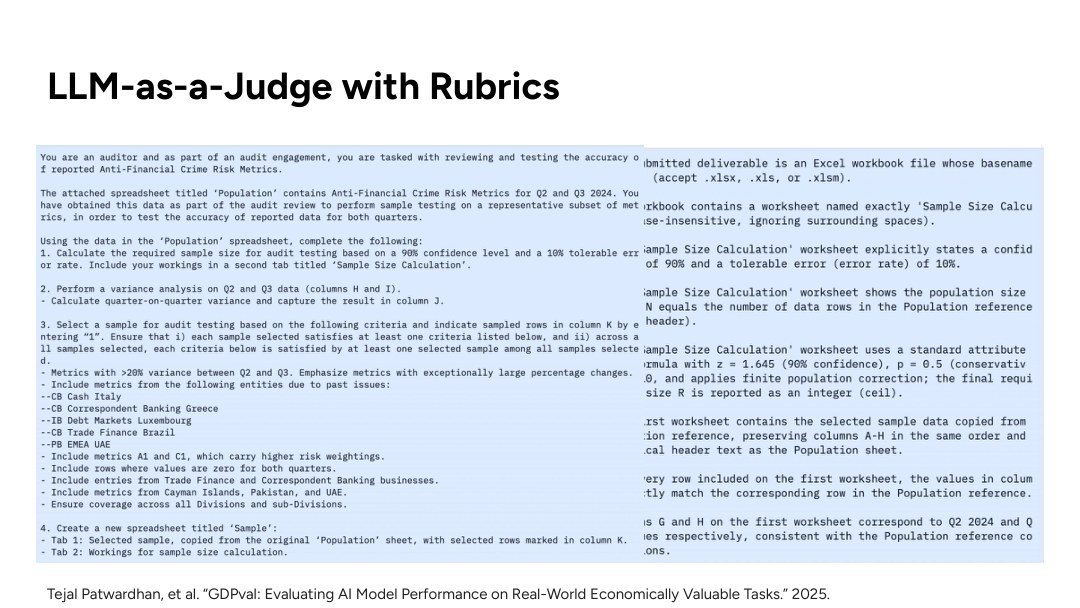
专家 rubric 将目标拆成具体要求,再由人或模型判定。模型生成 rubric 可以扩展规模;根据轨迹对比或人机交互修订规则,又能持续提供反馈。但模型 judge 存在偏好、随机性和视觉判断局限,rubric 也可能依赖用户和模型,无法一次写到完美。
静态基准还面临污染、饱和、漂移与成本。新的任务和动态更新有助于维持区分度,也让跨时间比较更难。分数变化需要连同环境、评判器和任务版本解释。
有能力之后,怎样与人一起工作
课件随后从自主能力转向协作。人可能在不同任务中选择让系统自动完成、共同执行或只提供辅助;CowPilot 等系统允许执行中接管和纠正,也有研究训练 agent 识别人机交互模式与自主程度。
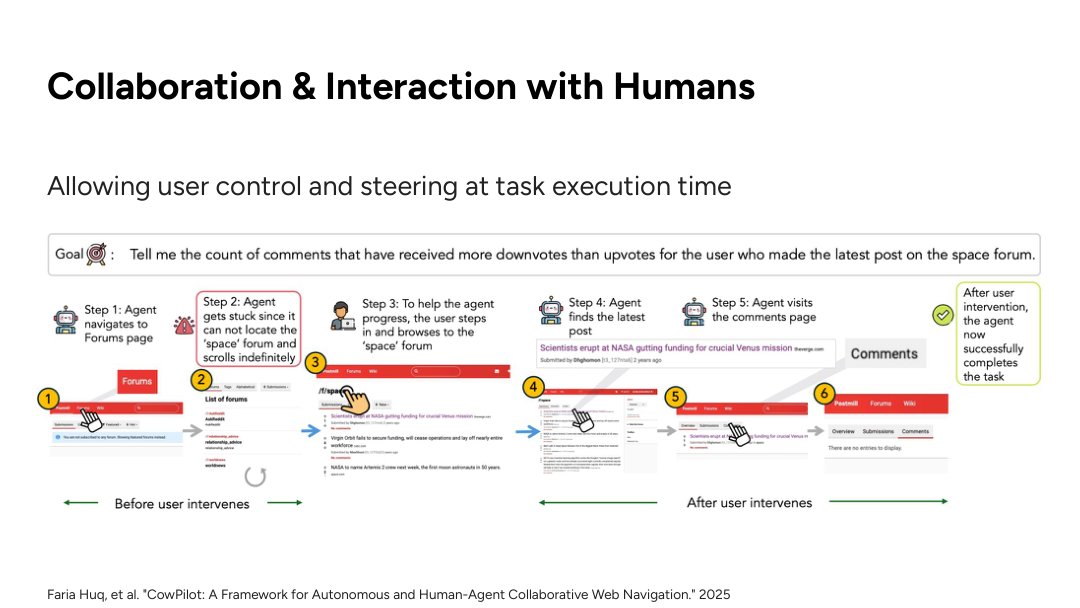
独立完成的评测遗漏了澄清、理解新要求和适应工作流的能力。效率也不能只看“有人替我执行”:冗余调用、多 agent 通信、等待和结果复核仍消耗资源与注意力。
隐私、安全和组织规范需要在真实交互中持续发现。工作还有意义与乐趣,一项任务可以被自动化,并不表示参与者愿意完全交出去;自动化偏好应成为设计输入。
工作变化的范围与不确定性
最后几页讨论劳动市场。课件引用职业暴露研究,描述哪些任务可能受影响;“暴露”表示技术可能改变任务,不直接等于已经失业或岗位将被整体替代。
工作不是固定不变的任务清单。自动化可能替代部分劳动,也可能产生新任务和需求。不同收入、职业及职业阶段承受的影响可能不同,早期职业者尤其需要关注学习路径:原本帮助积累经验的任务若被移交给系统,人如何继续发展判断能力?
这使课程问题回到系统设计:除了提高完成率,还要决定人在哪些位置参与、如何理解和纠正产物,以及如何保留学习和选择的空间。这里的趋势和比例均属于课件引用研究的范围,不能直接作为个人就业预测。