课程视频
将交互轨迹变成模型行为
第 8 讲由 Yueqi Song 于 2026-09-17 授课。课程以 SWE-Gym 的任务记录开场,依次讨论轨迹序列化、监督范围、数据选择、统一表示、训练运行和部署评估。本文按视频与官方课件整理。
一条编程轨迹包含系统提示、issue、模型的推理与工具调用、执行返回的观察,以及最后提交。监督微调(Supervised Fine-Tuning,SFT)通过更新权重,让模型更可能在相似历史下生成示范中的动作。与上下文和外部记忆相比,权重更新可以影响之后的每次调用,但需要训练,变化也不易直接查看或迁移。
SFT 不只学习成功解法,还会学习调用格式、等待工具结果、长任务行为和数据中的冗余评论。它常作为 RL 的冷启动,让模型具备足以探索的初始能力;课件也讨论 R1-Zero 跳过 SFT 的尝试,以及后续重新加入少量高质量数据的原因。
轨迹怎样成为一个 Token 序列
Chat template 将消息角色、推理、调用和观察渲染成一个序列,角色与消息边界由对应标记表达。训练器最终看到的是 token 和监督掩码,不再直接处理抽象的“用户轮次”。
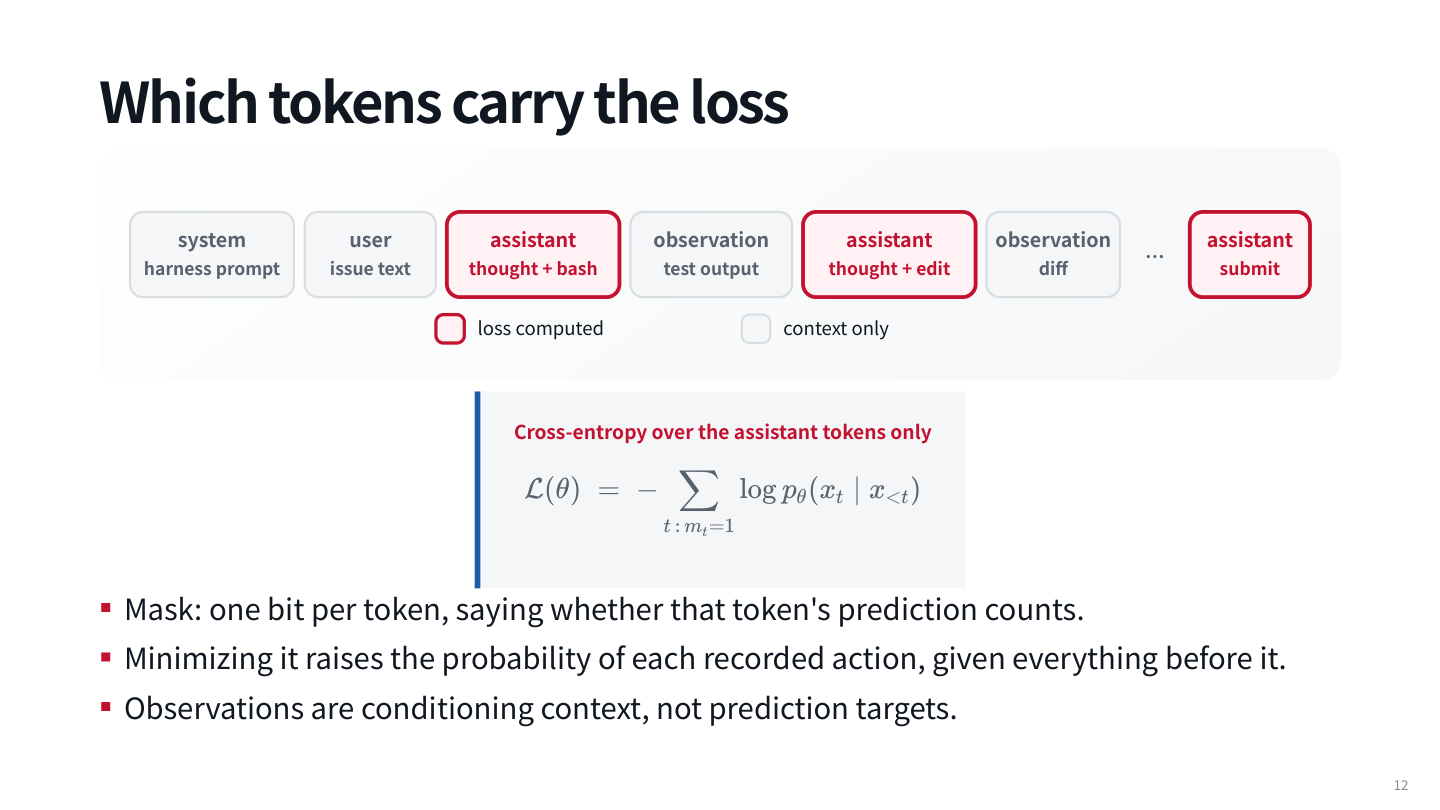
常见做法只对 assistant 生成的 token 计算交叉熵:
m_t=1 表示模型需要学习生成该 token,用户输入和工具观察通常为零。观察仍参与上下文计算,只是不直接作为预测目标。否则模型可能学习编造工具输出,而不是等待环境返回。
模板渲染时记录 assistant 字符区间,再转换到 token 位置以构造掩码。不同框架的配置名称和实现不同,不能只看到一个“assistant only”开关就认定所有边界正确。
结束标记与推理块
推理时由服务端提供的角色头不需要模型重新生成;模型自己产生的结束标记则要纳入监督。结束当前消息、交接工具和完成任务可能使用不同标记,必须与实际模板一致。
推理块有两个独立决定:是否留在上下文中,以及是否对它计算损失。保留它可以解释后续动作,监督它还会让模型学习相应推理风格。长推理可能在损失中压过短工具调用,BalanceSFT 等工作因而研究重加权和难例重采样。
课件还提醒,按轨迹条数配平不等于按 token 配平。少量很长的代码或 STEM 轨迹,可能占去大部分训练 token;同时应统计总 token 与有效监督 token。
应该选择哪些轨迹
强模型产生数据、筛选通过验证的轨迹,是常见蒸馏路径。当前模型自己采样,再用成功轨迹训练并反复执行,则连接到下一讲的 expert iteration。
SWE-Gym 用较强教师得到 491 条通过仓库测试的轨迹,微调 32B 学生后改善了对应评测。课程随后区分两种扩展:对同一任务多采样,以及引入更多不同任务。前者可能增加可用解法,后者增加任务覆盖,不能只用“数据条数”解释收益。
通过测试的过程也可能不适合模仿
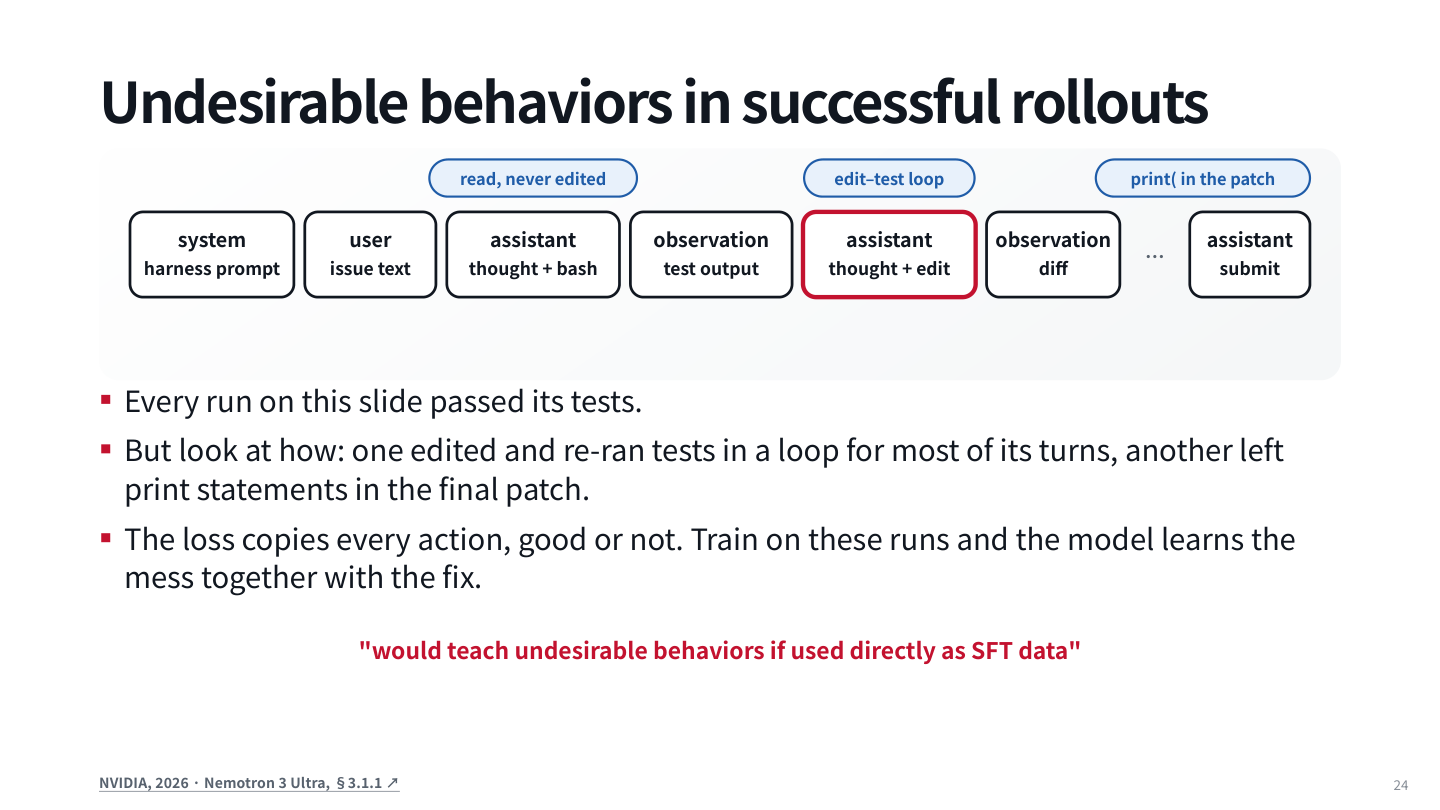
成功执行中可能包含长时间编辑—测试循环、无效重复,或者最终补丁里的调试打印。SFT 会提高其中每个被监督动作的概率,因此只过滤终局失败还不够。
OpenThoughts-Agent 的实验比较了轨迹形状、教师和任务来源。一个简单最少轮数过滤器在其设置下有帮助,却也会丢掉四轮完成的干净修复、保留四十轮的混乱过程。最强教师的独立榜单成绩,也未必产生最好的学生。应直接比较学生部署后的表现。
课堂让学生讨论三条轨迹:四轮成功;犯错后发现并恢复;十一次无变化尝试后成功。这个问题同时涉及保留哪条轨迹,以及保留后对哪些动作计算损失。恢复能力有价值,重复无效行为则可能被一并学走。
多种数据怎样进入一个训练流程
不同数据集保存 HTML、可访问性树、截图和动作的方式不同。如果每个数据集都为每种 Harness 写转换器,组合数量会快速增长。Agent Data Protocol(ADP)先把数据转成统一的有类型动作与观察,再为目标 Harness 渲染。
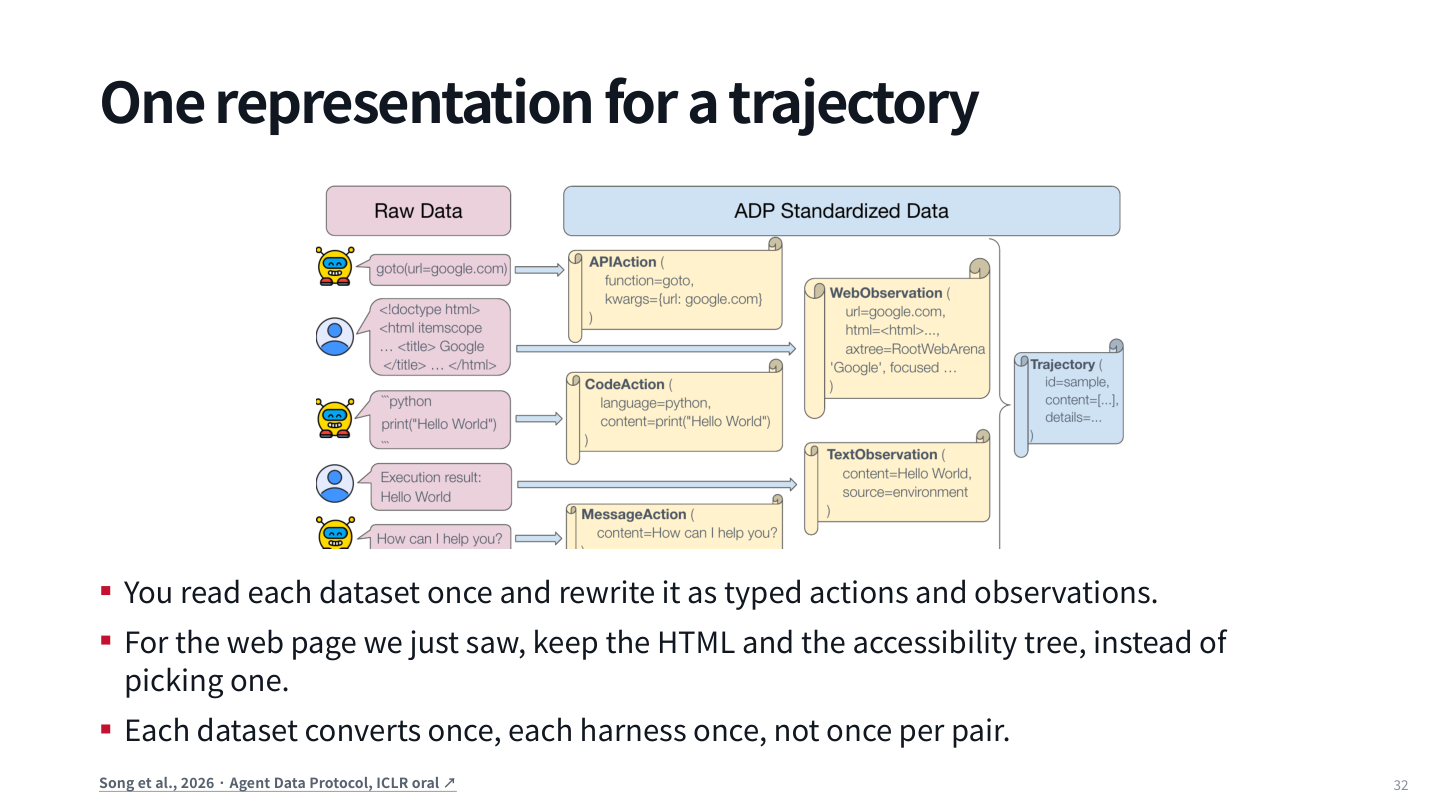
统一表示应保留原始信息,例如同一页面的 HTML 与可访问性树;最终仍要适配目标 Harness 的动作、系统提示、上下文策略和结束方式。转换完需验证调用可解析、观察与调用对应,以及历史结束合法。
课件中的跨任务实验显示,多领域混合可能超过对应的单领域数据,但收益依赖数据组合和设置。统一格式降低工程成本,并不自动使所有混合都有益。
训练时的长序列与模板一致性
课程展示真实训练配方,比较长序列、批大小、学习率和分阶段高质量子集。它们用于理解训练规模,不能直接作为任意模型的默认参数。MoE 在较窄 SFT 数据上还可能出现少数 expert 接收大部分 token 的路由失衡,需要专门观察和处理。
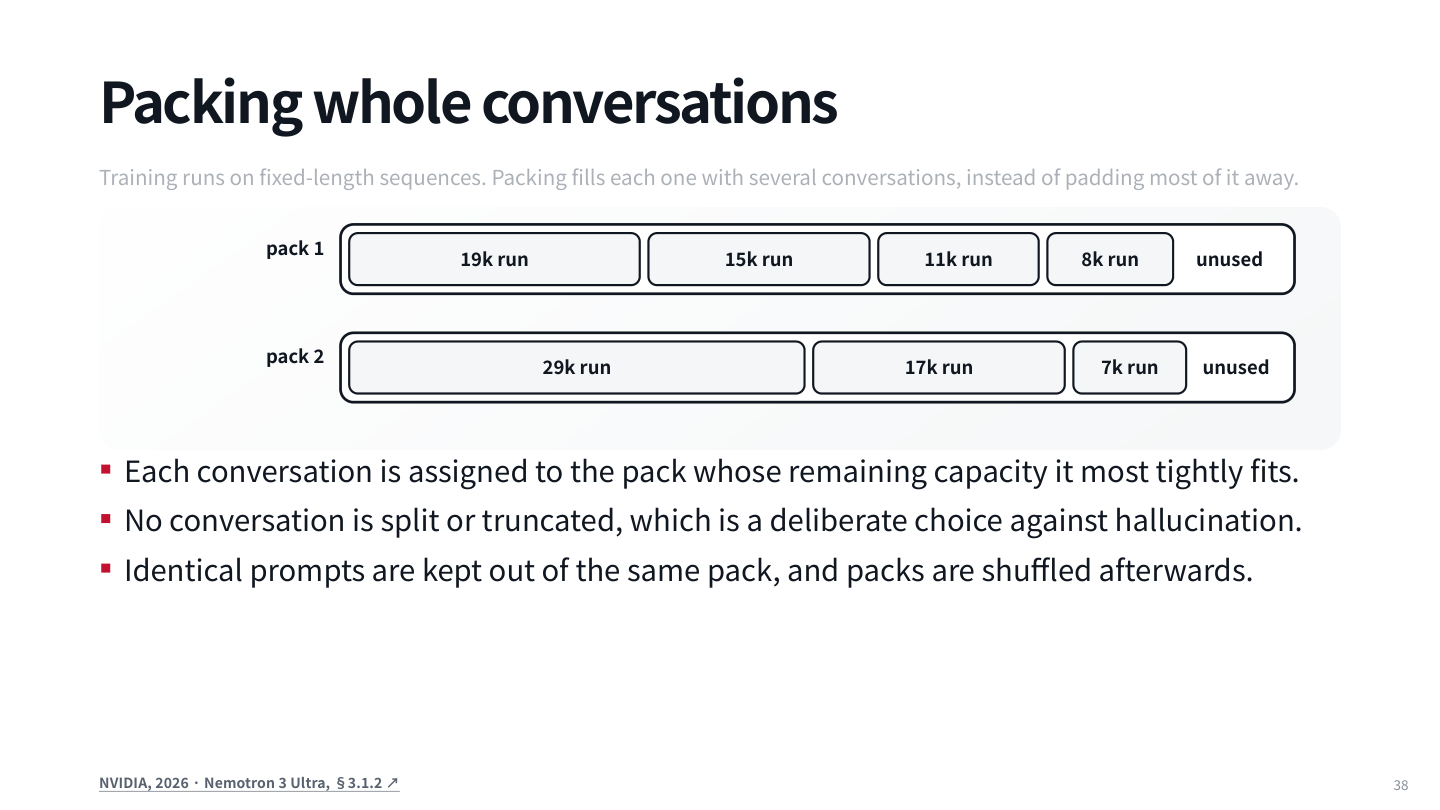
Packing 将多个完整会话放进固定长度序列,减少 padding。课件中的策略不拆分和截断会话,还避免把相同提示放在同一个 pack。相互独立的会话需要正确的边界与注意力处理,不能因为拼接后更满就引入串扰。
模板漂移是另一类隐蔽问题。向历史追加工具消息后,条件模板可能改变前面 assistant 的推理块,导致训练看到的序列与采样时不同。模板、空白、特殊标记和停止条件都需要一致;可以将同一历史在不同阶段渲染后逐 token 对照。
怎样确认模型真的学会了
先尝试过拟合少量样本。若二十条数据上的损失都降不下去,应先检查格式、掩码和训练管线。随后在目标 Harness 中运行新任务,使用可验证结果评估。
训练损失低并不意味着自主运行成功:示范中每一步都沿正确历史继续,部署后一次不同编辑就可能产生从未见过的状态。这是行为克隆的分布偏移问题。评测还应把同一任务的所有运行放在同一侧;若声称迁移到新仓库,应按仓库划分,并检查污染。
课程最后把 SFT 交给 RL:前者提供可模仿的行为与格式,后者让模型在自己实际到达的状态下,依据任务结果继续改进。两者的衔接仍依赖可靠环境与奖励。