课程视频
从一次查找到多轮研究
第 10 讲由 Akari Asai 于 2026-09-24 授课。课程依次讨论深度研究任务、评测、模型训练和检索。本文结合视频和官方课件整理;课件包含逐步展开的动画页,图片引用均使用 PDF 页序。
“Akari Asai 在 CMU 的办公室号码是多少?”通常一次查找即可回答。另一个问题——“智能体能否像人类专家一样综合科学文献?”——则需要寻找直接对照实验、理解任务设置,再限定结论。只比较不同 AI 系统,不能直接推出它们与人类专家持平。
课堂用 OpenScholar 和 DR Tulu 相关研究串联搜索、读取和综合。最终回答既要报告已有证据,也要指出尚未被证明的范围。深度研究的工作对象是多个来源之间的证据关系,搜索次数只是过程统计。
怎样评测深度研究
搜索难度与专业知识
传统短问答可能一次查到答案,也可能直接从参数记忆作答,难以测出多轮调查能力。BrowseComp 从已知答案反向设计问题,把名字隐藏在多个事实线索中,并通过模型和人工检查筛选难题。
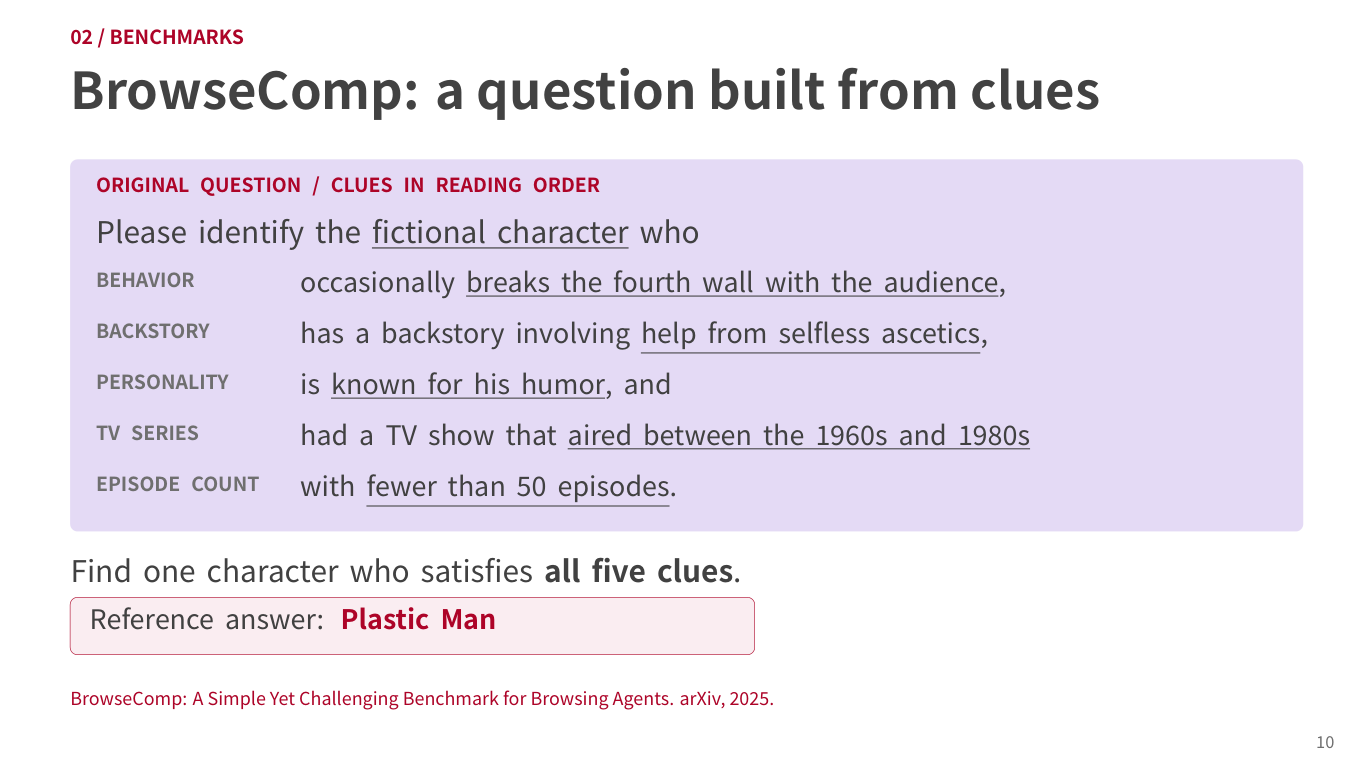
课堂例子需要同时满足打破第四面墙、背景、幽默性格、播出年代及集数等线索,参考答案是 Plastic Man。只命中其中一条并不够。BrowseComp-Plus 则固定文档集合,人工核验支持线索的片段,再加入相关却缺少关键条件的困难负例,便于在相同语料上比较搜索方法。
领域评测进一步加入专业知识。FinSearchComp 从金融工作和可核验表格出题,再由其他专家独立求解;MedBrowseComp、ScholarSearch 和 AutoResearchBench 分别覆盖医学和文献搜索。搜索复杂度、领域能力与回答质量需要分别检查。
长答案为什么需要 Rubric
两个正确综述可以用完全不同的措辞;几乎相同的两句话,也可能只因把“尚未证明”改成“已经证明”而结论相反。ROUGE 或语义相似度不足以判定这些差异。
ScholarQABench 使用专家 rubric,将回答拆成可检查要求并加权。课件的简化例子中,“报告与人类专家的直接比较”权重为二,“限定任务与领域范围”权重为一。回答满足前者却声称结论适用于所有领域,得分为 2/3。
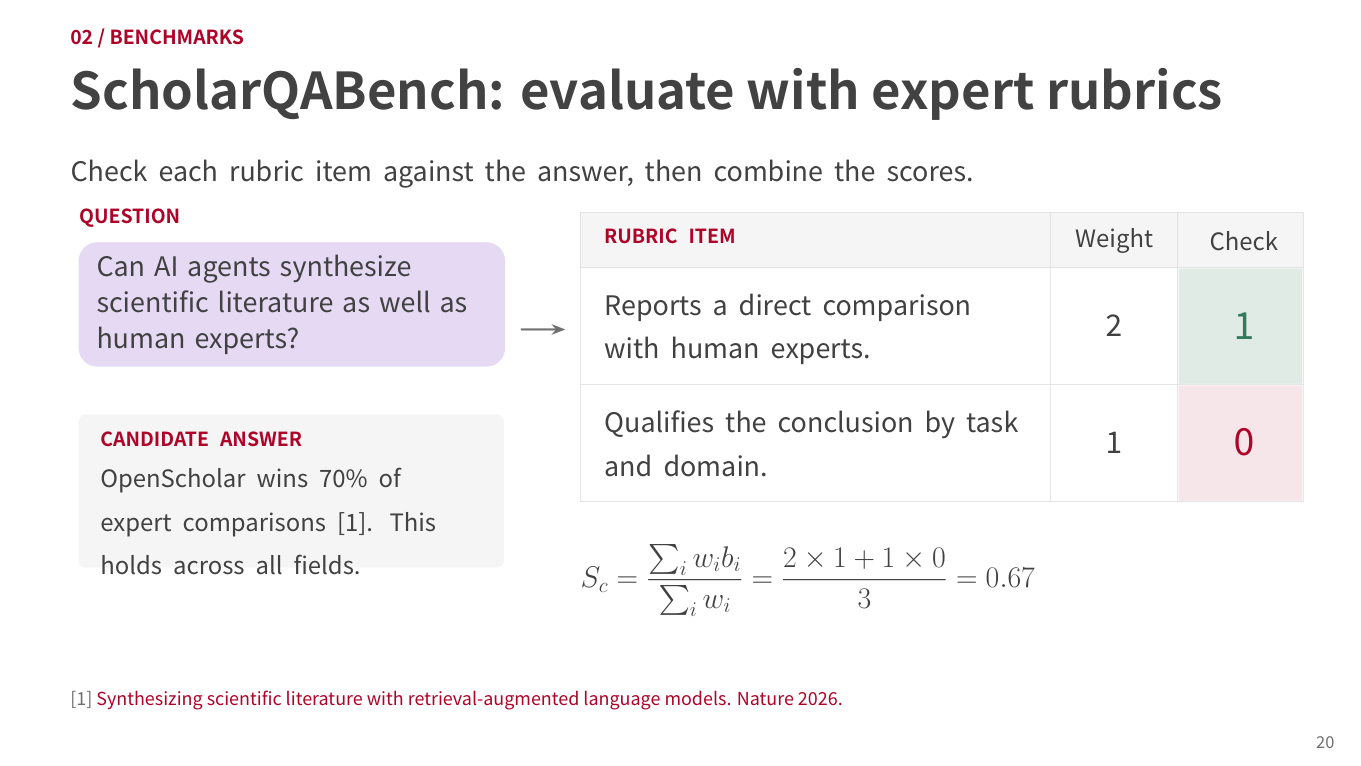
模型评判需要与人工对照。ResearchQA 用综述挖掘问题和 rubric,扩大了规模,但专家审计也发现空泛、错误或不清楚的条目。评价答案之前,先检查评分规则本身是否有来源、相关且可验证。
引用存在不代表支持结论
DeepResearch Bench 的 FACT 从回答中提取“主张—URL”对,读取引用页面,再判断是否支持主张。“论文比较过专家答案”与“所有领域都超过专家”可以指向同一篇论文,却只有前者获得支持。
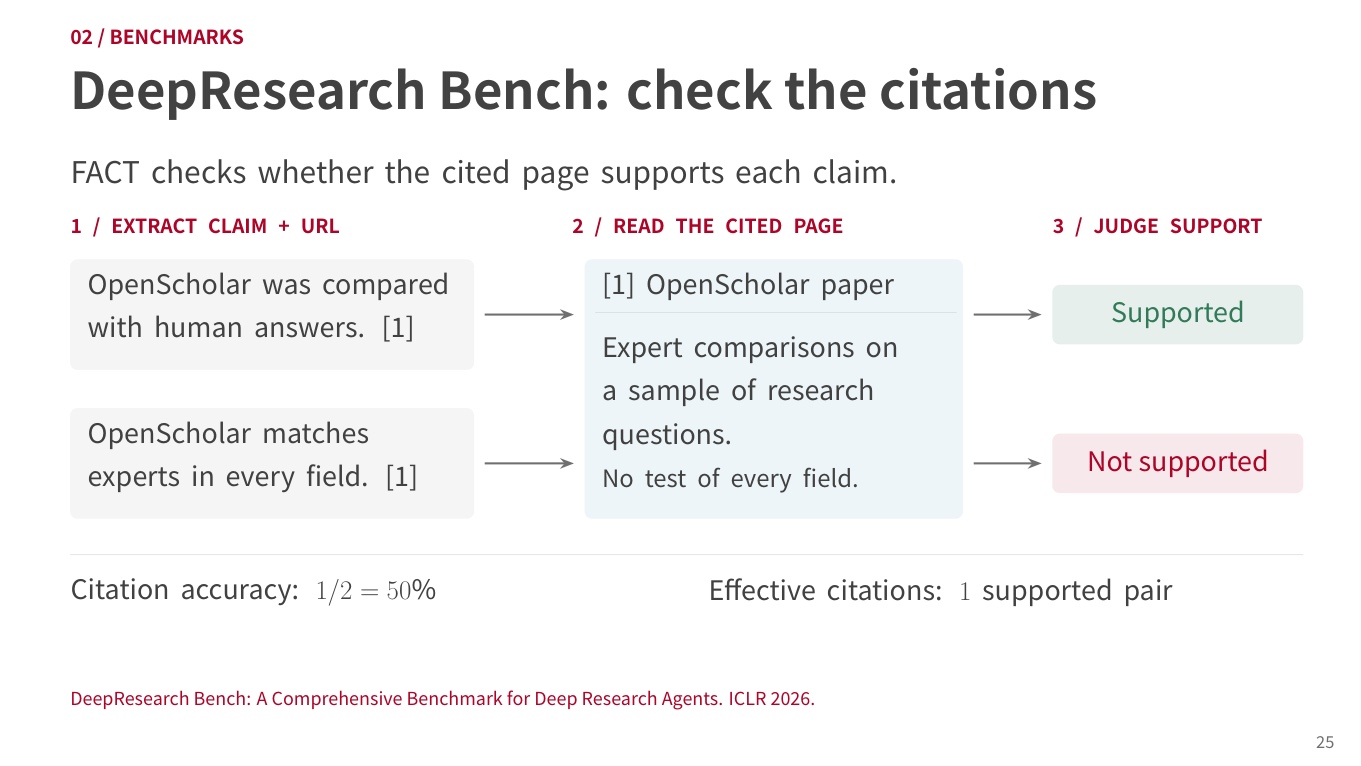
课件例子两个引用对中一个受支持,引用准确率为 50%。引用数量、有效引用数量与引用准确率是不同口径;一个网页真实存在,也不能证明它支持旁边的句子。
模型怎样学习搜索与综合
模型输入包含任务、已有推理、工具调用和返回文本。搜索结果加入历史后,模型可以继续生成新查询、打开页面或回答。课件先展示这一推理循环,再介绍中期训练、SFT 与 RL 的衔接。
构造问题与示范
WebSailor-V2 等方法可以从事实和关系反向构造问题。课堂例子围绕 Allen Newell、Herbert Simon、合著书籍、图灵奖和诺贝尔奖建立线索,隐藏目标姓名后生成多跳问题。已知目标有助于验证结果,但题目各线索仍需核实且应一致。
教师采样后,筛选正确答案、合法格式和连贯轨迹,再用于 SFT。Agentic mid-training 将轨迹与一般预训练数据混合,提前让模型熟悉交互行为。不同初始化与同一后续 SFT 数据的对照,可以帮助区分中期训练的收益。
从可验证答案到开放报告奖励
短答案任务可以用参考答案计算奖励。对同一问题采样多个轨迹,GRPO 提高组内较好尝试的概率,并通过概率比、裁剪和参考约束控制更新。搜索和网页读取耗时不同,异步采样可以让完成的轨迹先评分、组装批次,再交给训练端。
开放综述没有唯一字符串答案。DR Tulu 用 coverage、relevance、factuality 和 citation support 等要求构成评分规则,并根据采样回答及检索证据修订 rubric,让训练继续获得区分信号。
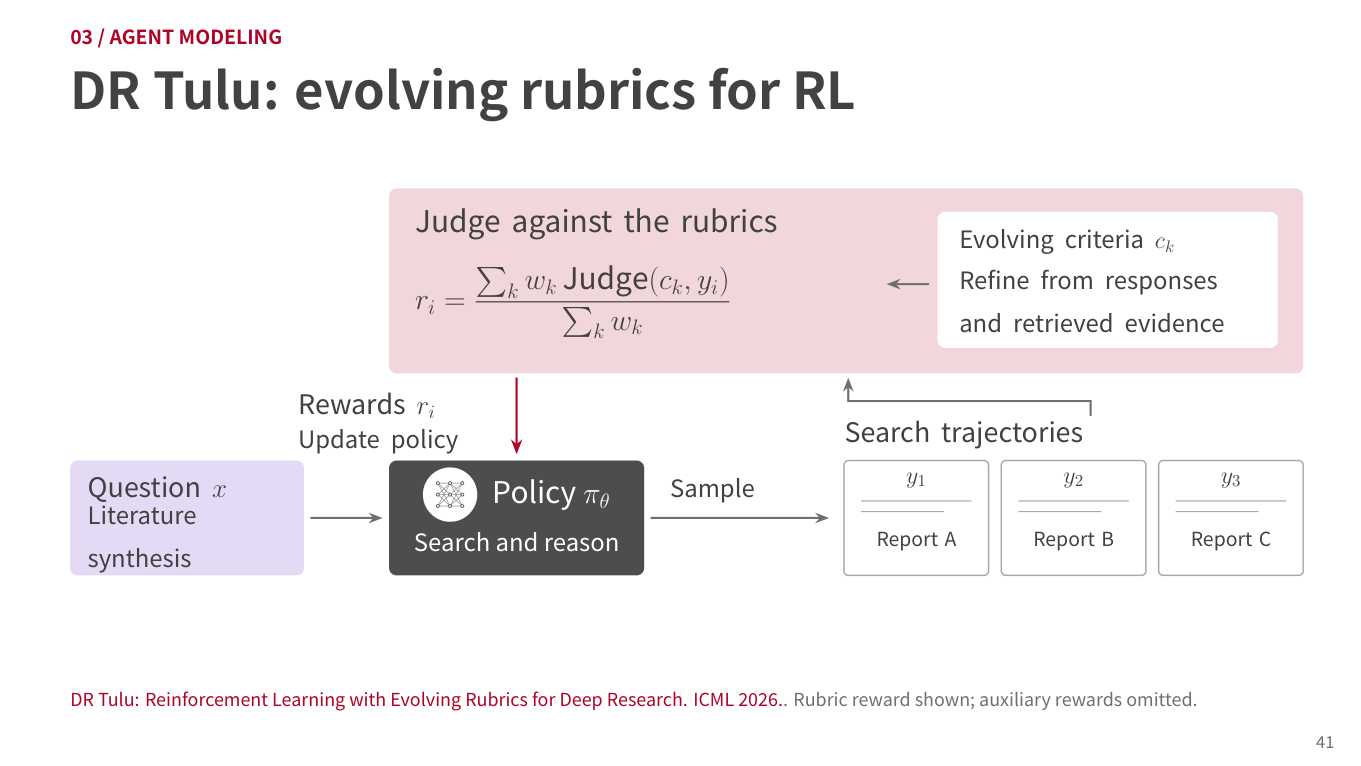
课件对比无 SFT、较少 SFT 和完整 SFT 的 RL 起点,以及初始 rubric 与演化 rubric 的训练效果。这里的评分来自指定基准,奖励随训练上升不等于所有研究场景都改善。动态 rubric 同样需要审计,避免把错误或偏好固化进奖励。
检索器是否理解当前研究步骤
最后一部分从搜索工具下钻到检索模型。BM25、embedding 检索、网页搜索 API、浏览工具和学术搜索覆盖不同信息源。Dense retrieval 为文档编码并建立向量索引,用查询向量检索相近证据;对比训练提高正例相似度、降低负例相似度。
深度研究存在一个额外问题:模型掌握原问题、历史查询和已有发现,检索器却可能只看到当前一句查询。查询相同,当前需要补齐的证据也可能不同。
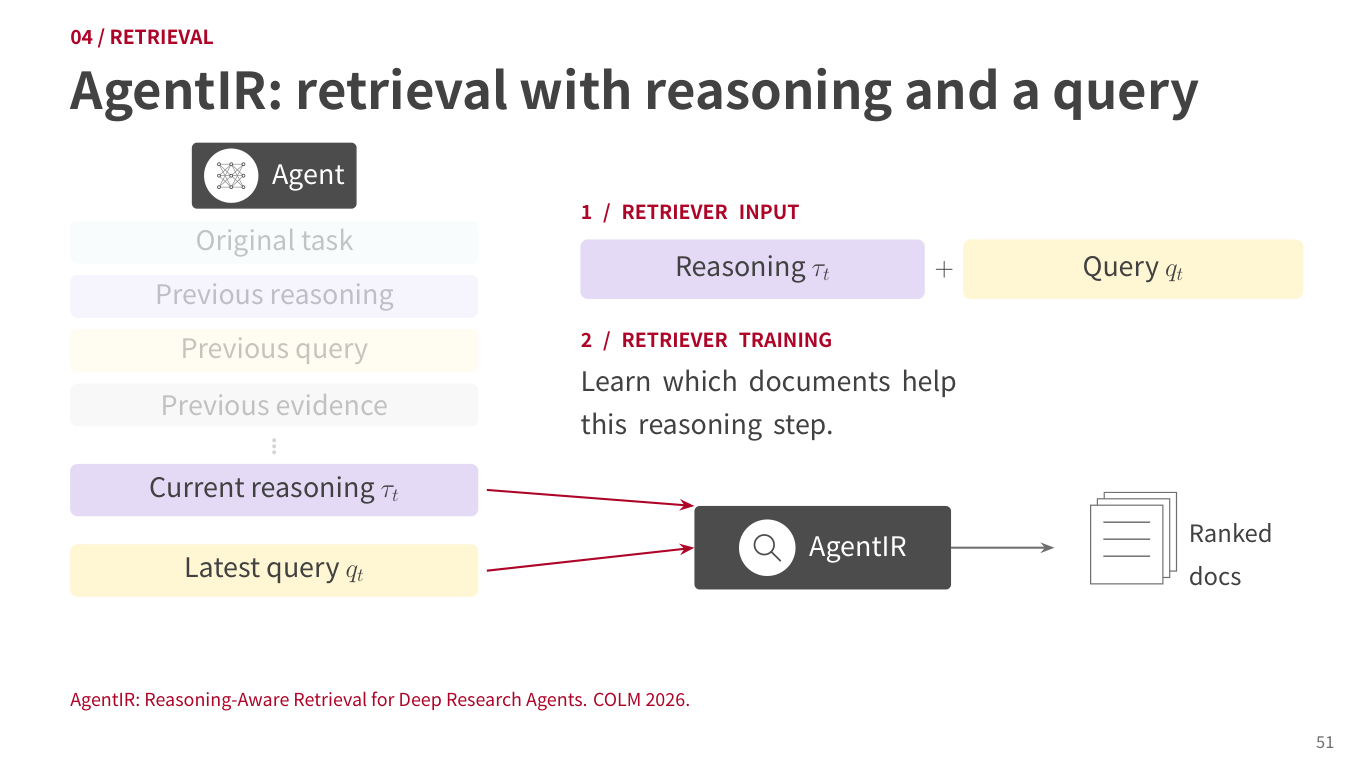
AgentIR 同时使用当前推理和查询,并通过 DR-Synth 构造中间搜索步骤的相关性标签。全局问题的相关文档,不一定正好帮助当前步骤,因此需要局部训练信号。
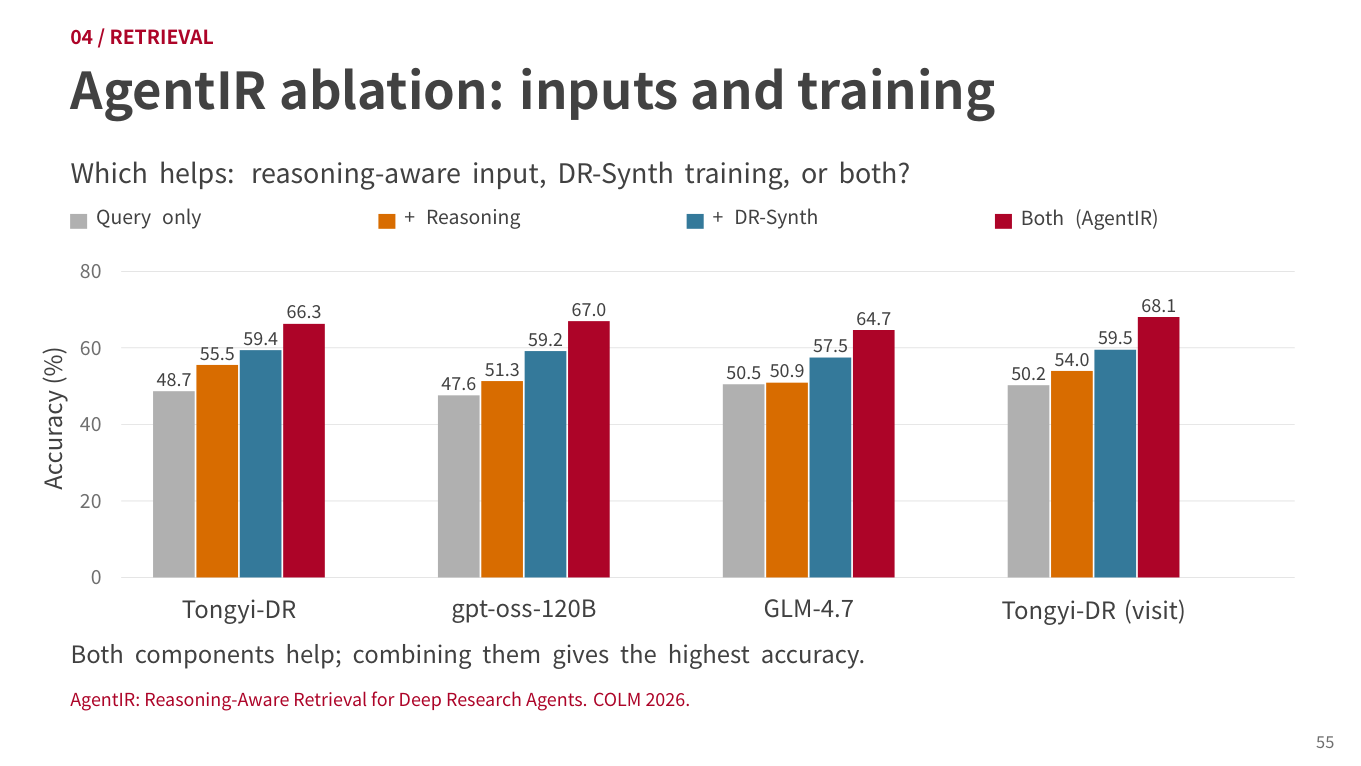
课件消融将输入与训练数据分开:只加推理、只换 DR-Synth,以及两者结合。以 Tongyi-DR 设置为例,准确率从查询基线的 48.7%,变为加推理的 55.5%、换数据的 59.4%,组合后为 66.3%。这些是该固定评测下的结果。
继续加入全部旧文档并不一定更好,课件中的当前推理输入反而更有用。检索输入需要表达此刻的信息缺口,而非单纯复制更多历史。
课堂问答还提醒评测污染:智能体可能搜到公开数据集中的题目和答案。需要检查检索轨迹、限制直接暴露的评测来源,并使用新的问题或固定语料验证;最终答对不能独自证明模型完成了预期研究过程。