课程视频
一次 RL 更新需要哪些系统操作
第 12 讲由 Apurva Gandhi 于 2026-10-01 授课。课程先拆解推理与训练两类负载,再介绍智能体轨迹特有的问题,最后比较系统架构。本文按视频与官方课件整理。
一次策略更新需要采样动作、与环境交互、计算奖励、重新计算带梯度的对数概率、反向传播、优化参数,并将新权重同步给推理端。看起来可以全部写成普通 PyTorch 循环,实际却包含两种差异很大的工作负载。
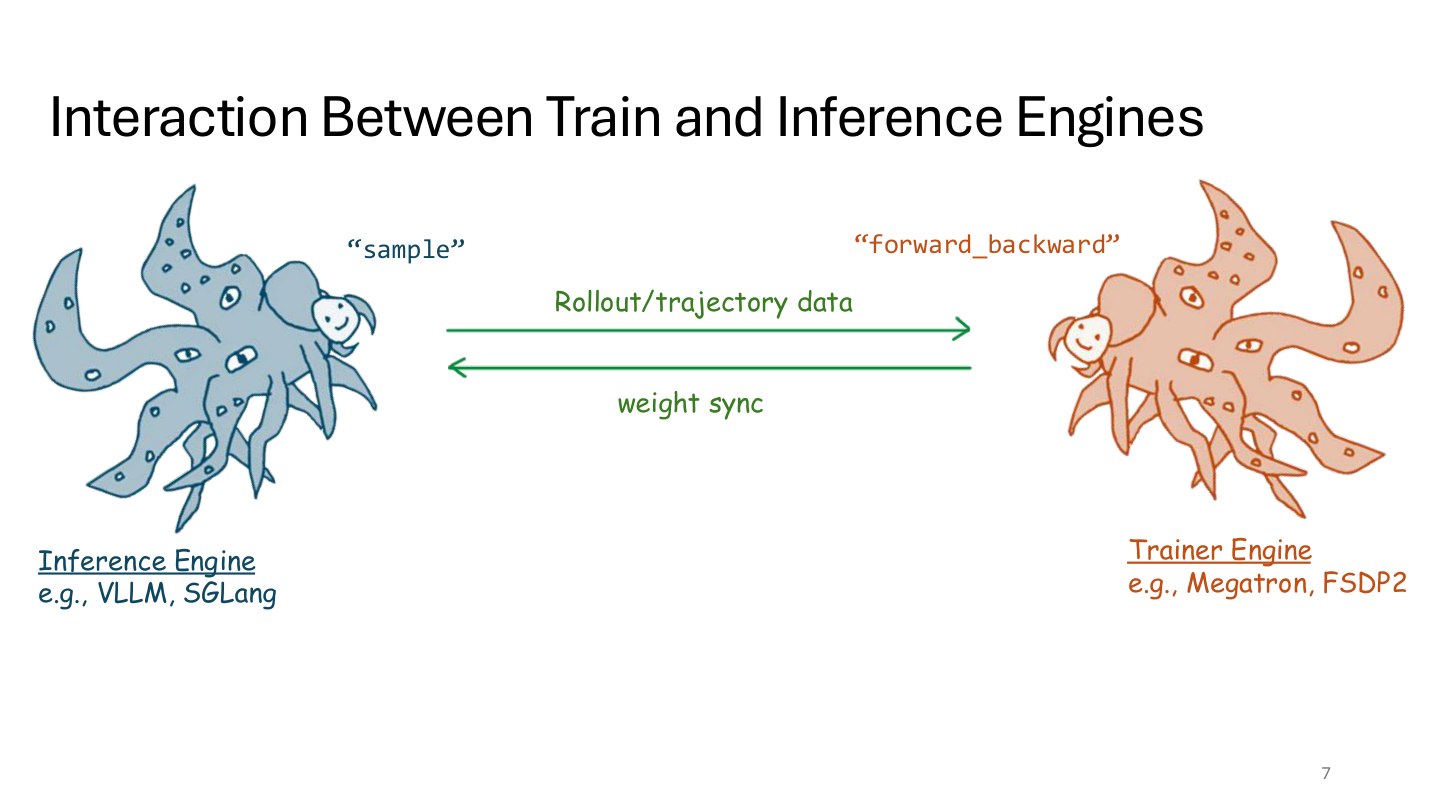
推理端主要进行顺序 decode,无须梯度,重点是 KV、前缀缓存和连续批处理;训练端同时处理已有序列,执行 autograd,重点是参数分片、激活内存、序列装箱和前缀共享。vLLM、SGLang 与 Megatron、FSDP 等分别服务于这些需求,二者之间还需交换权重与轨迹。
推理端如何减少重复工作
KV cache 用内存换重复计算。课件以 Llama-3-8B 的 bf16 KV 为例,每 token 约 128KB,一条 32K 轨迹约 4GB,64 条约 256GB。该数字依赖层数、KV 头数、维度和精度,不能直接套到其他模型。
组采样共享任务提示,多轮交互又共享旧历史,因此前缀缓存对 agent RL 特别有用。连续批处理让结束的序列立即退出,排队请求接替空位;chunked prefill 或 prefill/decode 分离可减轻长输入对 decode 延迟的干扰。
推测解码让便宜的 drafter 提议多个 token,策略模型并行验证;正确的拒绝采样可以保持策略分布。RL 中策略不断变化,冻结 drafter 的接受率可能下降,因此还要考虑在线更新 drafter 的成本。
训练端如何使用显存和计算
Activation checkpointing 只保留必要输入,反向传播时重新计算中间激活。课件用整层重算说明约增加一次 forward 的代价;实际增幅取决于选择性重算范围及实现。
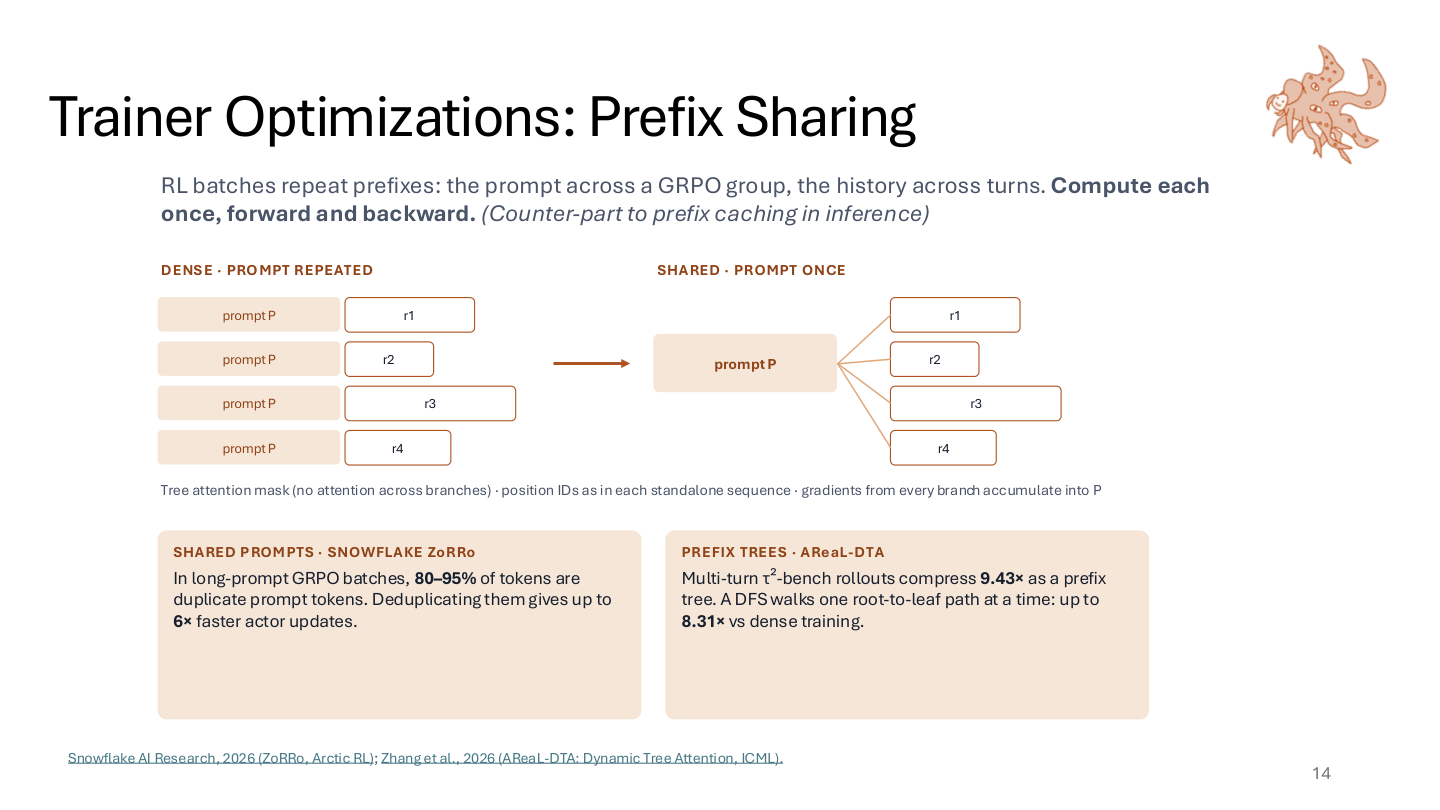
训练前缀共享与推理缓存的目标相似,但必须正确累积各分支梯度。树状注意力掩码阻止不同分支互相看到,位置 ID 保持与独立序列一致。课件引用的加速来自特定长提示和多轮设置,应同时看重复比例与真实端到端时间。
张量、流水线、专家、数据和上下文并行分别拆分不同对象。训练与推理的并行布局可能不同,同步权重时需要重新分片。Delta weight sync 可以只传变化部分,但其收益依赖参数表示精度和实际变化比例。
MoE 还可能因数值细微差异选择不同 expert。R3 记录采样时的路由选择,再在训练中回放,以减少训练与推理的路径不一致;这要求推理引擎传回相应信息。
智能体轨迹的几个特殊问题
Sequence Extension
若新一轮输入是上一轮提示与输出的精确扩展,可以把整条轨迹拼成一个训练样本,只在模型生成处计算损失。若每两轮压缩历史,新的摘要会改变前缀,后续片段通常必须成为另一个样本,重复计算部分上下文。
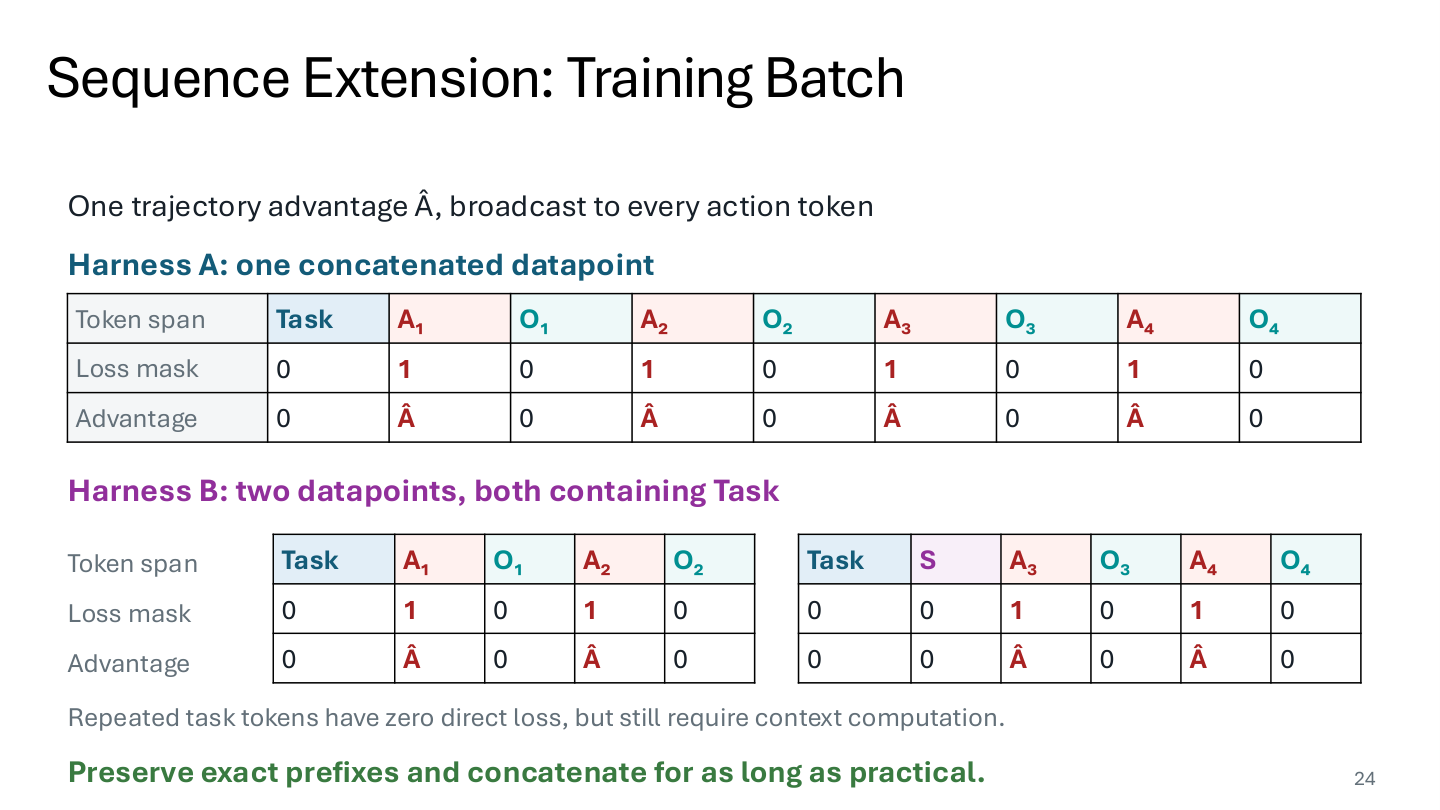
重复任务 token 即使没有直接损失,仍有上下文计算成本。聊天模板若移除旧推理块,也可能破坏 extension;需要检查实际 token 前缀,而非仅比较消息列表长度。
Token-In, Token-Out
只存字符串再渲染,可能因空白、模板或重新分词改变采样时的 token。TITO 尽量在 token 层记录和传输输入输出、采样 logprob 与损失范围,保证学习器优化的正是当时采样的序列。文本可读日志和训练事实记录可以并存,二者职责不同。
异步与复杂 Harness
异步系统让 rollout 与 learner 重叠,但要控制旧策略程度,并支持运行中的权重更新。长轨迹可能使系统主要受采样限制,GPU 配比应按实际负载调整,课件示例比例并非固定规则。
子智能体、递归调用与上下文压缩进一步改变轨迹结构。系统需要识别每次模型调用的来源、输入、参数版本和结果,再决定哪些部分进入训练,而不能假设所有 Harness 都是一条简单 append-only 对话。
框架怎样连接不同 Harness
一个方案是为每个 Harness 重写 rollout;另一种是在中间提供兼容推理 API 的代理,记录 token、概率和路由信息,让现有 Harness 通过代理采样。后者减少重复适配,但仍需要保证 API 语义与轨迹信息完整。
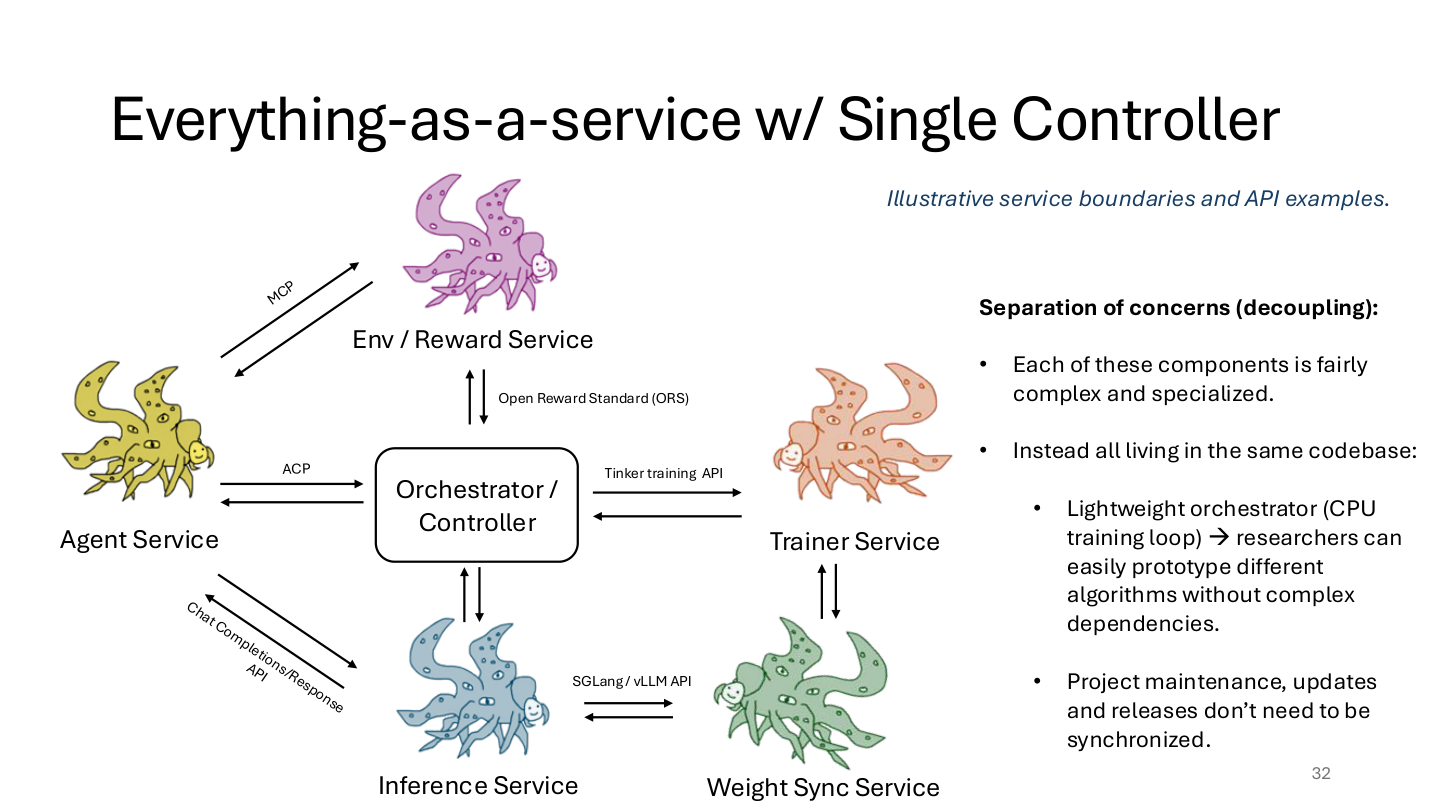
SPMD 用同一个程序控制各 GPU rank,边界直接但部署较紧。服务化架构将推理、训练、环境、奖励和权重同步拆开,由轻量控制器编排,便于替换实现、弹性扩容、跨集群及异构硬件。服务边界也增加通信、版本和故障恢复成本。
后半段还介绍多策略、部署后在线 RL,以及多租户 LoRA:不同用户共享底层资源,但每次训练与采样需要关联自己的适配器检查点。Tinker 的训练客户端与采样客户端分离,体现了这类接口设计。
用哪些指标定位瓶颈
附录把算法质量与系统性能放到同一张表:训练及留出集 reward、pass@1、pass@k、熵、最大 importance weight、梯度范数、平均旧策略程度、训练 MFU,以及 rollout、更新、等待和总耗时。
训练 reward 上涨而留出集下降,需要检查奖励捷径;pass@1 上升但 pass@k 下降,可能说明覆盖和多样性收缩;概率比尖峰可能来自旧数据或实现不一致;等待时间增加则提示采样或调度跟不上。仅提高训练 GPU 利用率,未必减少完整任务的训练时间。