课程视频
B 站高清观看:11 - Lecture 11 - Unnesting Queries
本页截图取自上方 B 站课程录像,标注时间可跳回对应位置;图中细字可配合文末的高清课件查看。正文里的教学数据与原课示例分别说明。
子查询的逻辑调用与物理执行
第 11 讲研究查询去嵌套(Unnesting)与去相关(Decorrelation)。SQL 可以让内层查询引用外层行,逻辑上就像把外层列作为参数传入一次函数调用。优化器希望把这种依赖转换成可批量处理的关系运算。
先通过 2015 年的 Unnesting Arbitrary Queries理解代数去相关的基础,再阅读本讲指定的 2025 年论文。以下 SQL 是围绕这些机制编写的教学示例。
1 | SELECT s.name, s.major |
外层每次传入专业,内层返回该专业最高分。这个逻辑定义允许每行调用内层查询,实际系统也可以缓存相同专业的结果,或把整个查询改写成聚合加 Join。
相比之下,SELECT MAX(score) FROM students 没有外层引用,是非相关子查询,逻辑上能够计算一次再复用。识别相关性需要完成名字绑定:同名列到底属于内层表还是外层表,直接决定是否存在依赖。
先看一个能够展开的例子
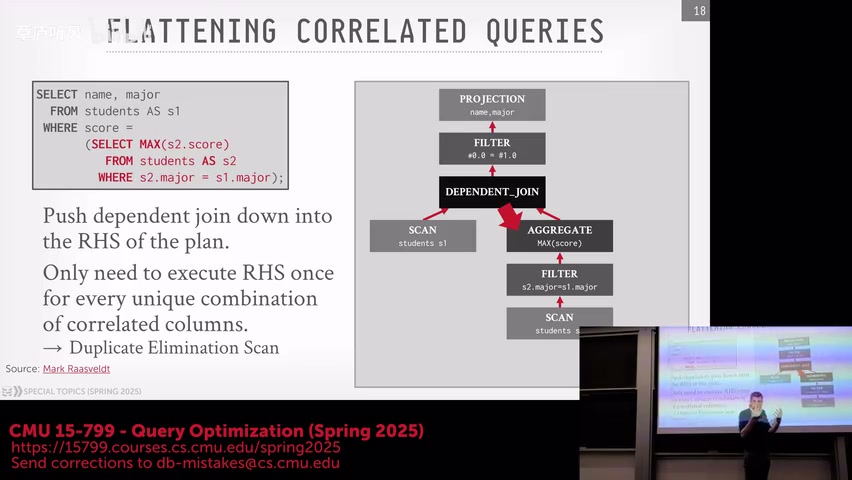
视频 43:00:依赖连接的下推方向与参数域去重。最高分示例的红色箭头标出依赖连接继续向内侧推进的方向。课件提出按 correlated columns 的不同组合计算内侧,并使用 Duplicate Elimination Scan 形成参数域。这里需要区分参数域去重和最终结果的重复行。正文 SQL 用聚合加 Join 表达相同目标,并单独检查 NULL 专业。
假设专业与分数采用普通 SQL 等值比较,前面的查询可以写成:
1 | SELECT s.name, s.major |
内层先按专业得到一行最大值,再与所有学生连接。某个专业有两位同分最高的学生,两人都应保留;原查询输出重复行时,改写也应保留对应重复。
如果专业为 NULL,原查询的 t.major = s.major 无法匹配任何行,MAX 返回 NULL,分数比较无法通过过滤。改写后的普通等值 Join 同样不匹配这个专业,结果一致。这个推导依赖当前谓词和使用位置,不能把它直接推广到所有相关聚合。
EXISTS 为什么对应半连接
1 | SELECT c.id |
存在性判断只回答有没有匹配。半连接(Semi Join)保留外侧符合条件的行,每个外侧行的重复次数由外侧本身决定。普通内连接会按订单数量复制客户行。
人为给客户 1 放入两笔订单:原查询只输出客户 1 一次,普通 Join 输出两次。如果在普通 Join 上随手加 DISTINCT,又可能消除外表原有的合法重复。因此规则应明确表达存在性,而非事后猜测怎样去重。
NOT IN 与 NOT EXISTS 的空值语义
假设子查询集合为 {1, NULL},外侧值为 2。2 NOT IN (1, NULL) 的结果为 UNKNOWN,在 WHERE 中被排除;相关 NOT EXISTS 判断是否存在等于 2 的行,没有匹配就保留。
把 NOT IN 改写成反连接(Anti Join)时,需要证明相关列不含 NULL,或采用保留空值语义的实现。若 IN 的结果出现在 SELECT 列表里,TRUE、FALSE、UNKNOWN 都可能被观察,Mark Join 一类表示还需要记录比较结果状态。
Dependent Join 怎样表达依赖
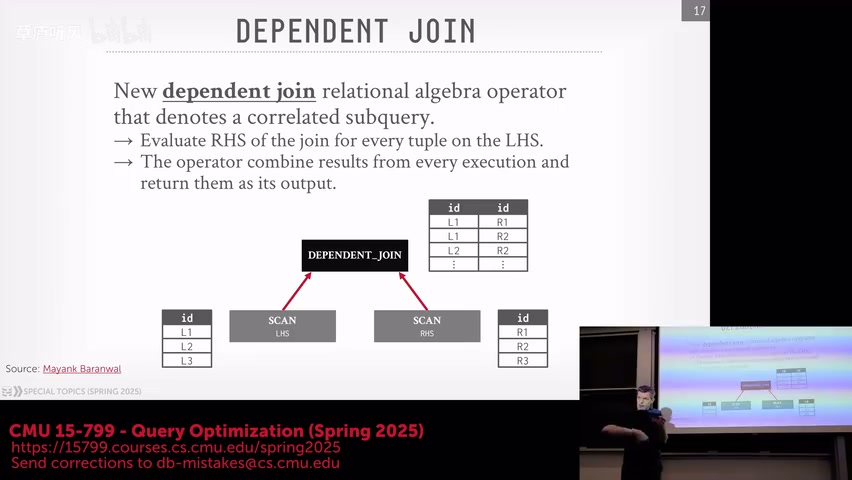
视频 35:30:Dependent Join 的参数传递。左侧输入提供参数,右侧子计划引用它;输出保留每次绑定与对应结果。它先把 SQL 相关性显式转成逻辑算子,再通过代数改写消除依赖。这里的概念与本文参数域 D 一起使用:D 可以减少相同参数重复计算,原外层行仍需正确恢复。
Dependent Join(依赖连接)把外层依赖显式放到逻辑计划中:右侧查询引用左侧提供的列,按左侧输入的绑定计算右侧结果。这样去相关可以在关系代数上进行,而无需针对每种 SQL 文本格式单独设计规则。
2015 年方法的重要步骤,是抽取外侧相关列的去重组合,形成参数域 D。前面的最高分查询只依赖 major:一万名学生可能只有十个专业,因此可以先按十种参数计算,再映射回原来的一万行。
1 | 原始外侧 R:保留全部行及重复 |
对参数域去重用于减少相同绑定的计算,原外侧结果的多重集语义仍需保留。多个相关列时,去重对象是列值组合,不能各列分别去重后随意做组合。
算法逐步把依赖穿过过滤、投影、聚合等算子,调整分组键和属性引用。右侧已经不再依赖外层时,就能转换为普通 Join,再交给常规优化器选择算法。
标量子查询与聚合的边界
标量子查询的结果要求是零行、一行或多行:零行通常得到 NULL,一行取值,多行应产生相应错误。改写成 Join 时要保留这种单行约束,多匹配行为不能直接变成复制外层行。
聚合空输入也很重要。例如:
1 | SELECT c.id, |
没有订单的客户应得到 0。先对订单分组后做内连接,会丢失这位客户;使用左连接还需要把缺失组的计数恢复为 0。若直接在客户与订单的左连接后计算 COUNT(*),补空行反而被计为 1,应根据语义选择 COUNT(o.order_id) 等表达式,并保证被计数列的空值条件。
SUM、MAX 在空输入上返回 NULL,与 COUNT 的行为不同。去相关规则必须按聚合函数处理,不能统一套用补零规则。
把 COUNT 的缺失组恢复完整
设 customers.id 唯一且非 NULL,订单里的 customer_id 使用普通等值比较。前面的相关计数可以改成下面的教学 SQL:
1 | SELECT c.id, COALESCE(g.n, 0) AS order_count |
客户 1 有两笔订单,客户 2 没有订单,订单中另有一行 customer_id = NULL。聚合得到客户 1 的计数 2,以及一个 NULL 键组;外层等值连接不会让 NULL 键匹配任何非 NULL 客户。客户 2 的右侧字段被补空,COALESCE 恢复原来空输入 COUNT 的 0。
要恢复的是“缺失聚合组”的默认结果,不能把每个聚合函数都替换成 0。对 SUM,原相关聚合没有匹配订单时返回 NULL;若存在订单但金额全部为 NULL,SUM 也返回 NULL。改写后应保留这些情况,COUNT 与 SUM 的默认值分别处理。
参数域怎样与原外侧重新关联
假定外侧四行的相关参数组合依次为 (China, CNY)、(China, CNY)、(US, USD)、(NULL, CNY)。参数域 D 去重后有三行,内侧只需为三种绑定计算。但是回接外侧时,前两行仍是两行,不能因为参数去重而丢掉其中一行。
还要区分“原子查询的比较语义”与“恢复参数身份的比较”。内侧业务谓词 country = 参数 对 NULL 产生 UNKNOWN;回接外侧却可能需要把 NULL 参数组合找回到它原来的结果,因而采用能识别 NULL 参数身份的方式。具体代数实现可引入相应的空值相等语义或内部标识。直接用普通等号连接所有参数列,可能使 NULL 绑定的外侧行消失。
这个差别在计数示例里很直观:即使业务比较对 NULL 参数没有匹配,外侧那一行仍可能需要返回计数 0。消除相关性既要正确计算每个参数的内侧结果,也要正确恢复调用者,两个阶段需要分别验证。
从局部消除到整体去嵌套
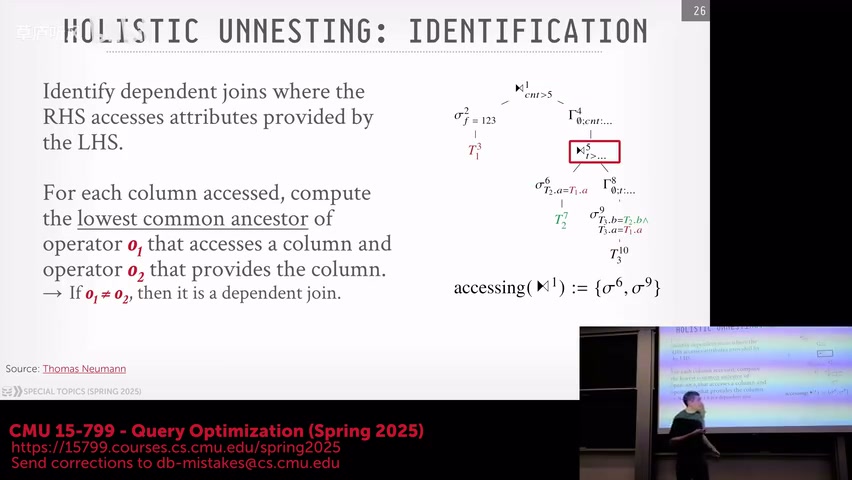
视频 55:30:Indexed Algebra 跟踪列来源与使用位置。画面区分普通算子连接、作用域以及列的来源和消费者。Holistic Unnesting 需要知道外层提供的列在哪里被读取,才能统一处理多个依赖连接。这里的辅助索引针对计划分析,不是表数据上的索引访问。
Improving Unnesting of Complex Queries是本讲主阅读。它用多层相关查询说明局部处理的局限:最内层依赖外层参数,消除内层以后再消除外层,可能让不同参数域形成额外的笛卡尔组合,直到后面的过滤才把不合法组合移除。结果仍然正确,中间工作却显著增加。
下面改写论文开头的业务含义,展示两层相关性:
1 | SELECT c.id |
最内层需要订单编号,中间层需要客户编号。若最内层还引用客户的属性,优化器需要保留“这个订单确实属于这个客户”的参数组合关系。单独展开客户域与订单域,再在后面过滤,会生成本来不需要计算的组合。
2025 年的 Holistic Unnesting 把这些依赖一起分析,主要分成三步:
- 识别非平凡依赖连接,记录哪些算子读取了它们左侧提供的列。Indexed Algebra 通过属性来源和最低公共祖先等查询辅助定位。
- 按自顶向下顺序处理依赖连接,先尝试把简单过滤合并到 Join,或把允许移动的表达式移到合适位置,直接消除简单依赖。
- 对剩余结构记录需要引入的参数域,在向下改写算子时延迟加入,直到参数域变得不再需要,或能安全加入。这个过程避免把不同参数域反复推过嵌套依赖连接。
遇到聚合时,相关参数可能需要进入分组键;遇到投影时,需要保留后续使用的参数列。ORDER BY ... LIMIT 和递归查询还需要专门规则,不能只靠普通 Join 结合律处理。论文第 4 节讨论这些复杂结构。
共享子计划的有向无环图(DAG)表示帮助复用参数域与计算。Indexed Algebra 则让“列由谁提供、在哪里使用”的查询更高效。这里的索引是计划结构的分析索引,与数据表上的 B-tree 索引处在不同层次。
去相关后的计划仍需比较成本
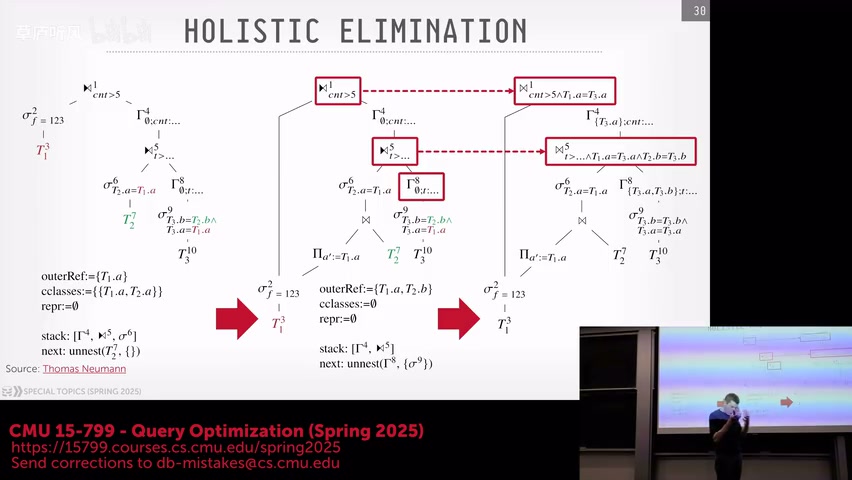
视频 70:30:Holistic Elimination 的多步计划变化。三列计划树和红色箭头展示整体改写的多个阶段,红框标出正在处理的算子与属性。读图时跟踪同一个参数列在哪一层产生、在哪一层使用,以及参数域何时真正加入计划。复杂代数符号可以结合本讲高清课件和主论文逐项放大查看。
一次聚合加 Hash Join 可以避免重复全表扫描。但外侧只有一行、内侧有高选择率索引时,参数化索引访问也可能很便宜。扩大合法搜索空间后,仍需要统计与成本比较。
阅读执行计划时,关注外侧参数怎样传入、内侧被调用多少次、是否出现半连接或聚合、缺失组怎样处理。用重复行、空表、NULL 和标量多匹配这几类小数据推演,能够判断改写是否保持语义。
参考资料
Improving Unnesting of Complex Queries (T. Neumann, BTW 2025) (Primary)
Unnesting Arbitrary Queries (T. Neumann et al., BTW 2015) (Optional)
EQOP Book (Chapter 4.5) (Optional)