
课程视频
B 站高清观看:13 - Lecture 13 - Cost Models Cardinality Estimation
本页截图取自上方 B 站课程录像,标注时间可跳回对应位置;图中细字可配合文末的高清课件查看。正文里的教学数据与原课示例分别说明。
从统计摘要推算每个算子的行数
第 13 讲讨论基数估计(Cardinality Estimation,CE)。基数是一个关系结果中的行数。扫描、过滤、Join 和聚合都会产生不同规模的结果,优化器需要沿计划推导这些数量,再决定访问方式、Join 顺序和资源需求。
本讲的主阅读 Query Optimization Through the Looking Glass通过 Join Order Benchmark(JOB)分析估计与计划质量。本文先解释常用公式,再讨论它们的适用条件;数字示例均为教学数据。
单个过滤条件
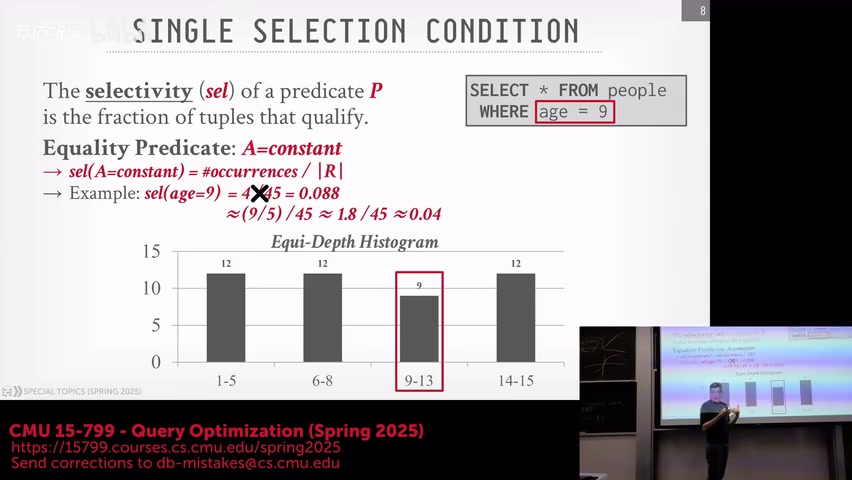
视频 10:30:等值条件怎样利用桶内频率。例子先找到常量所属的桶,再用桶行数与桶中不同值数估计等值频率,最后除以总行数得到选择率。这个计算依赖桶内均匀分布假设。热点值已有单独统计时,应优先结合它的信息,不能始终机械使用平均频率。
记 N(R) 为表 R 的行数,s(P) 为谓词 P 的选择率,即结果为 TRUE 的行所占比例:
1 | 估计行数 = N(R) × s(P) |
若一百万订单中已付款占 90%,status = 'PAID' 估计为 90 万行。对没有高频值信息的等值条件,一种近似是“非空行数 / 非空 NDV”,依赖剩余值近似均匀分布。
范围条件依靠直方图,完整桶累加计数,部分桶根据桶内分布估算。边界外的新值、非常窄的范围或桶内热点,都可能让这个近似出现偏差。
SQL 的 UNKNOWN 怎样影响补集
在没有空值等第三种状态时,s(NOT P) = 1 - s(P)。SQL 三值逻辑中,需要同时考虑 UNKNOWN:
1 | s(NOT P) = 1 - s(P) - u(P) |
u(P) 表示 P 为 UNKNOWN 的比例。设 20% 的 amount 为 NULL,10% 满足 amount = 100,那么 amount <> 100 的选择率为 70%。空值也无法通过不等过滤,因此直接算 90% 会高估。
多个过滤条件与独立性
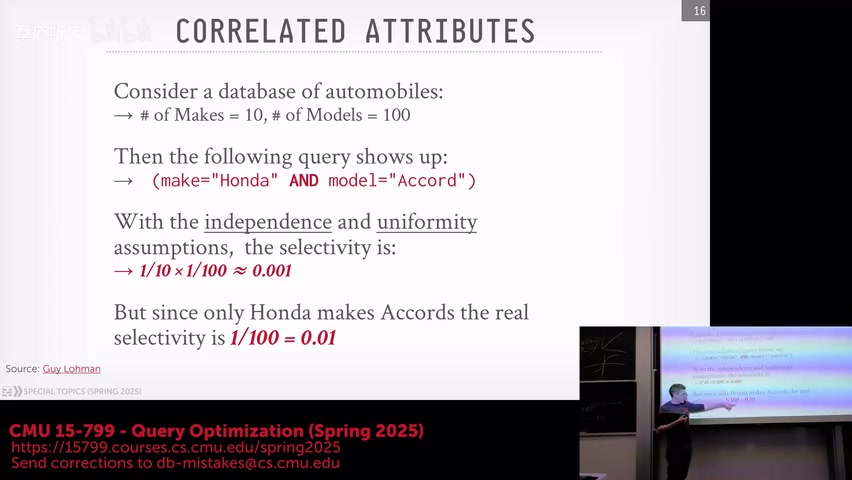
视频 23:00:品牌与型号相关性造成的低估。课件用汽车品牌和型号说明:型号本身已经强烈约束品牌,将两个单列概率相乘会把相同约束重复当成独立筛选。右边列出独立公式和相关关系下的结果,正文进一步用联合概率及约束解释这一类误差。
若 P、Q 独立,可以近似:
1 | s(P AND Q) ≈ s(P) × s(Q) |
第二行按“结果为 TRUE”的行集使用容斥关系;第一行是额外的独立性假设。
设车辆有 10 个品牌、100 个型号,每个型号只属于一个品牌。教学数据中每个型号有相同行数,某品牌恰有 10 个型号。make = 'Honda' 占 10%,model = 'Accord' 占 1%。两个条件相乘得到 0.1%,真实交集仍为 1%,因为型号已经决定品牌。
这个例子说明,完整且新鲜的单列统计,也可能无法修复多列相关性。需要联合统计、依赖信息或更适合的估计方法。
Join 基数怎样估计
对无空值的等值 Join R.a = S.b,一种常见简化公式为:
1 | N(R ⋈ S) ≈ N(R) × N(S) / max(NDV(R.a), NDV(S.b)) |
它依赖键频率近似均匀,以及较小值域基本被较大值域覆盖等假设。若两侧值域完全不相交,结果应为零;若某个热点值在两侧都大量出现,结果会被这个值的频率乘积放大。
更直接的等值 Join 定义是:
1 | N(R ⋈ S) = Σ_v frequency_R(v) × frequency_S(v) |
求和对象为两侧共同的非空键值。假设两边各有一万行,其中键 1 各出现五千次,仅这个键就贡献 2500 万个匹配。两表行数和 NDV 相同,也不能保证它们的 Join 大小接近。
约束提供更强的信息
如果订单的非空客户编号存在有效外键,每个订单都对应一个客户主键,那么未经过其他过滤的订单到客户内连接,结果等于订单行数。若客户侧又过滤地区,订单保留比例还取决于订单客户分布,不能仅按客户地区占比机械相乘。
唯一性、外键和空值约束提供的是语义事实。它们与统计摘要相互补充,但系统需要确认约束有效,并且当前查询没有改变对应条件。
从逐键匹配数推导常用 Join 公式
对普通等值连接 R.k = S.k,暂时排除 NULL,可以按键值 v 写出精确行数:
1 | |R ⋈ S| = Σv frequency_R(v) × frequency_S(v) |
例如 R 的键为 1, 1, 2,S 的键为 1, 2, 2, 2。键 1 贡献 2 × 1 = 2 行,键 2 贡献 1 × 3 = 3 行,最终输出 5 行。Join 会保留匹配组合产生的重复,单看两个输入的 NDV 无法还原这个分布。
若进一步假设两侧都在各自值域均匀分布,较小值域包含于较大值域,并且共同值数量等于较小 NDV,设 V_R ≤ V_S,便得到:
1 | 共同值数量 × R 每值行数 × S 每值行数 |
常用公式的分母来自这些假设。两侧值域不重叠时,真实输出可以为 0;热点键对齐时,输出会由热点频率乘积主导。只有 NDV、没有重叠度和频率关系,就会丢失这些信息。
主键与可信的外键约束提供了更强结论。若每个非 NULL 外键都引用主键表中存在的一行,且主键侧没有过滤,那么每条非 NULL 外键行恰好匹配一次。加上主键侧过滤以后,输出又取决于外键值与过滤结果的关系,不能继续把全部外键行都计入。
Group-By 的输出规模
按一列分组,输出规模接近过滤结果中该列的不同值数;存在空值时,空值还可能构成一个组。按多列分组,需要组合 NDV。
若一万个地区代码唯一决定国家,GROUP BY country, region_code 的组合数量接近地区代码数。分别乘两列 NDV,会严重高估。反过来,先经过高度选择性的过滤后,原表 NDV 也不再直接代表结果中的不同值数。
误差怎样传到物理计划
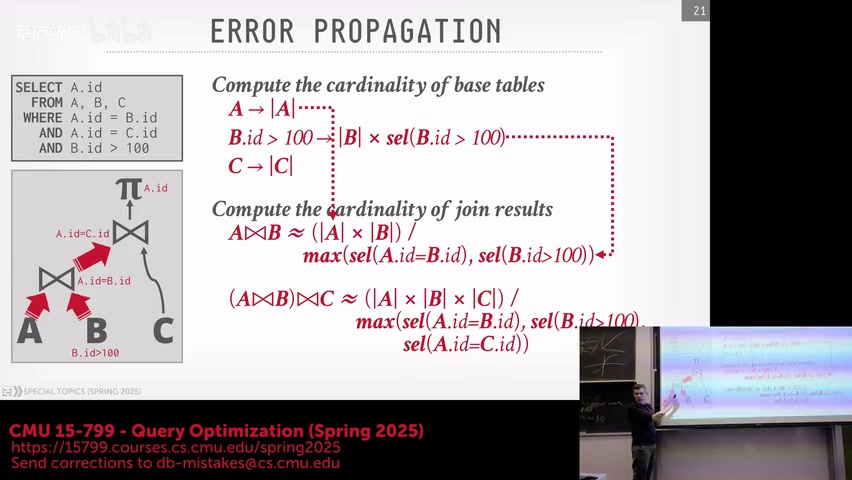
视频 40:30:基础过滤与多层 Join 的误差传播。左侧 SQL 与树形结构对应,右侧公式从基本表规模开始,逐层计算 Join 输出。一个基础过滤估计会继续作为父 Join 输入,后面的均匀性与包含性假设还可能引入新误差。诊断时应沿树找到最早偏离的位置,再观察父节点如何使用该规模。
假设过滤后真实有十万行,优化器估计为 10 行。它可能把该结果放到 Nested Loop Join 外侧,认为内侧只需做十次索引查找;执行时变成十万次查找,回表和随机访问成本大幅增加。
Hash Join 或 Sort 的内存需求也会受影响。输入行数和行宽被低估,实际执行可能溢写;中间行数被高估,则可能放弃原本便宜的索引访问。多层 Join 中,前面的键分布误判还能传播到后面的估计。
Q-error 常写为:
1 | Q = max(estimated / actual, actual / estimated) |
这个定义适用于正数,零值需要约定平滑或单独处理。估计 10、真实 1000,Q-error 为 100;估计 1000、真实 10,也是 100。它反映倍率,不能单独表达高估与低估的方向或计划损失。
Q-error 与计划后悔值分别观察什么
对正的真实行数 A 与估计行数 E,常见的 Q-error 是 max(E/A, A/E)。估计 100、真实 10000,与估计 10000、真实 100,Q-error 都是 100;一个是低估,一个是高估,物理后果可能不同。零行情况需要额外约定,不能直接做除法。
设索引访问的教学成本为 5 + 0.02 × 行数,扫描成本固定为 100。估计 100 行时,优化器会选成本 7 的索引方案;若实际命中 10000 行,索引实际工作对应 205,扫描则仍为 100。误差跨过了访问方式的分界点,才产生这里的计划损失。
另一查询实际 10 行,估计 1000 行,虽然也有百倍误差,两个规模仍可能都选择索引路径,计划未必改变。评估估计器时,行数误差刻画预测质量,选择计划后相对优质计划增加的运行开销刻画决策损失。两种指标需要一起报告。
排查一棵执行树时,可以在每个节点记录输入估计、输出估计、真实输出与被选算法。先找到最早明显失准的节点,再顺着父节点观察它是否改变 Join 方向、内存预算或访问模式,比只盯着根节点误差更容易定位原因。
JOB 实验怎样读
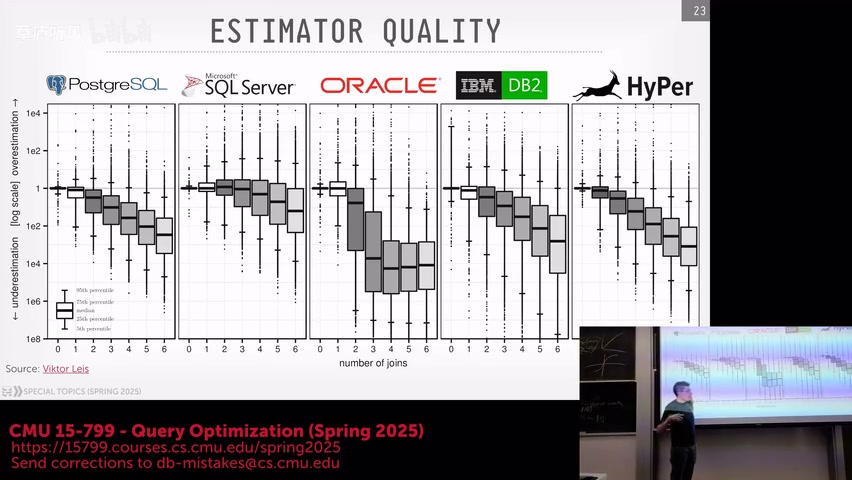
视频 50:30:多个系统在不同 Join 数量下的估计分布。图里按系统分面,横轴增加 Join 数量,纵轴展示估计与真实行数的比例,比例为 1 的水平基准线标出准确估计的位置。先确认纵轴比例和对数尺度,再比较分布与尾部。它来自论文的特定工作负载与版本,适合分析误差机制,不能直接当成今天各产品的排名。
JOB 基于 IMDB 的多表查询,数据中包含倾斜与相关性。论文比较不同估计、模型和计划策略,并注入真实基数,以区分“行数预测错误”和“给定行数后成本计算错误”。
真实基数实验是分析工具:它为许多候选表达式提供执行得到的行数,代价高昂,普通查询编译不能照搬。实验结论还受工作负载、索引、系统版本和执行算法范围约束。
即使平均 Q-error 改善,也要观察最终计划和运行时间。某个小子表达式估计错了百倍可能没有改变方案,而一个计划选择阈值附近的两倍误差可能切换 Join 算法。下一讲会更具体地分析哪些表达式的估计值得优先改进。
参考资料
Query Optimization Through the Looking Glass, and What We Found Running the Join Order Benchmark (V. Leis et al., VLDB Journal 2017) (Primary)
EQOP Book (Chapter 5.4-5.5) (Optional)
How Good are Query Optimizers, Really? (V. Leis et al., VLDB 2015) (Optional)