
课程视频
B 站高清观看:12 - Lecture 12 - Cost Models Statistics
本页截图取自上方 B 站课程录像,标注时间可跳回对应位置;图中细字可配合文末的高清课件查看。正文里的教学数据与原课示例分别说明。
优化器怎样在执行前了解数据
第 12 讲开始讨论代价模型。优化器无法为每个候选都完整执行一次,所以需要统计摘要近似数据分布。统计信息是估计输入;基数估计利用这些输入预测行数;物理代价模型再把行数、行宽和算法工作量换算成可比较成本。
本文依据课程课件,结合分组估计与采样论文展开。以下数据均为教学构造。
1 | SELECT order_id |
只知道表有一百万行,还无法判断筛选后的规模。如果绝大多数订单已付款,状态过滤作用很小;如果金额集中在这个区间,范围过滤也会命中很多行。这些分布决定了索引访问、扫描以及后续 Join 的取舍。
基础统计解决哪些问题
| 统计项 | 含义 | 典型用途 |
|---|---|---|
| 行数、页数 | 基本表的规模 | 扫描成本与估计起点 |
| 平均行宽 | 每行占用的近似空间 | 内存、网络和物化成本 |
| 空值比例 | 某列为 NULL 的比例 | IS NULL 与比较估计 |
| NDV | 不同值数量,Number of Distinct Values | 等值过滤、分组、Join |
| 最小值、最大值 | 已观察的数据范围 | 范围判断与分桶 |
| 高频值及频率 | 明显偏离均匀分布的值 | 对热点值单独估计 |
NDV 为 10 并不意味着每种状态各有 10% 的行。假设已付款占 90%,其余九种状态合计只占 10%,用 1 / NDV 估计已付款就会严重低估。高频值摘要可以单独保存这部分信息,剩余值再采用近似。
直方图怎样压缩分布
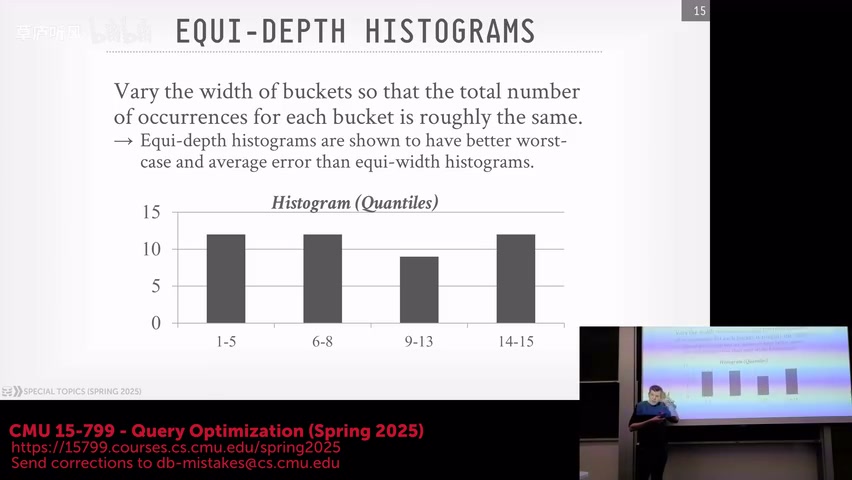
视频 38:00:从精确频数到直方图摘要。横轴表示不同值,纵轴表示出现次数。原始分布中每个值都有自己的频数,直方图把这些信息压缩到有限桶。后续范围估计需要在桶内恢复一部分未知分布,正文用三个桶的数值说明均匀插值从哪里产生误差。
Histogram(直方图)把值域划分为桶,保存每个桶的行数或频率。在内存和收集预算有限时,优化器无法记录所有值,需要在桶内部继续采用某种分布假设。
等宽与等深
等宽直方图(Equi-Width)按近似相同的值域宽度分桶。若金额主要集中在小范围,大部分行就挤在少数桶里,细节损失较多。
等深直方图(Equi-Depth)让每个桶覆盖近似相同数量的行,因此密集区域的桶较窄,稀疏区域较宽。这里的“深”指行数,桶包含的不同值数可以不同。
例如一万行金额数据,八千行位于 0–100,剩余两千行位于 100–10000。等宽桶会把密集区域压进很小的一段;等深桶能给这个密集区域更多边界。范围查询跨越若干完整桶时,可以累加这些桶的计数,边界落在桶内时则要估算部分覆盖比例。
高频值与剩余分布
End-Biased Histogram 一类表示会显式保存热点值,其余值合并处理。实际系统也可以把高频值列表与范围直方图结合使用。这样对 status = 'PAID' 和 amount BETWEEN ... 分别采用适合的信息。
桶数越多,摘要通常越精细,但统计占用、采样量、维护和优化期间读取成本也会上升。更细的单列摘要仍然无法完整表达列之间的关系。
按桶内比例估算一个范围
假定金额直方图有三个桶,分别覆盖 [0, 100)、[100, 200)、[200, 300),行数为 2000、5000、3000。估算 amount >= 150 AND amount < 250 时,查询在第二桶覆盖一半,在第三桶覆盖一半。若暂时假设每个桶内按值域均匀分布,估计为:
1 | 5000 × (200 − 150) / (200 − 100) |
真正的数据可能集中在 199 或 201 附近,此时“半个值域对应半桶行数”就会失准。高频值摘要与更细的桶边界能缓解问题。离散值、端点频率、NULL 和单独保存的热点还需要相应公式,本例使用半开区间避免把边界归属混在演示中。
统计收集的对象也要明确。有些系统将高频值从直方图样本中单独处理,剩余桶的频率基于剩余数据;不能把高频值计数与覆盖全部数据的桶计数直接相加,否则会重复计数。阅读具体实现的元数据时,需要确认每一项摘要的分母和覆盖范围。
Sketch 保存的是哪种摘要
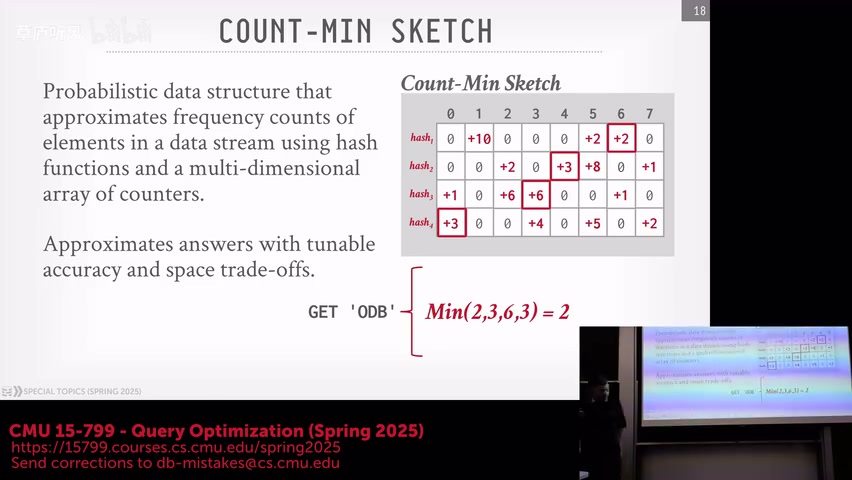
视频 48:00:Count-Min Sketch 查询取多行计数的最小值。示例将同一键映射到不同哈希行,查询位置里的计数分别来自该键和其他碰撞键。底部的 Min 操作选择多个计数中的较小值,以减轻碰撞造成的高估。先观察哪些位置被更新,再对照正文的三行计数例子。
Sketch 是使用有限空间近似统计量的数据结构。不同 Sketch 回答不同的问题:
| 结构 | 主要问题 | 需要注意的边界 |
|---|---|---|
| Count-Min Sketch | 一个值出现了多少次 | 哈希碰撞会影响频率估计 |
| HyperLogLog | 出现了多少个不同值 | 输出的是近似 NDV |
| 分位数摘要,如 t-digest | 分布的分位点在哪里 | 不直接给出所有等值频率 |
以仅插入、非负计数的 Count-Min Sketch 为例,每个值通过多组哈希更新不同计数器,查询时取相应计数器中的最小值。碰撞会把别的值频率加进来,因此这种基本形式可能高估频率。删除或带符号更新需要另行讨论。
HyperLogLog 用哈希值的分布近似不同值数量,能够以较小摘要合并多个数据分片的结果。摘要合并的前提是编码与参数兼容。知道客户编号的 NDV,可以帮助估计分组规模,但无法由此直接知道某个具体客户有多少订单。
Every Row Counts讨论结合 Sketch 和采样估计 Group-By 结果。分组规模取决于组合值,而只观察单列 NDV 可能失去相关性。
Count-Min Sketch 的一次查询
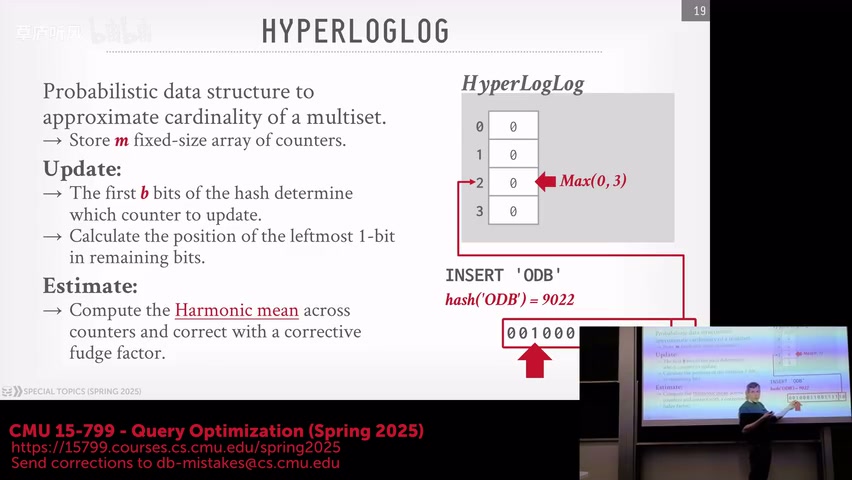
视频 50:30:HyperLogLog 的寄存器与哈希位。课件把一个哈希值拆成寄存器索引与剩余模式,更新时保留对应位置观察到的极端前导零长度。它估计的是不同值数量,与前一幅图查询某个值的频率不同。理解寄存器的含义以后,再看多个兼容摘要为什么能合并。
构造一个三行计数器的教学摘要。值 PAID 经过三个哈希函数,分别落到计数器 (1, 2)、(2, 5)、(3, 1);查询时这三个位置保存的计数为 100、103、101,估计频率取最小值 100。
如果 PAID 实际出现 98 次,其他状态与它碰撞,三个位置都至少包含这 98 次更新,另有少量碰撞更新。这解释了仅插入形式的高估来源:更多哈希行提供更多避开碰撞的机会,更多桶降低单行碰撞概率。若摘要采用近似计数器、删除或其他更新协议,需要重新检查这个性质。
HyperLogLog 则先用一部分哈希位选择寄存器,再利用剩余位的前导零长度记录出现过的极端模式。不同值越多,越有机会观察到更长的前导零;算法从多个寄存器的统计推算 NDV,并做相应校正。两个兼容摘要通常通过逐寄存器取最大值合并,所以跨分片重复出现的值不会像“把各分片 NDV 相加”那样直接重复计数。
Count-Min Sketch 面向某个值的频率,HyperLogLog 面向整个集合的不同值数。用错摘要类型,即使它们占用相同内存,也无法得到所需估计。
采样怎样省下收集成本
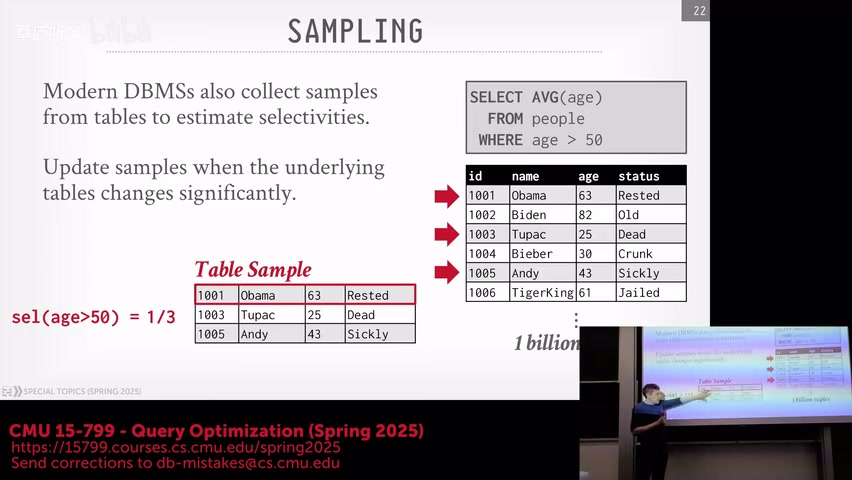
视频 55:30:用样本命中比例估计选择率。画面从原表抽取样本,用满足条件的样本行比例估计过滤选择率。红色标记对应样本里实际命中的行。结果质量依赖采样方式和样本是否覆盖目标区域,零命中也只描述样本,不能直接证明原表结果为空。
采样从数据中抽取一部分行,统计它们再推断整体。设独立均匀行采样得到一万行,其中 300 行满足过滤,最直接的选择率估计为 3%。样本中一次都没观察到的稀有事件仍可能存在,零命中不能证明整体为零。
按块采样(Block-Level Sampling)读取部分数据页,更容易减少 I/O。但同一页的数据可能高度相关,例如按日期连续存放的订单。连续读几个近期页面,不能直接代表全部历史订单。
块级采样论文研究了这种收集成本与估计质量之间的关系。比较采样方法时,要同时考虑抽样单位、数据聚集、样本量和估计方差。
从逻辑工作量到物理成本
课件还区分逻辑工作量与物理资源成本。过滤一百万行需要多少次谓词求值,索引探测多少次,排序处理多少键,这些描述算法工作;CPU 时间、页读取、内存与网络则把工作映射到执行环境。
Smallbase 的例子使用两阶段建模:先识别谓词求值、索引探测、排序等执行原语,再通过微基准测量相关 CPU 和内存成本,代入随输入规模变化的算子公式。换硬件时,可以重新测量原语系数,而不必丢弃算法工作量模型。
假定谓词求值每次成本为 a,某扫描输出 N 行,过滤的教学成本可写为 a × N。数据列宽、编码或表达式复杂度改变时,a 可能不同;存储访问还要增加页与缓存相关成本。统计信息给出规模,逻辑模型计算次数,物理系数反映执行环境,三者需要完整衔接。
这是课程介绍的建模思路。实际系统的单位和常量需要按目标版本与硬件测量,本文不给出可直接套用到生产环境的统一参数值。
多列统计与统计时效
如果 country = 'China' 时币种几乎总是人民币,那么两个单列条件并不独立。联合频率、列组 NDV 或函数依赖统计可以表达一部分关系。全列组合的数量非常大,系统一般需要挑选对工作负载有价值的列组。
统计还可能过时。表总体只增长少量行,新增数据却集中在一个新日期或热点键,相关过滤的估计仍会明显偏离。只按全表更新比例判断统计是否有效,有时无法发现这种局部变化。
阅读计划时,可以先确认估计依赖的摘要是什么、来自什么时候,再观察哪个节点最先出现偏差。后面两讲会区分摘要不足、估计假设和物理模型造成的不同影响。
参考资料
EQOP Book (Chapter 5.1-5.3) (Primary)
Every Row Counts: Combining Sketches and Sampling for Accurate Group-By Result Estimates (M. Freitag et al., CIDR 2019) (Optional)
Effective Use of Block-Level Sampling in Statistics Estimation (S. Chaudhuri et al., SIGMOD 2004) (Optional)