课程视频
B 站高清观看:08 - Lecture 08 - Join Ordering Top-Down
本页截图取自上方 B 站课程录像,标注时间可跳回对应位置;图中细字可配合文末的高清课件查看。正文里的教学数据与原课示例分别说明。
从完整查询的最后一次 Join 开始
第 08 讲讨论自上而下 Join 枚举。假定目标关系集合为 {A,B,C,D},根节点最后一次 Join 可以将它切成 A | BCD、AB | CD 或 ABC | D。先确定一个切分,再递归求解两侧,就得到面向目标的搜索。
本讲主阅读 Optimal Top-Down Join Enumeration关注高效枚举划分。论文标题中的 Optimal 还涉及枚举开销:生成合法 Join 候选时,怎样减少额外图分析和无效划分。最终计划质量另外取决于搜索范围、属性状态、代价模型和剪枝。
分区必须保留连通性
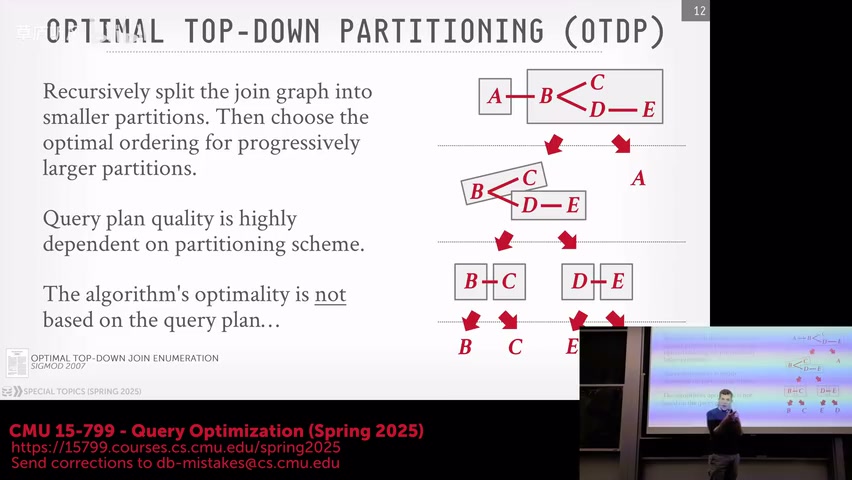
视频 23:00:从完整图递归产生连通分区。右侧从完整关系集合逐层拆成两个部分,再继续优化子部分。画面关注哪些二分能够形成合法 Join 输入。将其与正文的 A—B—C—D 对照,先排除 AC 与 BD 这种不连通两侧,再区分结构二分和物理 Join 的左右方向。
继续使用普通内部 Join 链 A — B — C — D。根目标的 AB | CD 划分有效,因为两侧分别连通,且 B、C 之间有 Join 条件。AC | BD 的两侧都不连通,在排除笛卡尔积的搜索空间中就不应生成。
朴素实现遍历全部非空真子集,再检查连通性。随着表数增加,很多检查最后只得到“不合法”。论文用图结构直接生成合适的切分,通过切断边集把图分成连通部分,并利用辅助结构降低反复分析的开销。
“切图”也要覆盖全部需要考虑的切分。每次只选一个看起来很好的最小割,属于启发式选择;精确枚举需要按算法要求遍历合法划分,并控制重复。两者会产生不同的搜索范围。
属性需求怎样传到两侧
以下教学伪代码省略具体分区算法和缓存状态:
1 | GetBestPlan(S, required): |
若当前候选是 Merge Join,子目标就可能需要按 Join 键排序;Hash Join 可以接受另一类输入要求。父节点提出需求以后再搜索相应子计划,这就是 demand-driven interesting orders(由需求驱动的有用顺序)。
缓存中也必须区分不同属性,以及参数化访问所需的外部值。一次无序搜索的最优结果,不能直接作为有序目标的最终答案。
累计成本定界
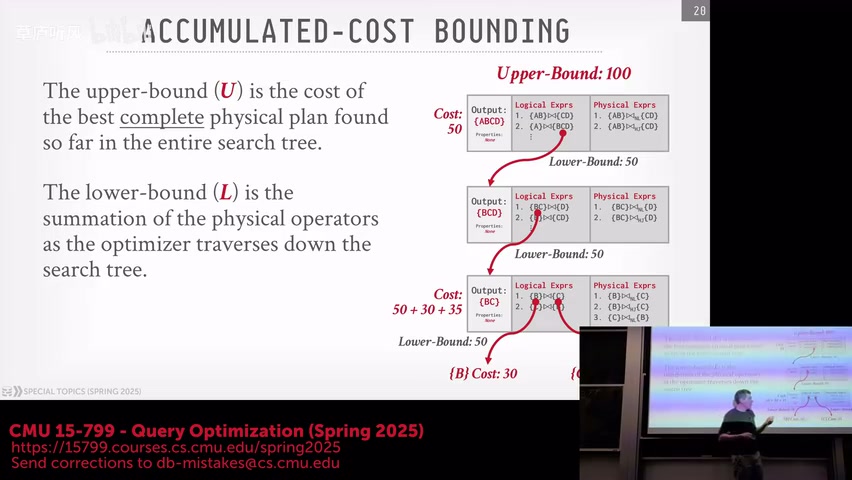
视频 50:30:Accumulated-cost Bounding 的逐层下界。顶部完整计划提供 Upper-Bound 100,沿当前分支向下逐步累计已确定的物理成本。画面中的 50、30、35 展示成本怎样加入部分计划。只有可靠下界超过完整计划上界时,才能确定当前分支不值得继续;正文使用另一组数字把这个判断完整展开。
自顶向下搜索的一个优势,是能在完整子树构建之前放弃某个候选。已经找到的可执行计划提供上界 U;正在构造的分支提供下界 L。当 L >= U 且下界可靠时,这个分支不可能得到更便宜的计划。
下面用人为设置的成本说明:
| 已知信息 | 成本 |
|---|---|
| 当前最优完整计划 | 100 |
| 另一分支已固定的上层 Join | 35 |
| 已完成左子树 | 50 |
| 右子树可靠最低成本 | 20 |
另一分支至少需要 35 + 50 + 20 = 105,可以停止。若右子树未知,取其最低成本为 0,只能得到 85,就还无法剪枝。
累计成本定界(Accumulated-Cost Bounding)利用已经确定的物理成本。它通常较保守,但只要满足模型的组合条件,就能保持搜索范围内的完整性。成本模型若包含并行重叠等因素,也需要重新证明下界怎样组合。
同一张四表图,搜索顺序怎样改变工作量
可以使用上一讲的教学成本表复现 Top-Down 搜索:AB、BC、CD 的局部输出成本分别为 100、1000、10;ABC、BCD、ABCD 分别为 50、20、5,单表成本记为 0。先从根集合尝试 A | BCD,递归到 BCD;在 BCD 中先尝试 B | CD,得到子成本 30,根成本 35。此时已经有一条完整计划作为上界。
再尝试 AB | CD,根 Join 的局部成本为 5,CD 的已知最低成本为 10。如果 AB 的可靠最低成本为 100,分支下界是 5 + 10 + 100 = 115,已经超过 35,可以停止扩展这一根切分。
对 ABC | D,只计算根 Join 的成本 5 尚不能证明分支昂贵。若继续沿 AB | C 处理 ABC,已确定 AB 的最低成本 100,再加 ABC 局部成本 50 和根成本 5,下界达到 155;同样能够停止。教学模型已给出全部局部代价,真实系统必须从合法已完成状态或可靠的算子下界取得这些数字。
如果一开始尝试 ABC | D,可能先形成 155 的上界,再用更多工作收紧到 115,最后到 35。最优结果在完整搜索中保持一致,访问顺序会改变何时取得好上界、多少分支能提早剪掉。启发式优先级因此可以改善搜索效率,同时保持完整枚举与合法定界的约束。
分区与 Join 方向分别处理
对关系集合而言,AB | CD 和 CD | AB 描述同一个无序二分。枚举器可以规定最小编号关系必须位于左侧,避免在结构枚举层重复生成。进入物理候选层后仍可能需要比较两种方向,例如 Hash Join 的构建侧和 Nested Loop 的外侧不同,成本也可能不同。
所以“消除对称分区”与“删除相反方向的物理实现”是两个决定。先保证分区覆盖所有合法树形结构,再让具体算法按自身条件选择方向,有助于把枚举正确性和实现成本分开验证。
预测成本定界的收益与边界
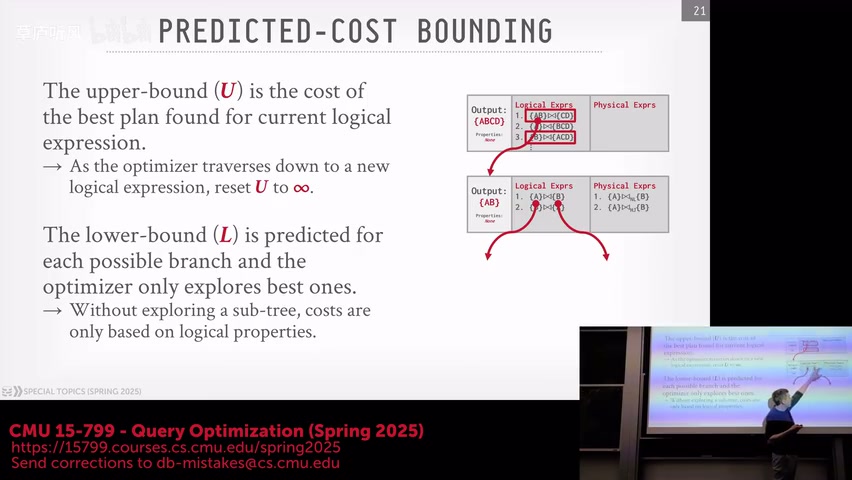
视频 58:00:Predicted-cost Bounding 先估计未展开子问题。这幅图对尚未完整搜索的逻辑子表达式使用预测成本,因而比单纯累计已完成工作更早形成界限。预测可能减少搜索,也需要检查是否满足安全下界条件。画面里的示意数值解释方法,不能自动当作任意数据库都成立的下界证明。
预测成本定界(Predicted-Cost Bounding)利用逻辑属性估计尚未展开子树的成本,能够更早安排或筛选分支。例如中间结果很大的一侧可能被优先判断为昂贵。
预测成本要区分“估计值”和“可证明的下界”。一个常用经验估计可能高于实际最低实现成本,直接据此剪枝会失去一些候选。若采用启发式剪枝,应承认近似性质;若要求精确搜索,预测函数就需要满足下界条件。
搜索顺序同样影响效率。先探索很容易得到好计划的分支,能尽早降低上界;先深入昂贵或不可实现分支,则可能迟迟无法有效剪枝。这个效果也解释了 Cascades 中 Promise 的用途。
超图怎样表达多表依赖
普通边只能表达两张表之间的关系。对于 A.x + B.x = C.x + D.x,两侧各需要多张表,优化器必须知道谓词在什么时候具备全部输入。超边用关系集合表达这种依赖。
Counter Strike 论文将自顶向下枚举扩展到超图。算法需要在划分中检查超边是否可用,并保留外连接等算子的重排约束。把多表谓词随意拆成几条二元边,会允许原本无法求值的中间 Join。
与自下而上搜索比较
| 观察角度 | 自下而上 | 自上而下 |
|---|---|---|
| 起点 | 单表和小集合 | 完整结果与所需属性 |
| 子问题准备 | 按依赖顺序提前完成 | 由父候选提出后递归求解 |
| 主要节省方式 | 避免无效组合、复用小集合结果 | 复用目标结果、利用上界与下界 |
| 工程难点 | 图驱动枚举顺序与状态规模 | 分区枚举、搜索状态与有效剪枝 |
两种方法都可以使用动态规划和属性状态。搜索方向并不能单独决定最终计划质量;在相同完整候选、模型和合法剪枝条件下,它们可以得到相同的最小代价结果。
在纸上分别从 AB | CD 和 A | BCD 展开四表链,再人为给出一个较小上界,观察哪些分支可以提前退出。接下来两讲讨论怎样把这些搜索工作交给多个线程,重点会转到依赖、共享状态与负载分配。
参考资料
Optimal Top-Down Join Enumeration (D. DeHaan et al., SIGMOD 2007) (Primary)
Counter Strike: Generic Top-Down Join Enumeration for Hypergraphs (P. Fender et al., VLDB 2013) (Optional)
A New, Highly Efficient, and Easy To Implement Top-Down Join Enumeration Algorithm (P. Fender et al., VLDB 2011) (Optional)
The Complexity of Transformation-Based Join Enumeration (A. Pellenkoft et al., VLDB 1997) (Optional)