课程视频
B 站高清观看:09 - Lecture 09 - Parallelization Bottom-Up
本页截图取自上方 B 站课程录像,标注时间可跳回对应位置;图中细字可配合文末的高清课件查看。正文里的教学数据与原课示例分别说明。
并行的是编译阶段的计划搜索
第 09 讲研究自下而上优化器怎样利用多个 CPU 核心或 GPU。这里的 worker 在枚举和比较执行计划;查询最终是否使用并行扫描或并行 Join,是另一项物理规划决策。
主要依据 Efficient Massively Parallel Join Optimization for Large Queries。搜索空间增长时,并行化可以在同一预算内考察更多候选,但算法本身仍需减少无效枚举。
DP 层之间有依赖,层内有机会并行
在四表链 A — B — C — D 中,单表访问路径准备好之后,AB、BC、CD 的搜索可以并行。构造 ABC 时要使用 AB 或 BC 的结果;构造 ABCD 时则需要相应的较小集合已经完成。
按关系集合大小划分搜索层,可以得到一个简单调度方案:
1 | 初始化单表状态 |
这是教学伪代码。实现可以进一步用细粒度依赖减少全层等待,但任何调度都必须确保父候选读取的是可用、完整的子状态。
最优结果由谁更新
若两个 worker 同时搜索集合 ABCD 的不同切分,一个得到成本 80,另一个得到 70,共享 Best[ABCD] 的更新需要同步。还要同时保护计划指针、属性和搜索状态,避免成本写成 70,计划却来自成本 80 的候选。
一种常见设计是每个 worker 先保留局部最优值,再由集合的 owner 汇总。另一种使用细粒度锁或原子协议。具体选择取决于冲突频率、计划对象大小和内存布局。
枚举规律与无效候选之间的取舍
DPsize 或 DPsub 的循环形式比较规则,容易划分给多个 worker;但它们可能检查许多不连通组合。DPccp、DPHyp 利用图结构减少这种工作,其递归扩展和依赖组织则更复杂。
这产生两个独立指标:算法评估了多少无效 Join 对,以及合法工作能怎样并行。大量线程可以掩盖一部分无效工作,也会增加内存访问和调度成本;更高效的单线程枚举可能因为依赖较多而难以均匀分配。
主阅读论文中的 MPDP(Massively Parallel Dynamic Programming)同时考虑这两个方面,在利用图结构的同时,使候选评估适合并行硬件。
树形查询图:删一条边就得到一个合法切分
先看 MPDP:Tree。对树形查询图中的连通关系集合 S,它的诱导子图仍然是一棵树。删掉其中一条边,便得到两个非空、互不相交的连通分量;两侧合起来覆盖 S,原来被删掉的边提供 Join 条件。这恰好满足连通子图与补集对(CCP-Pair)的要求。
在 A — B — C — D 上,删除三条边分别得到 A | BCD、AB | CD、ABC | D。对于包含 i 个关系的连通集合,只需考察 i−1 条边对应的切分;两侧互换是否需要另算,还取决于物理 Join 的方向和代价。相比先枚举所有子集再过滤,这个方法直接生成合法的结构划分。
1 | for size = 2 ... n: |
这是论文 Algorithm 2 的教学简化。不同 S 的计算、同一 S 内不同边的评估都提供并行机会;最终仍要完成局部结果汇总,并遵守较小集合的依赖关系。
带环查询图:把子集枚举限制在块内
有环时,删除一条边可能仍然保持连通,需要进一步利用双连通分量(Block)与割点。Block 是最大的不可分子图;多个 Block 通过割点组织起来,形成 Block-Cut Tree。链形图的每条边构成一个 Block,环形部分则可能形成更大的 Block。
MPDP 的一般算法先为当前集合 S 找出这些 Block,在各个 Block 内枚举左右子集并检查 CCP 条件。找到合法的块内切分后,用 grow(left, S − right) 沿允许访问的节点扩展左侧,完整右侧取它在 S 中的补集,再评估计划。这样,昂贵的子集枚举集中在块内。若整张图就是一个很大的 Block,算法仍需面对较大的枚举空间;图的结构直接影响这项优化的收益。
GPU 上的搜索需要准备哪些数据
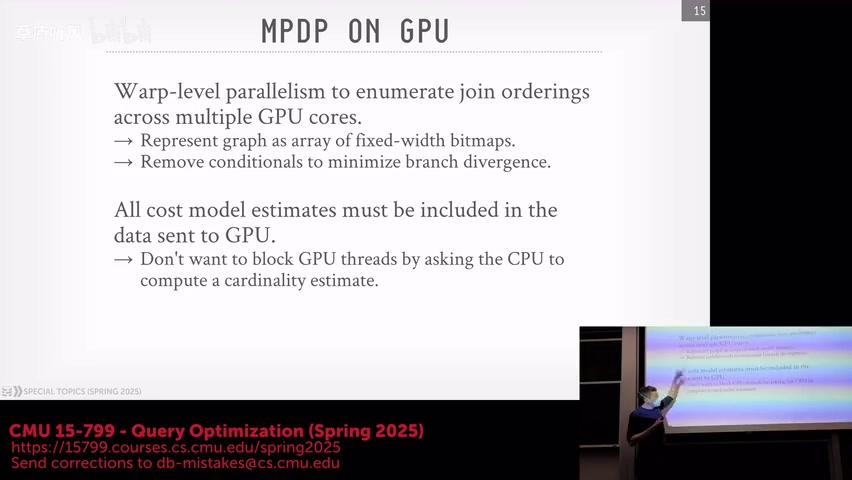
视频 33:00:GPU 搜索的位图、Warp 与统计前提。课件强调 fixed-width bitmaps、减少分支分化,以及代价估计所需信息应位于 GPU 可用的数据集中。大量线程的收益依赖这些准备,频繁等待 CPU 返回基数会破坏并行流水线。正文接着把集合生成、过滤、候选评估和 Memo 写回串成一层完整数据流。
GPU 擅长同时执行大量相似的小任务。Join 枚举可以把关系集合编码成固定宽度位图,用位运算判断交集、并集与连接关系;多个候选的成本计算也能交给线程束(Warp)内的线程。
但 GPU 搜索需要以下条件:
| 要素 | 原因 |
|---|---|
| 规则化的数据布局 | 减少随机指针访问和不连续内存读取 |
| 尽量一致的控制流 | 避免同一线程束里的分支分化 |
| 可在设备端使用的统计与代价信息 | 避免搜索时频繁回到 CPU 请求估计 |
| 足够大的任务批次 | 摊薄数据传输、启动和同步成本 |
例如 CPU 端每次基数估计都需要调用元数据服务,就无法把原有指针密集代码原封不动放进 GPU。可以预先准备摘要,也可以采用设备端可计算的模型;模型大小和精度会影响收益。
判断端到端效果时,应把“编码查询图、准备统计、传输、GPU 搜索、取回计划”全部算入编译时间。仅测设备内核耗时,会遗漏短查询中非常明显的固定开销。
一层 GPU 搜索的完整数据流
主论文把 GPU 处理组织为生成集合、过滤不连通集合、评估 Join 对、保留最优结果和写回 Memo 等阶段。可以将其理解为当前 DP 层的批处理流水线:
1 | 组合编号 → 解码为关系集合位图 |
论文实现以一个 Warp 处理一个集合,在 Warp 内为不同 Join 对分配线程。局部候选评估结束后,归约保留最优结果,使多个线程不必不断争用同一个全局最优项。论文还讨论了将归约与评估结合,减少全局内存写入。
这项分配存在负载差异:一个小 Block 可能产生很少候选,一个大的带环 Block 可能产生很多。集合规模相同并不保证枚举时间相同。测量时需要同时观察有效候选数、Warp 利用率、全局内存流量与总耗时,才能解释线程增加以后收益为什么下降。
设本层有一万个集合,每个集合平均产生 8 个合法候选,评估任务数约为八万;若另一个图同样有一万个集合,却包含大 Block,候选数可能显著增加。这只是说明工作量的来源,具体增长率应由图结构和论文中的枚举算法计算。
超大查询仍需近似与分区
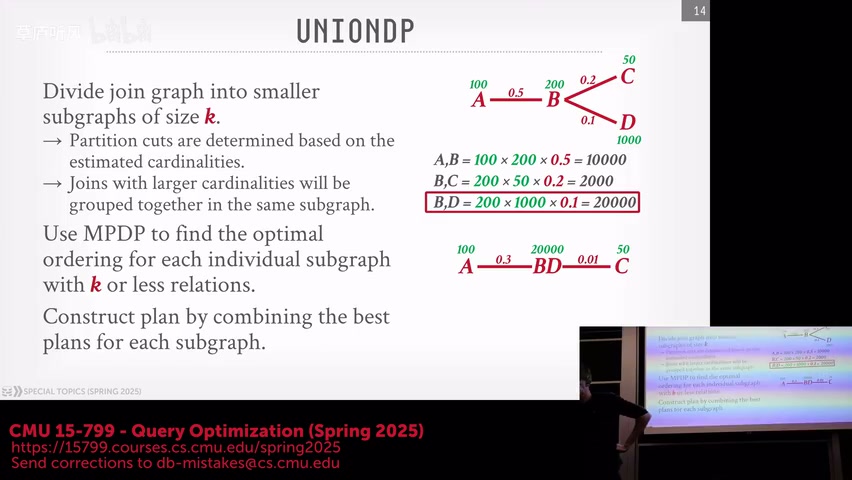
视频 28:00:UnionDP 的图划分与复合节点。右侧示例先比较边对应的规模,合并部分关系,得到较小的复合查询图。每个受限子图使用 MPDP,再继续组合复合节点。这一步改变完整搜索范围,需要同时评价编译时间和最终计划质量;较小子图的最优结果并不自动等于原图全空间最优。
并行计算改变可搜索的规模,完整 DP 的指数增长仍然存在。UnionDP 先按照启发式方法合并或划分查询图,对大小不超过阈值的子图使用 MPDP,再组合结果。IDP 类方法则反复优化选中的局部区域。
缩小搜索范围后,系统不能直接宣称获得全空间最优计划。它得到的是约束区域内的好方案,质量受子图划分和阈值影响。主论文分别报告搜索时间与计划质量,这两个指标需要一起阅读。
MPJ:把组合过程看成一次内部 Join
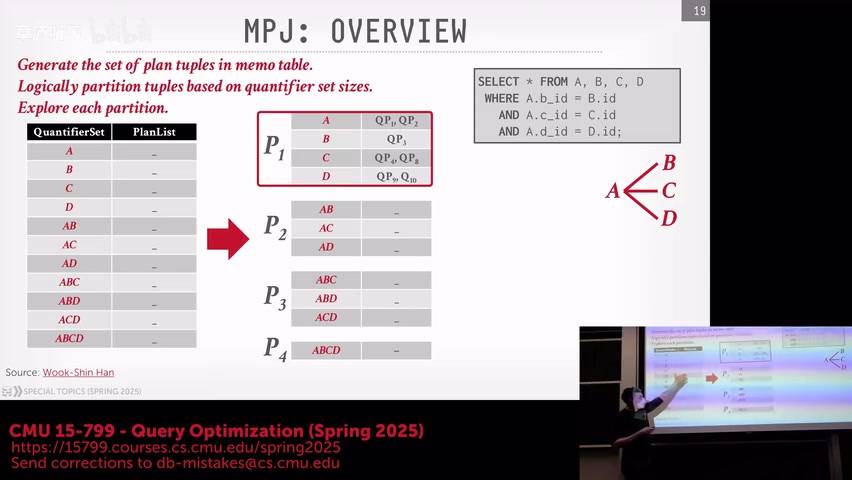
视频 48:00:MPJ 的层次化状态组合。左边列出由不同数量关系组成的计划状态,右边把它们分为若干组合层。这里的 Join 是优化器内部对候选状态做匹配与合成;状态保存关系集合和候选计划,尚未执行用户查询的数据 Join。分层以后再分配 worker,便能研究每层工作量与负载倾斜。
扩展阅读 Parallelizing Query Optimization介绍 MPJ(Multiple Plan Join)。可以把 Memo 的状态想象成内部表,每行保存关系集合与候选列表,再通过集合不相交、存在连接条件等约束,把两个状态合成较大状态。
这让搜索空间能够按两侧集合大小分层,也能进一步分配外循环和内循环。把工作量平均分成若干段是简单起点,但候选的处理成本可能不同:有些组合立即被拒绝,有些组合要检查多种物理属性。
因此任务数相等并不代表运行时间相等。轮转分配、动态任务队列和局部结果汇总,都是缓解负载倾斜的工程方式。搜索图中的热点状态还可能使同步成本随线程数增加。
怎样评价并行优化器
对相同搜索范围,先比较单线程与多线程的计划结果和成本是否一致,再测编译墙钟时间、总 CPU 时间和峰值内存。对相同预算,还应比较计划质量,因为节省的搜索时间可以被用来探索更多候选。
更短的编译时间可能伴随更多总 CPU 消耗;在并发查询很多的服务中,这会影响吞吐。并行优化的线程预算应与整个数据库的资源分配一起考虑。下一讲转向 自上而下并行搜索,任务依赖图会替代固定的 DP 层次。
参考资料
Efficient Massively Parallel Join Optimization for Large Queries (R. Mancini et al., SIGMOD 2022) (Primary)
Parallelizing Query Optimization (W.S. Han et al., VLDB 2008) (Optional)