课程视频
B 站高清观看:05 - Lecture 05 - Cascades
本页截图取自上方 B 站课程录像,标注时间可跳回对应位置;图中细字可配合文末的高清课件查看。正文里的教学数据与原课示例分别说明。
把优化搜索拆成可调度的任务
第 05 讲讨论 Cascades。上一讲的 Volcano 已经使用等价类、属性需求和记忆化搜索;Cascades 进一步把优化过程表示为任务,让探索逻辑形式、生成物理实现和优化输入能够按依赖推进。Cascades 原论文是本讲的主要依据。
如果一个逻辑子表达式已经足以生成便宜的物理计划,系统可以先计算这条路径,获得用于剪枝的上界,再继续探索其他形式。搜索顺序因此成为一个可控制的对象,而非完全隐藏在递归调用中。
Memo 保存的是什么
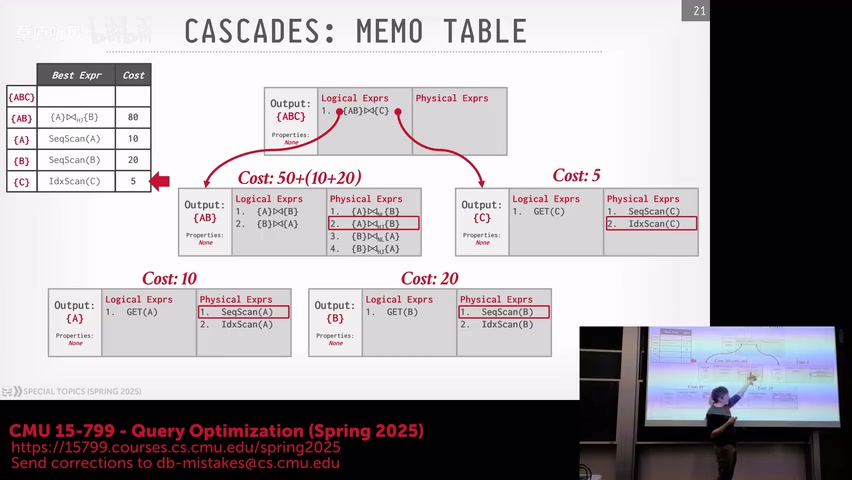
视频 53:00:Memo 中的成本与共享子组。左边是根 Group 列表,右边是相应逻辑与物理表达式。箭头把组表达式连接到被引用的子组,红色成本标记展示局部候选的比较。一个子组可以被多个父表达式引用,所以新增子实现无需为所有完整计划复制一棵新树。
Memo 是保存候选和搜索状态的紧凑结构。它由 Group(等价组)和 Group Expression(组表达式)组成。Group 保存语义等价的逻辑与物理形式;Group Expression 保存一个算子,以及它引用的子 Group。
用三表内部等值 Join 作教学示意,忽略输出列位置的调整:
1 | G_A = { Scan(A) } |
G_ABC 引用 G_AB,不复制 G_AB 的全部实现。后来向 G_AB 增加一种物理实现,引用它的父候选就有机会使用该实现。这让许多计划共享子问题,避免把搜索空间展开成大量独立的完整树。
等价组也不能只根据“涉及同一批表”判断。谓词、聚合、重复行语义和输出映射都影响结果。比如 A ⋈ B 与 A LEFT JOIN B 涉及相同的表,但它们的结果语义不同。
Group 中的最优方案与属性需求
同一个 Group 可以在多个优化上下文中被请求:无序输出、按键排序、某种数据分布等。最优物理方案是这些需求下的选择,概念上记录为 Best(G, required_properties)。
假设 Hash Join 的无序结果代价为 80,Merge Join 的有序结果代价为 95,无序结果排序还需 30。父节点要求该顺序时,应选 95;无顺序要求时,应选 80。Memo 的结构共享与最优结果的属性区分同时存在。
增加一个表达式,会不会增加一个 Group
继续用 G_AB 观察一次规则应用。Join(G_A, G_B) 与交换后的 Join(G_B, G_A) 返回相同的关系结果,因此第二个表达式放入已有的 G_AB。它增加了一个组内候选,通常无需新建结果 Group。
把 Join(G_AB, G_C) 结合变换为 Join(G_A, G_BC) 时,完整结果仍留在 G_ABC,但若此前没有 B 与 C 的子结果,就需要新建 G_BC。候选数量与 Group 数量是两个不同的统计量,规则可能增加其中一项,也可能同时增加两项。
物理实现同样可以共享逻辑结果。加入 HashJoin(G_A, G_B) 时,它实现 G_AB 的关系语义;输出顺序、分布与成本则属于该实现及其优化上下文。如果实现会交换输出列顺序,系统还需要正确的列映射才能判定等价。仅按表集合合并候选会遗漏这些约束。
当两次不同的规则推导最终发现同一逻辑结果,Memo 还可能需要合并已有 Group,并更新父表达式的引用及相关搜索状态。这项维护让结构共享有效,也使并发修改 Memo 比并发写入一个简单字典复杂得多。
Rule、Pattern 与 Binding
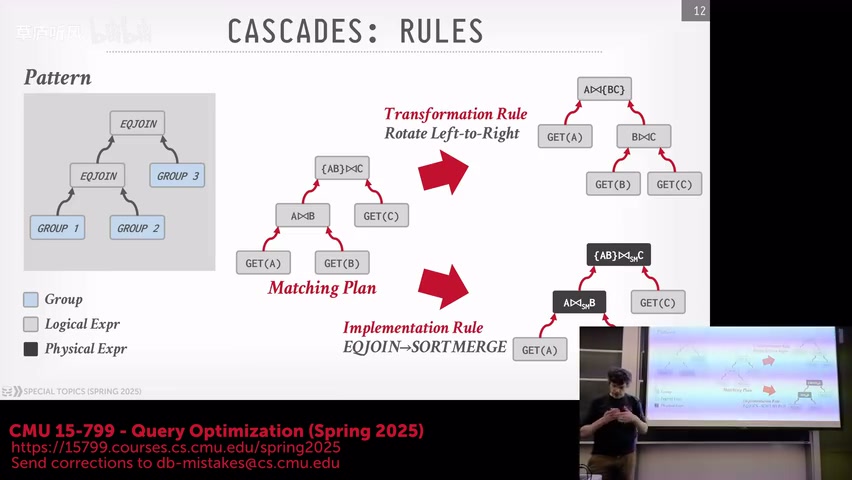
视频 25:30:规则 Pattern 与两种替换结果。左侧 Pattern 用 Group 占位匹配局部 Join 结构,中间给出匹配结果;右侧分别展示逻辑变换与物理实现。Group 占位符允许规则绑定组内候选,替换结果再进入相应等价组。这里可以直接对照正文的结合律例子,观察引用的是子组还是某一棵固定完整树。
Rule(规则)由模式、条件和替换结果等组成。Pattern 描述需要匹配的局部结构,Binding 把模式绑定到 Memo 中的具体候选。
1 | Pattern: |
这是内部 Join 结合律的示意。一个 Pattern 中的子 Group 可能包含多个表达式,因此一次模式匹配可以产生多个绑定。规则条件还要检查谓词应放在哪里、列引用如何映射,以及当前 Join 类型是否允许重排。
Cascades 在统一的框架中表示逻辑变换与物理实现规则。为了理解目的,仍然可以把它们称为 Transformation 与 Implementation;这里的统一指共用规则机制和调度搜索,而这两种操作依然承担不同工作。属性 Enforcer 也能用规则表示。
六类任务怎样协作
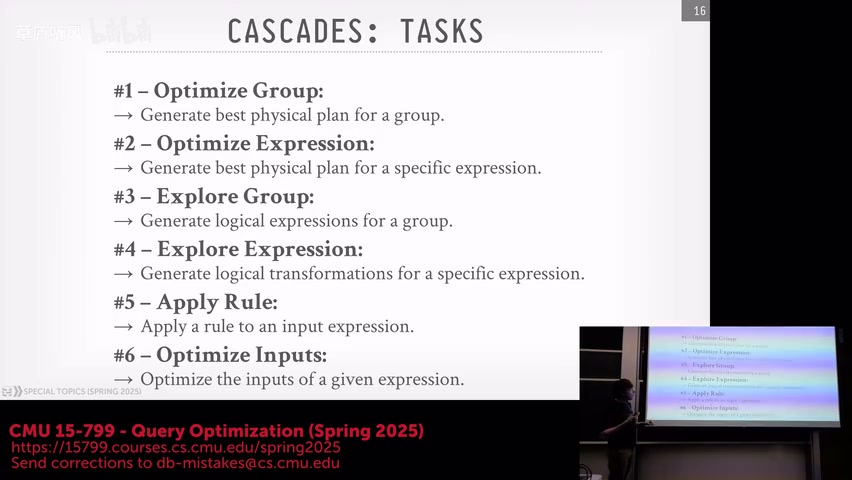
视频 35:30:Cascades 的六类搜索任务。画面将 Optimize、Explore、Apply Rule 与 Optimize Inputs 分开。先用 Optimize Group 确定当前目标,再看逻辑探索如何产生候选、输入优化如何计算完整成本。这些任务描述依赖和恢复点;它们的名称不意味着已经使用多个线程执行。
课程按六类任务解释搜索,具体实现可能采用不同名称:
| 任务 | 负责的工作 |
|---|---|
| Optimize Group | 寻找满足某种属性需求的组内最优方案 |
| Optimize Expression | 考察某个表达式的实现机会 |
| Explore Group | 安排组内逻辑候选的探索 |
| Explore Expression | 为一个表达式寻找可用变换 |
| Apply Rule | 执行规则匹配和替换 |
| Optimize Inputs | 推导输入需求并优化子 Group |
考虑 Optimize(G_ABC, ordered_by_a)。它可能为某个 Join 表达式安排规则任务,生成 Hash Join 与 Merge Join。Hash Join 候选提出无序子输入需求,并考虑输出排序;Merge Join 候选提出有序子输入需求。输入搜索完成后,任务继续计算总成本并更新根上下文的最优结果。
单线程实现可以通过后进先出任务栈安排这种顺序:把后续工作先放入栈,再放入其前置工作,使前置任务先被取出。任务对象记录恢复位置,避免把所有状态压在程序递归栈里。到后面的并行化章节,我们会显式保存依赖,允许多个 worker 同时推进。
用一个任务栈追踪 Hash Join 候选
下面按依赖顺序描述一次教学调度。实际任务类名和切分粒度由具体实现决定。
1 | 1. Optimize Group(G_AB, ordered) |
第 4 步与第 7 步属于同一个候选的前后两段工作。任务需要记录已完成的输入、子输入结果和下一次恢复位置。通过任务栈实现时,先压入后续计算,再压入需要优先处理的子输入;按后进先出顺序执行,子输入会先于汇总步骤完成。
接着若 Merge Join 分支得到总代价 45,根上下文把上界从 63 收紧为 45。尚未完成的候选可使用新上界减少工作。有序最优值更新后,无序上下文仍然可以保留成本 38 的 Hash Join;两个上下文共享 Group,却各自回答不同需求。
探索任务产生了新表达式以后,还要让相关优化任务有机会考察它。实现必须明确“已经探索过哪些规则”和“某个属性目标已经完成到哪里”。把 Group 的一次探索完成简单当作所有属性搜索永久完成,会遗漏后续规则和需求产生的工作。
Promise 决定先搜索哪里
Promise 是规则或任务在当前上下文中的搜索优先级。它帮助系统尽早找到可能有用的方案;代价模型负责比较生成的物理候选,语义条件负责判断规则是否合法。
假如某条规则容易产生索引访问,可以优先尝试它,尽早得到一个完整方案。这条路径形成较小上界后,昂贵分支更容易被剪掉。另一个逻辑变换也可能暂时增加候选复杂度,却在下一步暴露一个高收益的实现机会。
因此 Promise、合法性条件和最终代价分别回答“先做什么”“能不能做”“结果是否更好”。混在一起会使规则难以维护,也让搜索难以解释。
工程中怎样控制搜索空间
简化规则可以直接把恒真过滤等表达式归一化,不必为每个显然冗余的形式保留候选。宏规则(Macro Rule)把一组经常一起使用的变换合并,减少中间状态;其条件和作用范围也需要一起维护。
Memo 还要检测重复表达式、标记已应用规则、合并发现的等价组,并区分不同上下文的搜索完成状态。交换律若反复把 A ⋈ B 改成 B ⋈ A,再改回来,没有这些记录就会浪费搜索预算。
预算可以按时间、任务数或规则应用次数设定。预算耗尽时要返回已找到的完整可执行方案;仅有一个尚未优化完输入的候选,无法作为查询结果交给执行器。
沿一个 Group 观察搜索
阅读本讲时,可以先在纸上建立 G_A、G_B、G_AB,再加入交换规则和两种 Join 实现,观察每次规则应用增加的是表达式还是新的 Group。然后给根节点增加排序要求,记录哪些输入上下文需要重新优化。
这样更容易理解后面的 转换规则:Memo 提供容器,规则决定候选能否出现,属性与代价决定候选如何组合,任务决定何时处理这些工作。
参考资料
EQOP Book (Chapter 2) (Primary)
The Cascades Framework for Query Optimization (G. Graefe, IEEE Data Engineering Bulletin 1995) (Optional)