从提交到用户之间还有哪些步骤
一个两行的修复已经合并,用户要多久才能用到?等待可能发生在构建、测试、审批或发布的任何一步。本讲从这条路径讨论 DevOps:构建服务的团队也参与运行,再通过自动化减少交接与重复配置成本。
持续集成(CI)在变化进入共享分支时统一构建、测试并报告结果。小改动及时集成,能够尽早发现与其他修改的冲突;两个 PR 各自通过,也可能在组合后失败,因此还需要检查合并结果。
慢流水线容易促使人积累大改动。缓存依赖、并行独立任务、取消被新提交替代的运行,以及合理超时,可以缩短反馈;跳过检查的条件也需要与实际构建输入对应。
课件借 Express 的工作流读 YAML:on 决定推送或 PR 如何触发,独立 job 可以并行,needs 决定依赖,matrix 则为操作系统与 Node 版本的每个组合启动任务。能读懂这些关系,才知道某个检查是否真的阻止了后续步骤。
主干开发让小改动尽早与其他工作集成。长期分支即使每天自测,也可能直到合并才看到冲突;合并队列则检查 PR 与前面待合并修改组合后的结果。已经破坏的主干需要优先修复或回退,否则会持续阻塞后续开发。
课程还用价值流图统计“真正工作”与“等待交接”的时间:示例中约 2.4 天工作跨越约 20 天流程。这个示意帮助我们区分优化测试执行与消除等待,不能只盯着构建命令的秒数。
交付与部署有不同的停止点
持续交付意味着通过流水线后随时可以部署,由人选择时机;持续部署则让满足条件的修改自动上线。Web 服务、移动应用和依赖库的发布约束不同,不能使用同一节奏。
构建出的镜像应按提交标识,在预发布和生产之间推广同一个产物。预发布通常数据和流量更少,只能覆盖部分生产风险。
移动应用和库的调用者不能同步升级。课件以 Facebook 当年的移动发布列车说明:持续合并后,按日程切发布分支、稳定并逐步放量,修复可能需要等下一班。持续集成并不要求所有产品都采用即时发布。
对于 Web 服务,镜像按提交哈希标识,构建、预发布与生产由依赖关系连接,生产环境还可配置所需评审。同一个产物逐步推广,才能减少“测试了一个版本,实际重新构建了另一个版本”的差异。
用发布策略限制影响
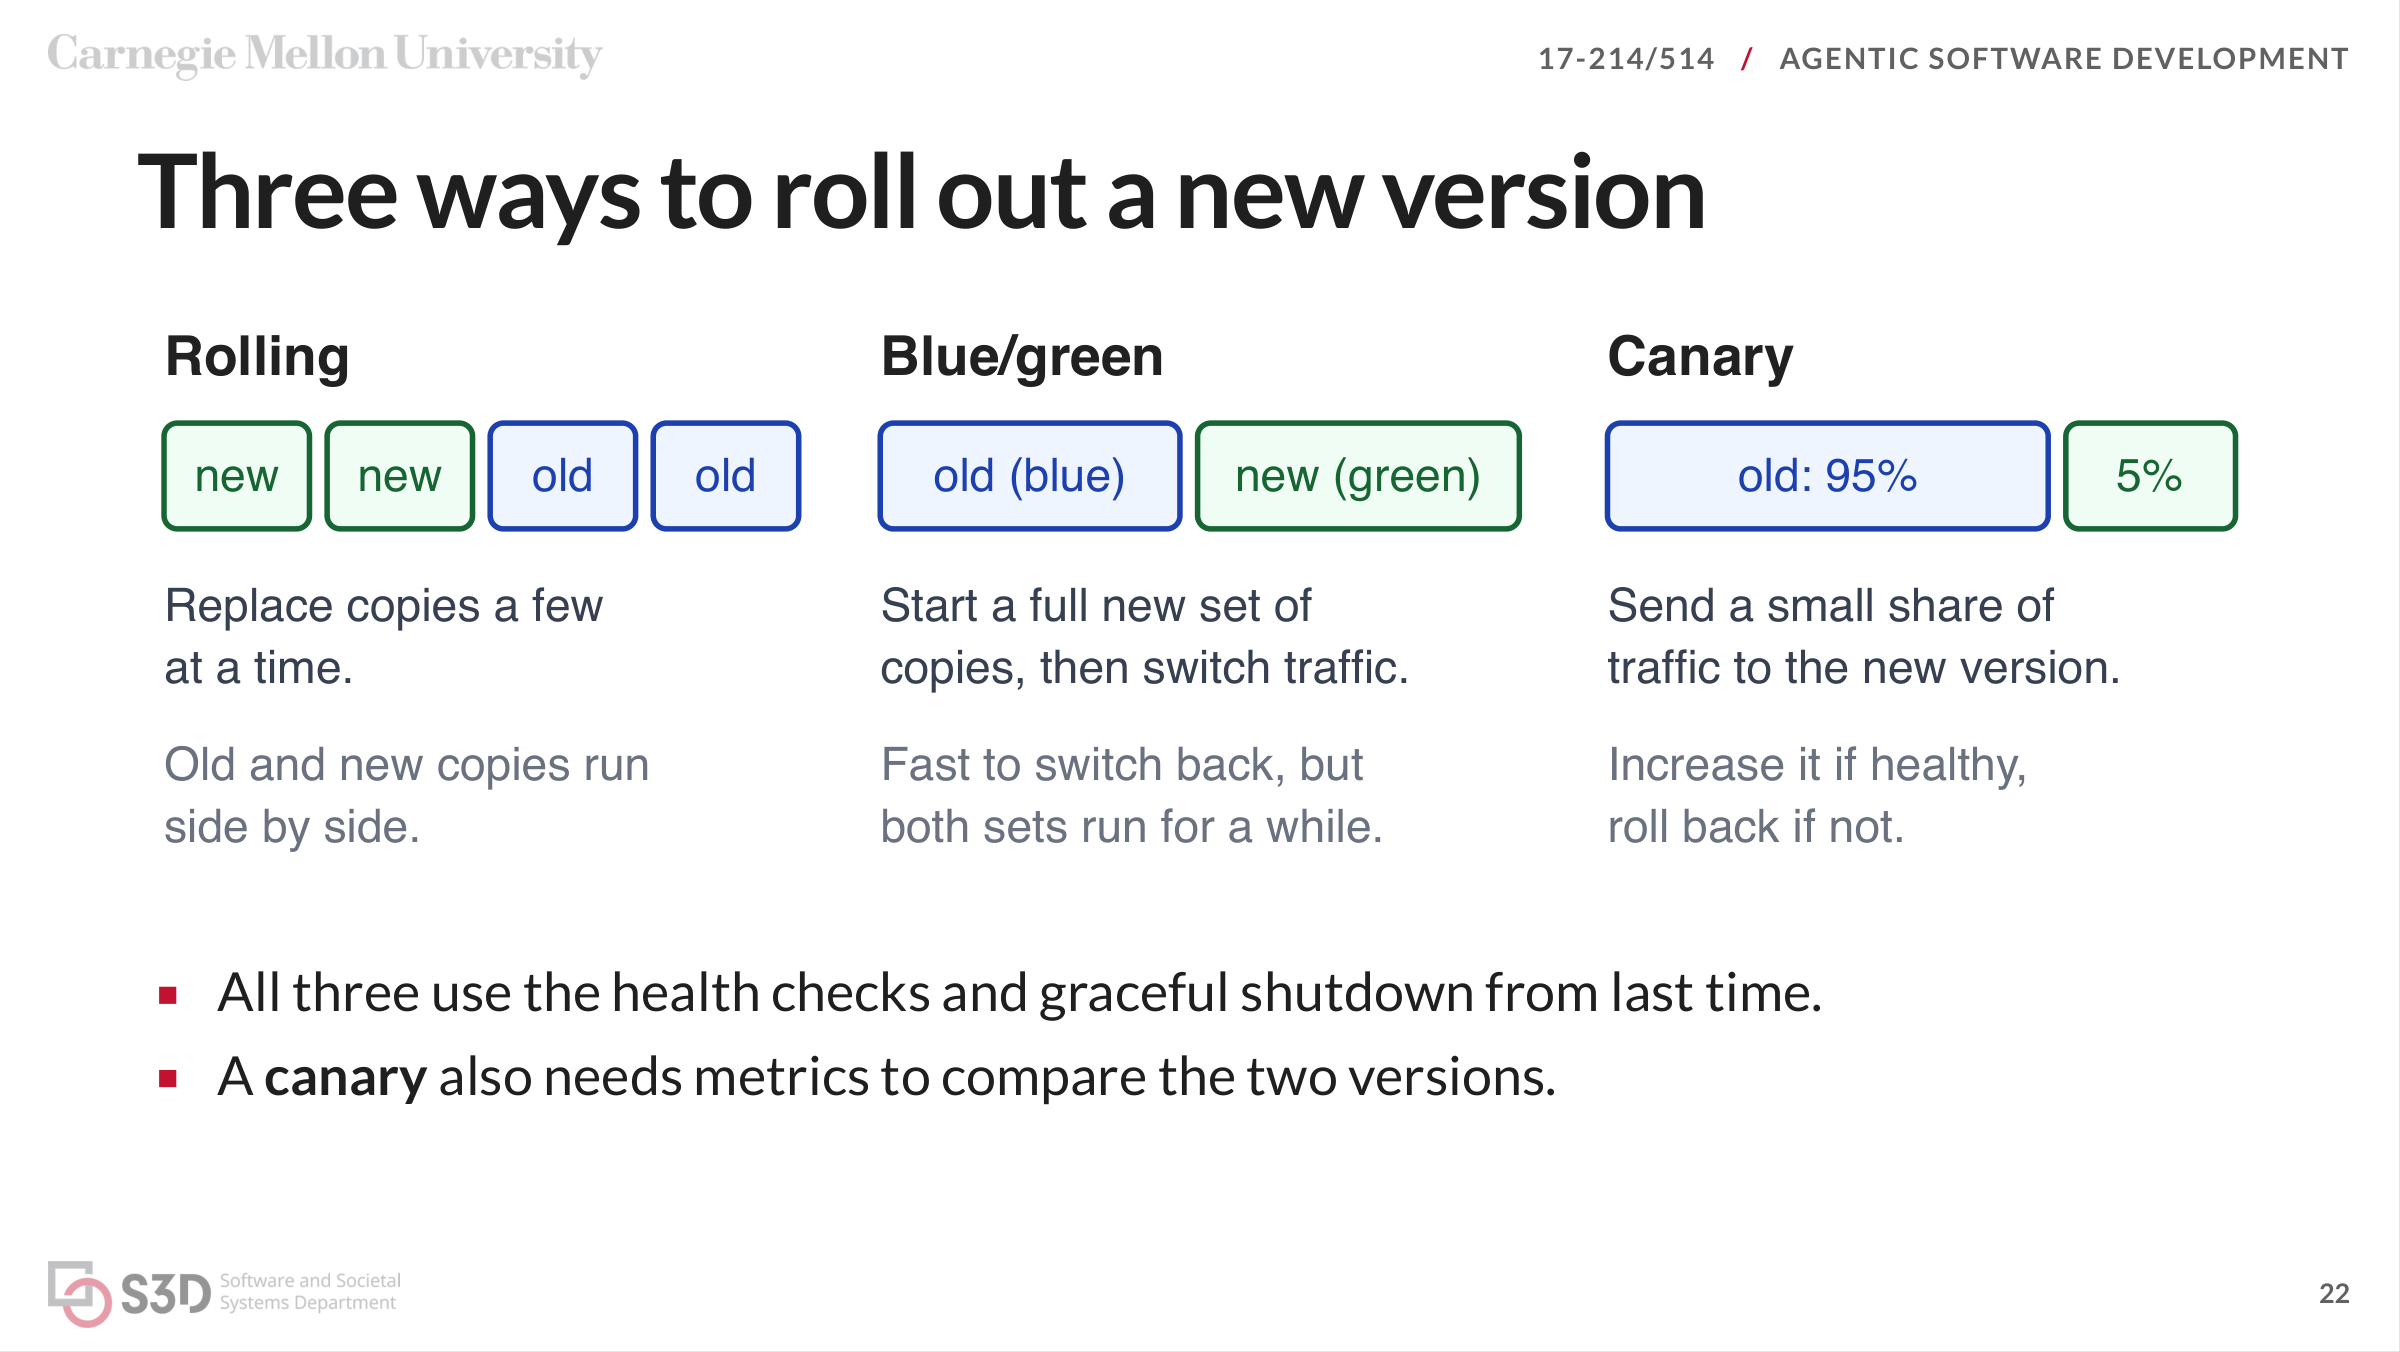
滚动发布逐批替换副本,新旧版本会并存;蓝绿发布准备完整新环境后切换,方便切回但需要额外容量;金丝雀让少量真实流量先进入新版本,再根据指标逐步扩大。
课程中的金丝雀示例先规定错误率阈值,再比较新旧版本。阈值若等到上线后临时决定,就失去了可检查的发布条件。Readiness 与优雅退出帮助控制替换过程,但不能证明业务语义正确。
回滚需要保存已知正常的产物并提前演练。数据库迁移必须考虑旧应用重新运行时的兼容性,删除旧字段往往要晚于所有可能回滚到的版本退出。
课件中的六副本滚动发布允许短暂多出两个副本,至少保持五个就绪;数字由当时配置与取整规则得到,说明可用性与额外容量要一起设定。金丝雀例子则把 5% 流量给新版本,观察到 4.1% 错误率高于预设 1% 阈值,而旧版约 0.2%,于是撤回新版本。
数据库改名无法单靠滚动、蓝绿或金丝雀保证安全。需要先增加 space_id,新旧字段共存并回填,再等所有可能回退的版本不再读取 room_id,最后移除。这里发布策略控制用户影响,迁移步骤解决数据兼容,两项工作不能互相替代。
部署代码与开放功能分开
功能开关允许代码先进入生产,再按时间或用户比例开放。稳定用户分组避免同一个人在请求间来回切换。开关存在期间,两条路径都要测试,完全开放或放弃后应移除废弃分支。
暗发布可以在真实流量旁运行新计算并比较结果;A/B 测试则比较随机分组的业务结果。二者都需要事先确定指标,并考虑用户承担的风险。关键业务的试用人群也需要有明确选择依据。
例如新价格规则可以先部署而不开启,到新学期再通过开关开放;日期邮件格式修复可以先小范围验证;重写重叠检查则需要继续检查重复预约不变量,不能只看错误率。A/B 示例中的“仅剩两个房间”比较完成预约率,指标需要提前决定并排除随机波动。
放量人群也需要业务判断。员工和自愿试用者可以先行,高影响预约用户是否纳入,要权衡风险与发现特定缺陷的能力。课件借社会网络情绪实验的争议说明,技术上能够分组,不代表所有实验都具有同样的知情与退出条件。
发布完成要确认真实版本
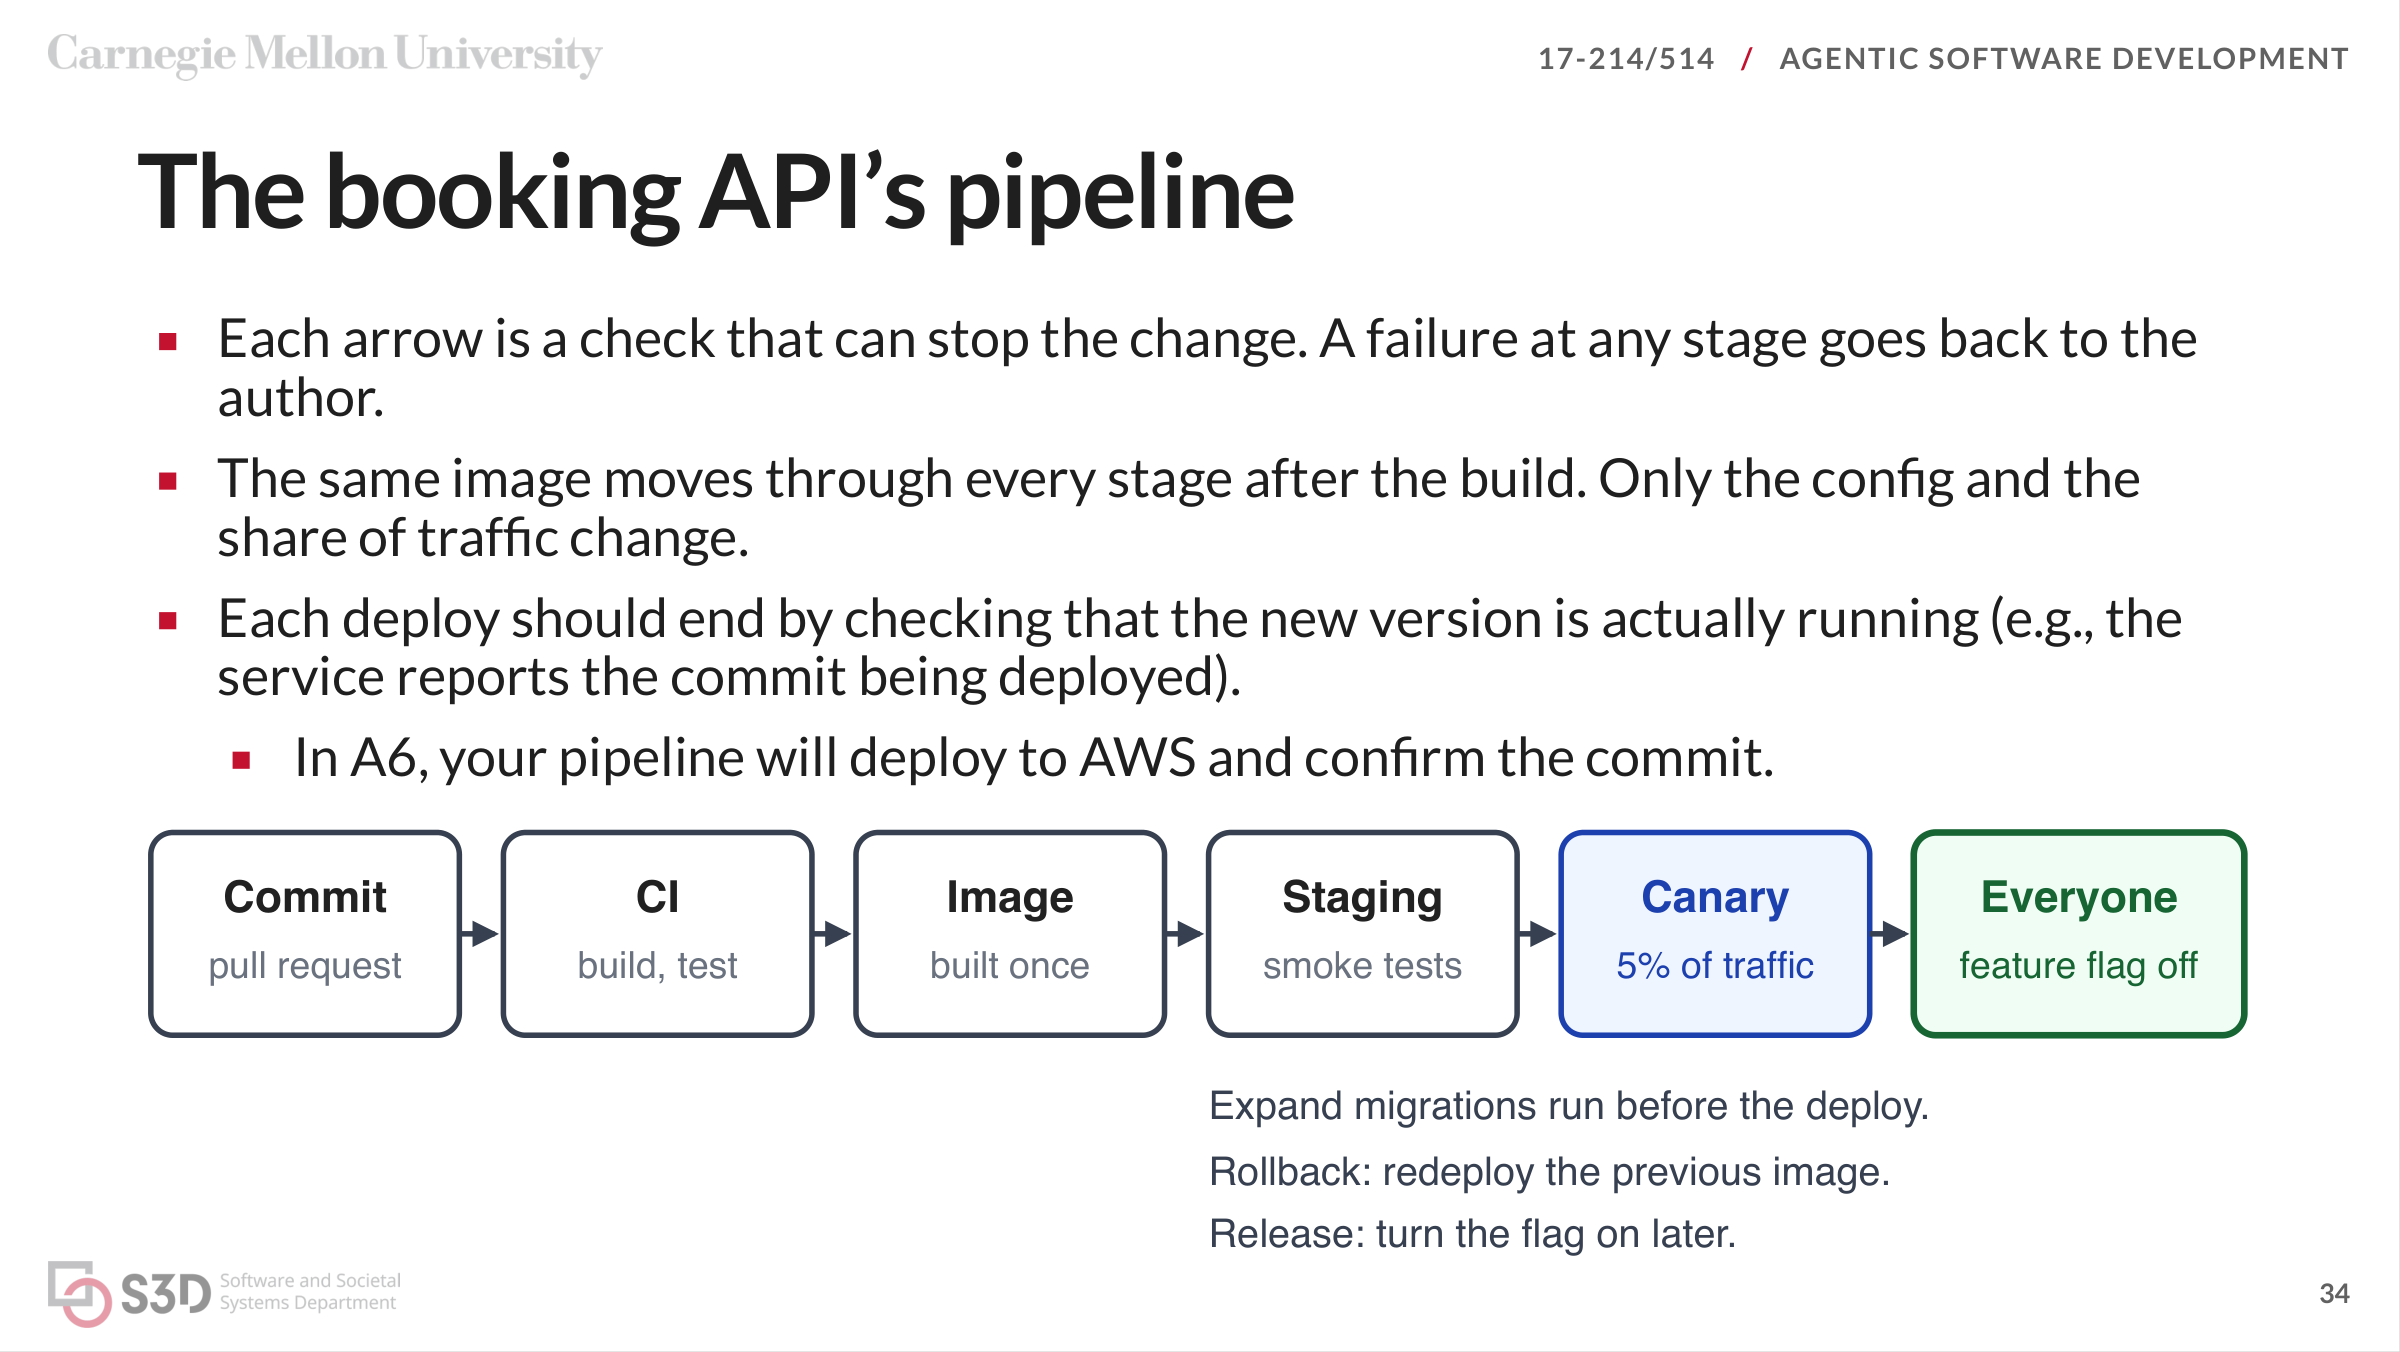
流水线不应在部署命令退出时就宣布成功,还要确认目标服务实际运行本次提交。课程借 Knight Capital 案例说明,遗漏实例、重用旧开关和未验证回滚组合起来,可能让旧代码重新被激活。
出现故障时,先限制用户影响,再定位原因。若旧版本兼容当前数据,回滚通常是快速恢复手段;不能把所有故障都简单当成可以直接回退镜像。
无责复盘关心系统为何允许问题到达用户,以及需要增加何种检查、监控或发布步骤。交付指标也需要同时观察速度与不稳定性,不能只计算部署数量。
课件还用 CrowdStrike 的更新事故说明单次全量推送的影响,用 GitLab 的数据库复盘说明备份必须可恢复。复盘后应落实能够改变系统的行动,例如分阶段发布、恢复演练或缺失检查;仅要求操作者更仔细,无法形成新的防线。
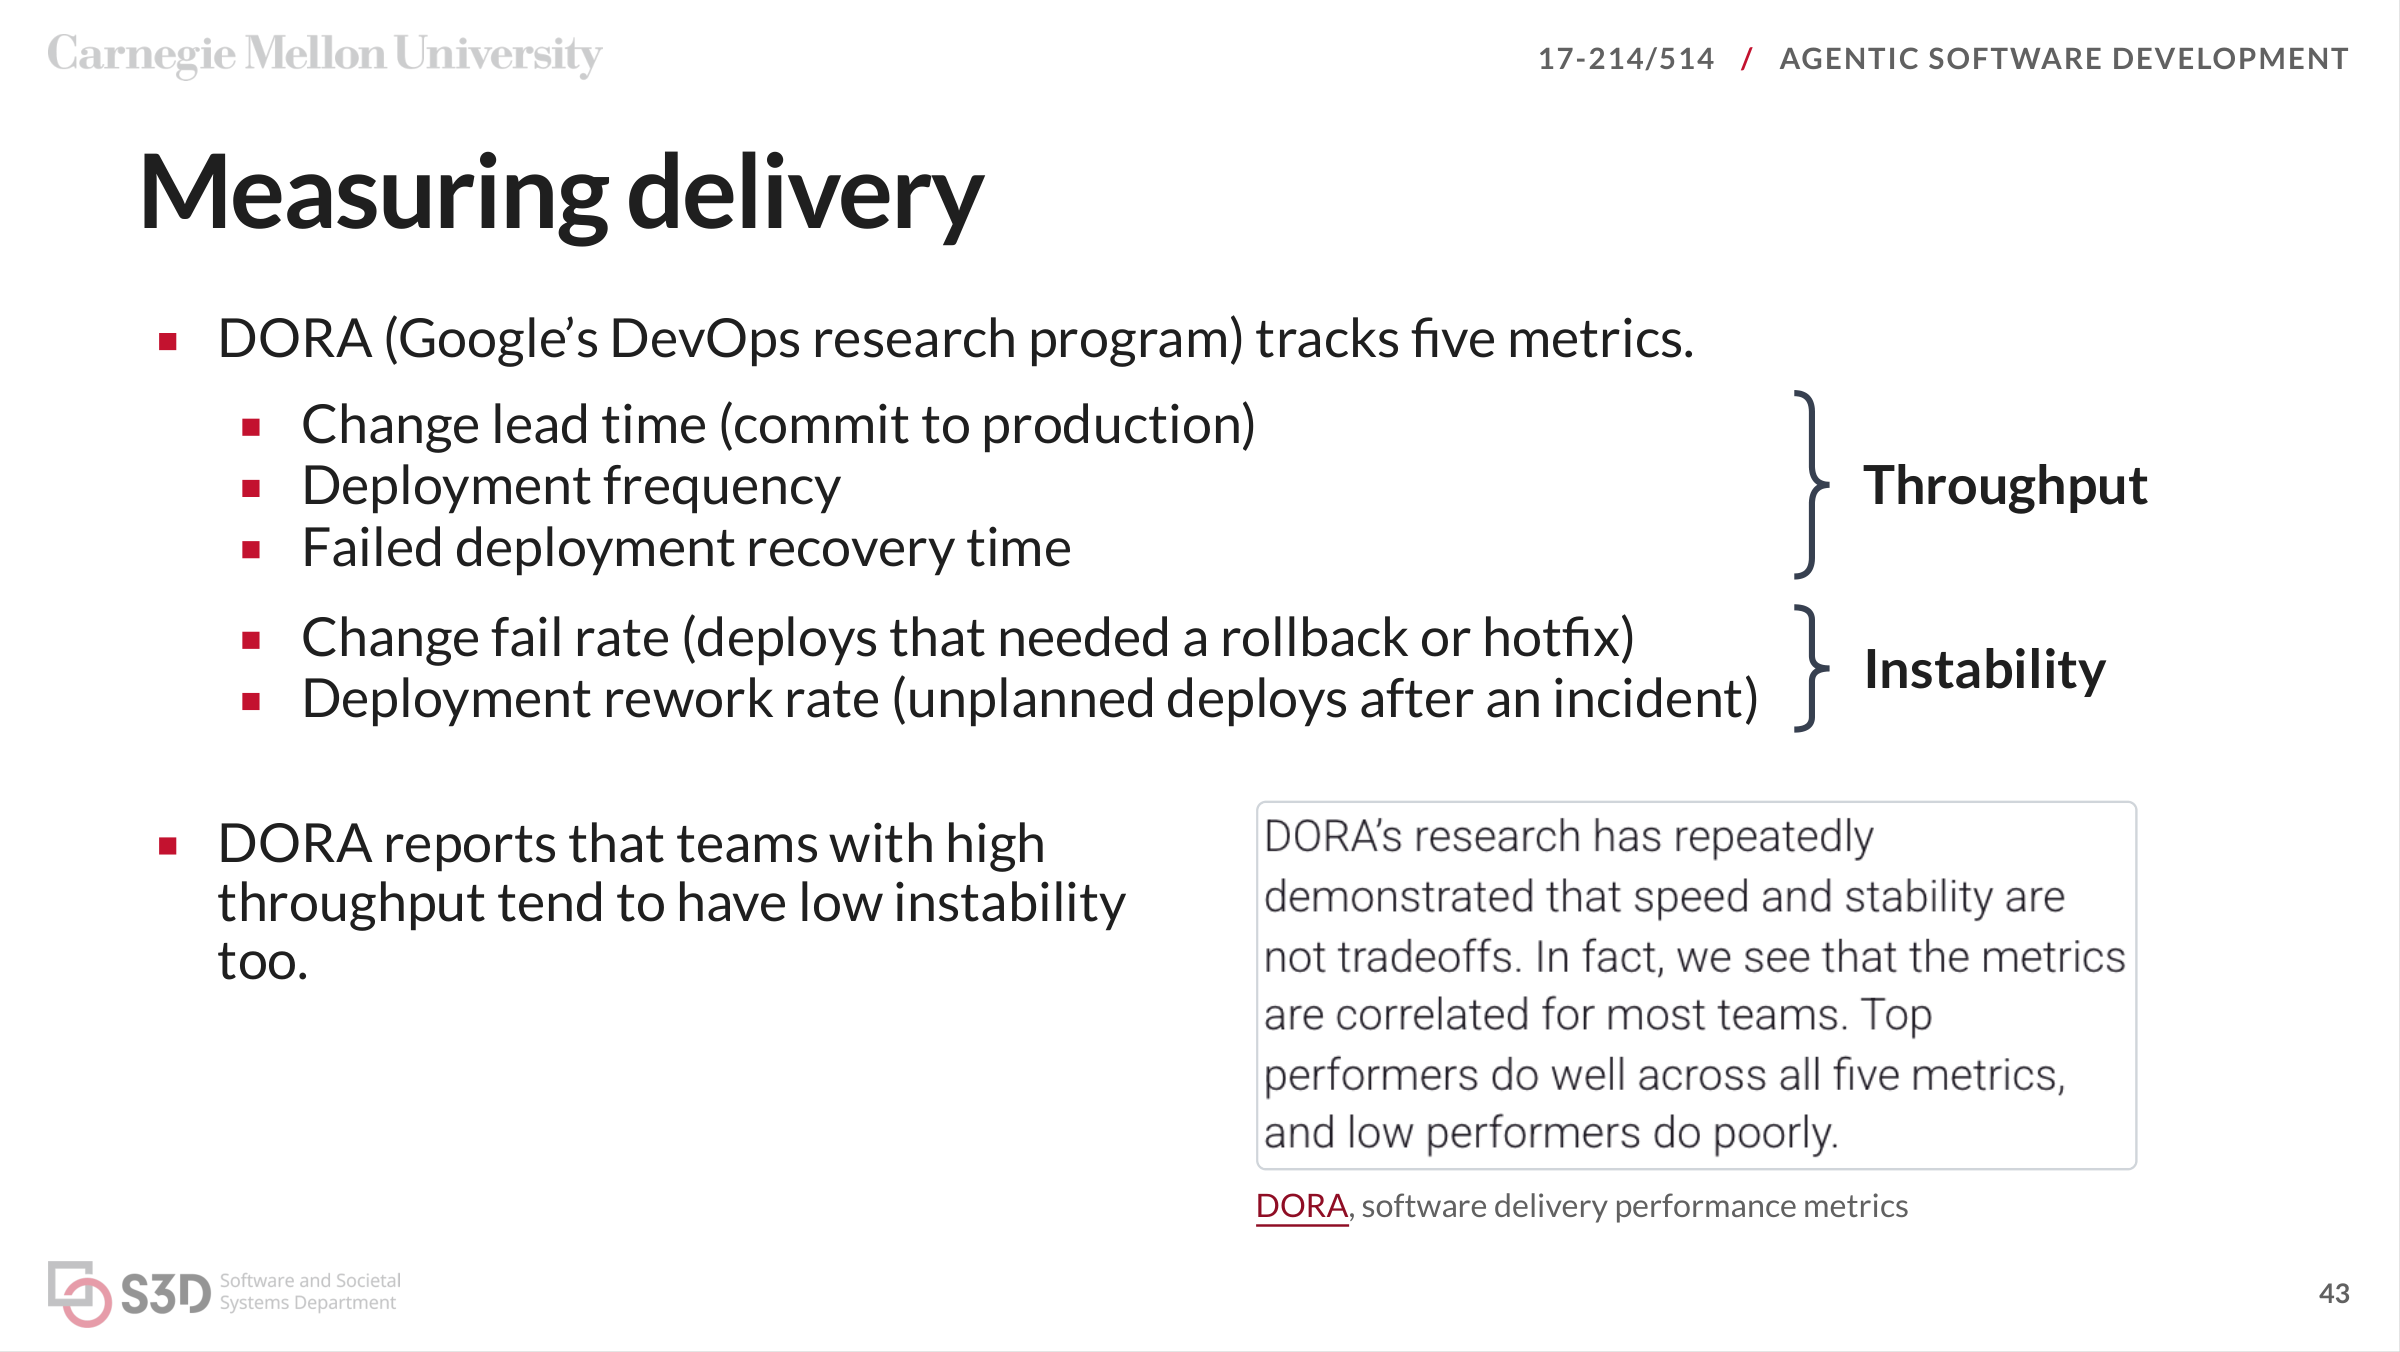
交付度量则把吞吐和不稳定性一起观察。课件采用 DORA 当时的五项指标:变更前置时间、部署频率、失败部署恢复时间,以及变更失败率、部署返工率。它们属于所引版本的口径;评估团队时,不能只用部署越多越好,也要看恢复和返工。
流水线本身需要评审
Agent 增加 PR 数量以后,自动检查可以复用,但剩余人工判断仍有成本。Agent 也可以运行在流水线中,执行审查或修改,此时工具权限来自工作流身份。
部署流水线通常拥有重要凭证。新增 Action、事件触发方式、读写 Token 和凭证保留设置,都值得检查。第三方 Action 固定到版本标签与固定到提交摘要,提供的可复现程度不同。
作业六要求流水线确认已部署的提交,并在实际流量下记录通知服务退化。这里的验收已经从“代码通过”延伸到“真实环境中的运行结果可观察”。
工作流权限还可以按职责拆开:只读代码的评审 job 输出报告,另一个具备必要权限的 job 发布反馈。新增工具不应自动继承部署凭证。审查时逐项检查 Token 能力、第三方 Action 固定提交、checkout 是否保留凭证,以及来自 fork 的输入能否接触密钥。